Bónusz · 07. Modul · 22. lecke
Aktivációs függvények — a „hajlítás", amitől a háló okos lesz
Itt derül ki, miért nem elég a puszta y = w·x + b. Egy apró trükk — az aktiváció — teszi lehetővé, hogy a háló bonyolult mintákat is megtanuljon, ne csak egyeneseket.
Van egy probléma, amit a 15. lecke még elhallgatott. Ha csak lineáris neuronokat (egyeneseket) rakunk egymásra, az eredmény… megint csak egy egyenes lesz. Egyenesekből bármennyit is pakolsz össze, sosem lesz belőle görbe. Márpedig a világ mintái (egy arc, egy mondat jelentése) nem egyenesek.
A megoldás egyszerű és zseniális: minden neuron után beiktatunk egy kis „hajlítást" — ez az aktivációs függvény. Ez viszi be a nemlinearitást, ettől tud a háló tetszőlegesen bonyolult dolgokat tanulni. Nézzük a két leggyakoribbat:
Igen, a tanh: a szigmoidhoz hasonló S-alakú görbe, csak −1 és +1 között mozog, nem 0 és 1 között. A mai nagy nyelvi modellek pedig gyakran a ReLU továbbfejlesztett rokonait használják, mint a GELU vagy a SwiGLU — ezek simábban kezelik a nulla körüli tartományt, mint a ReLU éles törése.
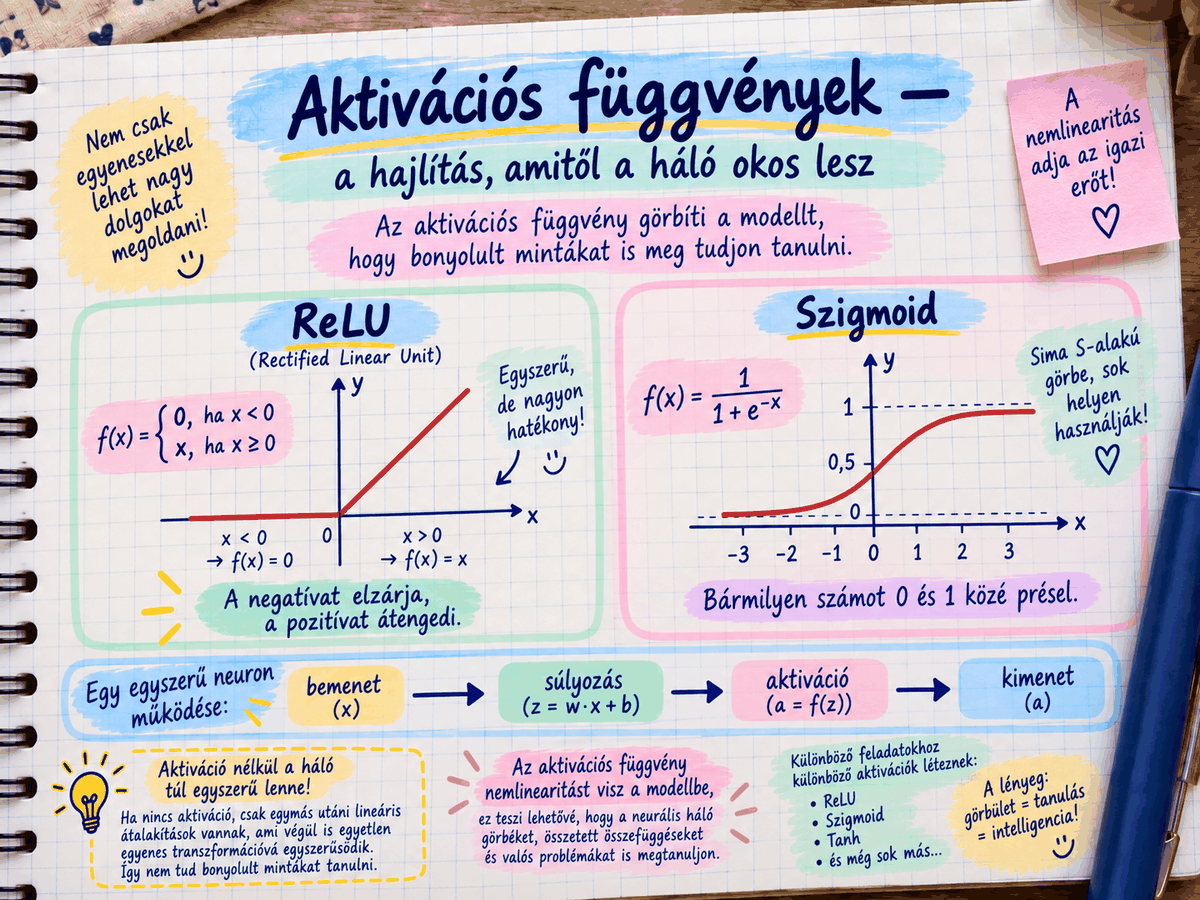
Szigmoid: bármilyen számot 0 és 1 közé nyom össze — épp ezért tökéletes, ha valószínűséget akarunk (lásd a következő leckét).
Miért pont ez a nagy áttörés? Évtizedekig a hálók „sekélyek" maradtak, mert a régi aktivációk (mint a szigmoid) mély hálókban „elnyelték" a tanulójelet. A ReLU 2010 körüli elterjedése — épp azért, mert a pozitív oldalon nem lapítja el a meredekséget — tette lehetővé a valóban mély hálókat. Egy ilyen egyszerű ötlet gyújtotta be a modern AI-t.
Kidolgozott példák
Előbb próbáld meg magad papíron, aztán nyisd le a lépésenkénti megoldást, és vesd össze a sajátoddal.
Példa 1 · Számold ki a ReLU kimenetét a [−2, 0, 3,5, −0,1] bemenetre.
−2 → 0; 0 → 0; 3,5 → 3,5; −0,1 → 0.
Eredmény: [0, 0, 3,5, 0]. ✔
Példa 2 · A szigmoid képlete σ(x) = 1 / (1 + e⁻ˣ). Mennyi σ(0), és mi történik nagy x-nél?
2. x = 10: e⁻¹⁰ ≈ 0,000045, szinte 0, így σ(10) ≈ 1 / 1,000045 ≈ 0,99995.
Nagy pozitív x-nél a kimenet közel 1, nagy negatívnál közel 0 — ezért jó a szigmoid „igen/nem" valószínűségre. ✔
A ReLU szabálya: max(0, x) — a nulla és x közül a nagyobbik. Mennyi a ReLU eredménye ezeknél: 5, −3, 0, 2,7?
Megoldás
Minden mély háló minden rejtett neuronja után ott egy aktivációs függvény (ma szinte mindig ReLU vagy annak rokona). Nélküle a „mély" háló matematikailag összeomlana egyetlen egyenessé, és semmi érdekeset nem tudna tanulni. Ez a parányi hajlítás a mélytanulás egyik alappillére.