6. lecke
Listák és szótárak
A valódi programok nem egy-két értékkel, hanem sok adattal dolgoznak. Ez a lecke a Python két legfontosabb adattárolóját mutatja be: a listát, amely sorszám (index) szerint tárolja az elemeket, és a szótárat, amely névvel ellátott kulcsokhoz rendel értékeket. Megtanulod az elemek elérését és módosítását, a rajtuk való végighaladást, és a gyakran használt „lista szótárakkal" mintát.
- Mi az a lista?
- Elemek elérése — indexelés
- Lista módosítása
- Végigmenni egy listán — for ciklussal
- Mi az a szótár (dictionary)?
- Értékek elérése a szótárban
- Szótár módosítása
- Végigmenni egy szótáron
- Lista szótárakkal — gyakori minta
- Olvasási idő: kb. 5 perc (a kódok kipróbálásával több)
- 9 rész · 25 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
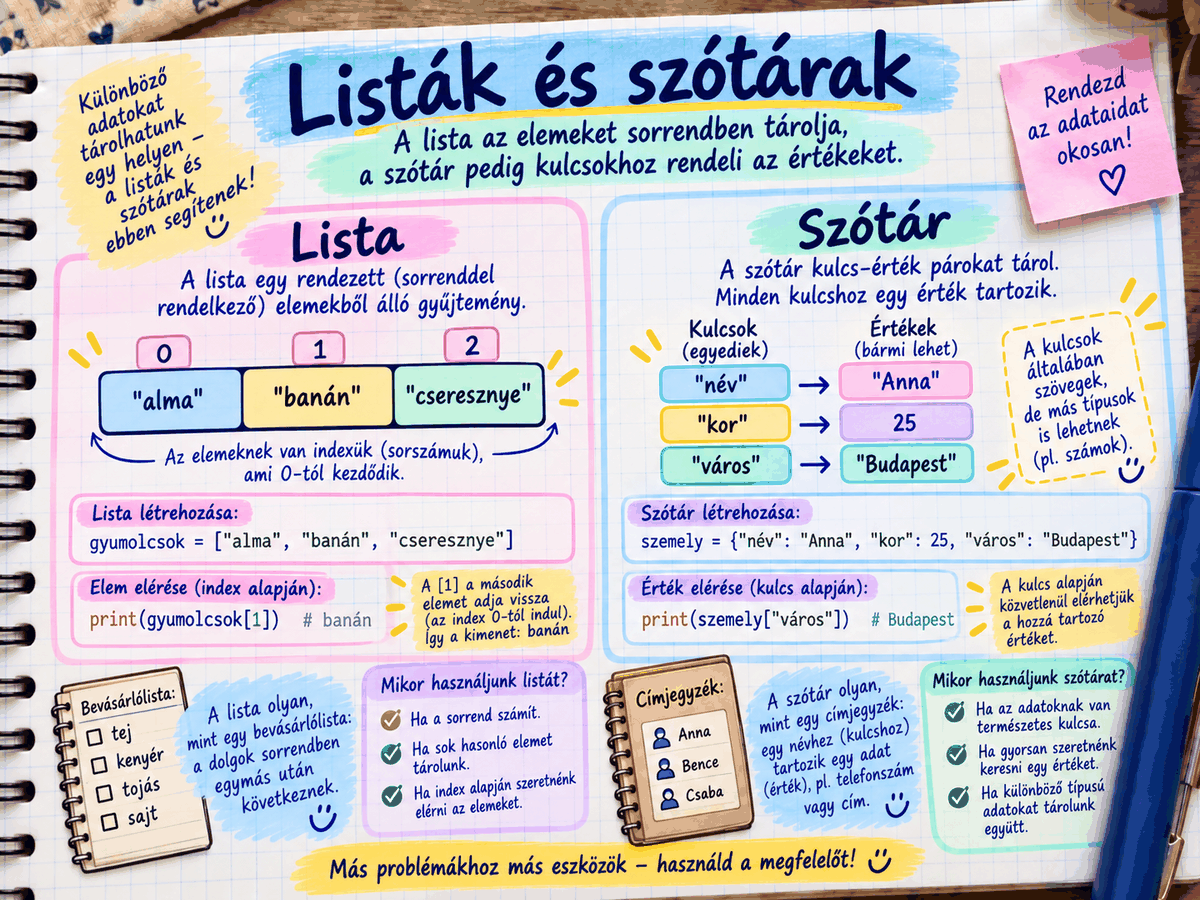
1. Mi az a lista?
nevek = ["Anna", "Béla", "Csilla"]
szamok = [10, 25, 3, 47, 8]
print(nevek)
print(szamok)
Míg egy sima változó (kor = 27) egyetlen memóriahelyre mutat, egy lista valójában egy "dobozsor" — a Python lefoglal annyi (összekapcsolt) helyet a memóriában, amennyi elem van a listában, és a "nevek" címke az egész sorozatra mutat. Fontos tudni: a lista mérete rugalmas — ha később hozzáadsz egy elemet (.append(), lásd lejjebb), a Python a háttérben szükség esetén új, nagyobb helyet foglal, és átmásolja oda a tartalmat. Ez teszi lehetővé, hogy a lista hossza menet közben változhasson, míg pl. egy sima szám vagy szöveg mérete "fix" a memóriában.
Igen, ezt hívják szeletelésnek (slicing): nevek[1:3] az 1-es és 2-es indexű elemeket adja vissza egy új listaként — a 3-as indexű már nem kerül bele, ugyanaz a "felső határ kizárt" szabály, mint a range()-nél. A nevek[:2] az elejétől, a nevek[1:] pedig egy adott ponttól a végéig szeletel.
2. Elemek elérése — indexelés
nevek = ["Anna", "Béla", "Csilla"]
print(nevek[0])   # "Anna" — az első elem
print(nevek[1])   # "Béla" — a második elem
print(nevek[2])   # "Csilla" — a harmadik elem
print(nevek[-1])  # "Csilla" — az utolsó elem
print(nevek[-2])  # "Béla" — az utolsó előtti
Miért 0-tól indul az indexelés (emlékezz az 5. leckére, ez ugyanaz az elv), és hogyan működik a negatív index? A negatív index egy kényelmi megoldás, amit a Python készítői építettek be: ahelyett, hogy ki kellene számolnod a lista pontos hosszát ahhoz, hogy elérd az utolsó elemet (pl. nevek[len(nevek) - 1]), egyszerűen írhatsz nevek[-1]-et, ami "hátulról az elsőt" jelenti. A Python belsőleg ezt úgy oldja meg, hogy ha negatív számot lát indexként, hozzáadja a lista hosszát ehhez a számhoz (pl. egy 3 elemű listánál a -1 valójában 3 + (-1) = 2-t jelent, ami pontosan az utolsó elem "normál" indexe). Ez egy tiszta programozói kényelem, nem valami "másik számolási rendszer".
3. Lista módosítása
nevek = ["Anna", "Béla", "Csilla"]
nevek.append("Dénes")        # hozzáad a lista végéhez
print(nevek) # ["Anna", "Béla", "Csilla", "Dénes"]nevek[0] = "Andrea" # felülírja az első elemet print(nevek) # ["Andrea", "Béla", "Csilla", "Dénes"]
nevek.remove("Béla")         # eltávolítja a "Béla" elemet
print(nevek) # ["Andrea", "Csilla", "Dénes"]print(len(nevek)) # 3 — a lista hossza (elemszám)
Mi a különbség a nevek.append(...) és a nevek[0] = ... között — miért néz ki másképp a két módosítás? Ez egy fontos, finom különbség: a nevek[0] = "Andrea" egy már létező helyet ír felül (ott, ahol eddig "Anna" volt) — ez olyan, mintha kicserélnéd egy már meglévő doboz tartalmát. A nevek.append("Dénes") viszont egy metódus hívás (a pont utáni rész egy, a listához "tartozó" függvény, amit majd részletesebben az objektum-orientált programozásnál tanulhatsz meg, de egyelőre elég annyit tudni: ez egy beépített képessége minden listának) — ez egy teljesen új helyet hoz létre a lista végén, és oda teszi az új elemet, megnövelve a lista méretét. A .remove() hasonlóan egy metódus, ami megkeresi a megadott értéket a listában, és ha megtalálja, eltávolítja azt, majd "összecsúsztatja" a mögötte lévő elemeket, hogy ne maradjon "lyuk" a listában.
Mit csinál pontosan a len()? A len() egy beépített függvény (nem csak listákra, hanem szövegekre, szótárakra is működik), ami megszámolja, hány elem van a megadott dologban. Listánál ez az elemek száma, szövegnél a karakterek száma. Ez azért hasznos, mert a lista mérete (mint fentebb írtuk) dinamikusan változhat, így nem tudhatod előre, fixen "beégetve" a kódba, hány elem lesz benne — a len() mindig a jelenlegi, aktuális méretet adja vissza.
Erre való az in kulcsszó: "Anna" in nevek egyetlen lépésben megadja, hogy True vagy False — tehát benne van-e az elem a listában. Szótárnál ugyanez a kulcsokra vonatkozik: "kor" in szemely.
4. Végigmenni egy listán — for ciklussal
gyumolcsok = ["alma", "banán", "körte"]
for gyumolcs in gyumolcsok:
    print("Gyümölcs:", gyumolcs)
5. Mi az a szótár (dictionary)?
szemely = {
    "nev": "Norbi",
    "kor": 27,
    "varos": "Veszprém"
}print(szemely)
Miért van szükség szótárra, ha már van listánk? Mi a valódi különbség? Ez egy kulcsfontosságú különbség: egy listában az elemek sorrendje (pozíciója) hordozza a jelentést — a nevek[0] azért érthető, mert tudod, hogy az "első" elem a lista elején van. Egy szótárban viszont nincs "sorrend alapú" jelentés — helyette minden értékhez egy saját, egyedi kulcsot (nevet) rendelünk, és ezen a néven keresztül érjük el. Ez akkor előnyös, amikor az adatok különböző típusú, nevesített tulajdonságokat írnak le (mint egy személy neve, kora, városa) — sokkal olvashatóbb és biztonságosabb szemely["kor"]-t írni, mint szemely[1]-et, ahol el kellene emlékezned, hogy pontosan a második pozíción van a kor.
A háttérben a szótár egy speciális adatszerkezetet (hash táblát) használ, ami azt jelenti, hogy egy adott kulcshoz tartozó érték megtalálása rendkívül gyors, akkor is, ha a szótárban emberileg belegondolva rengeteg kulcs-érték pár van — nem kell "végigkeresgélnie" az összeset, hanem szinte azonnal "tudja", hol keresse.
6. Értékek elérése a szótárban
szemely = {
    "nev": "Norbi",
    "kor": 27,
    "varos": "Veszprém"
}print(szemely["nev"]) # "Norbi" print(szemely["kor"]) # 27 print(szemely["varos"]) # "Veszprém"
Jó megfigyelés — a Python tudatosan ugyanazt a jelölésmódot (szögletes zárójel) használja listáknál és szótáraknál is, mert a mögöttes gondolat hasonló: "add meg, mi alapján keressem meg az elemet." listánál ez egy szám (pozíció), szótárnál egy kulcs (szöveg vagy más érték) — de a Python "filozófiája" szerint mindkettő egyfajta "elérési módnak" számít, ezért kapják ugyanazt a szintaxist.
Igen, a .get() metódus erre való: szemely.get("telefonszam") hibaüzenet helyett egyszerűen None-t ad vissza, ha a kulcs nem létezik — vagy megadhatsz egy alapértelmezett értéket is: szemely.get("telefonszam", "nincs megadva").
7. Szótár módosítása
szemely = {
    "nev": "Norbi",
    "kor": 27
}szemely["kor"] = 28 # meglévő érték módosítása print(szemely)
szemely["varos"] = "Veszprém"    # új kulcs-érték pár hozzáadása
print(szemely)
del szemely["kor"]               # kulcs-érték pár törlése
print(szemely)
Honnan tudja a Python, hogy a szemely['varos'] = ... egy új kulcsot hoz létre, míg a szemely['kor'] = 28 egy meglévőt módosít — nem ugyanaz a szintaxis? A Python egyszerű szabályt követ: megnézi, létezik-e már az adott kulcs a szótárban. Ha igen, felülírja az ahhoz tartozó értéket (ez történt a "kor"-nál). Ha nem létezik még, létrehoz egy vadonatúj kulcs-érték párt (ez történt a "varos"-nál). Ez egy tudatos kényelmi döntés — nem kell két külön parancsot ismerned "módosításra" és "létrehozásra", a Python automatikusan eldönti, melyikre van szükség.
8. Végigmenni egy szótáron
szemely = {
    "nev": "Norbi",
    "kor": 27,
    "varos": "Veszprém"
}for kulcs in szemely:
print(kulcs, ":", szemely[kulcs])for kulcs, ertek in szemely.items():
print(kulcs, "->", ertek)Mit csinál pontosan az .items(), és miért kell két változó (kulcs, ertek) a for után? Az .items() egy metódus, ami a szótár minden egyes kulcs-érték párját egy párosított formában adja vissza (a szakmában ezt "tuple"-nek, magyarul "rendezett párnak" hívják). Amikor azt írod: for kulcs, ertek in szemely.items():, a Python minden körben szétbontja ezt a párost — a párosítás első eleme a "kulcs" változóba, a második eleme az "ertek" változóba kerül. Ez egy elterjedt Python-mintázat, amit "szétcsomagolásnak" (unpacking) hívnak — a lényeg, hogy egyetlen sorban, kényelmesen hozzáférhetsz mindkét adathoz egyszerre, külön-külön kezelve azokat.
9. Lista szótárakkal — gyakori minta
emberek = [
    {"nev": "Anna", "kor": 25},
    {"nev": "Béla", "kor": 30},
    {"nev": "Csilla", "kor": 22}
]for ember in emberek:
print(ember["nev"], "-", ember["kor"], "éves")Miért pont ez a kombináció (lista + szótárak) olyan gyakori — mi teszi ezt különlegessé? Ez a mintázat pontosan azt a struktúrát tükrözi, ahogy a valós világ adatai gyakran néznek ki: egy táblázat (pl. Excel-tábla, vagy egy adatbázis-tábla), ahol minden sor egy "dolgot" (pl. egy embert, egy terméket, egy megrendelést) ír le, és minden sornak ugyanazok a nevesített tulajdonságai (oszlopai) vannak. A "lista" itt a táblázat egészét jelenti (az összes sort), a "szótár" pedig egy-egy sort (egy konkrét ember adatait). Ez a minta olyan gyakran előfordul, hogy amikor majd a Pandas-t tanuljuk (11. lecke), rá fogsz jönni: a Pandas "DataFrame" nevű adatszerkezete valójában ugyanezt a gondolatot valósítja meg, csak sokkal kényelmesebb, kifinomultabb eszközökkel.
- Hozz létre egy listát a kedvenc ételeidből (legalább 4 elemmel), majd írasd ki for ciklussal mindegyiket.
- Hozz létre egy szótárat, ami egy autó adatait tárolja (márka, típus, évjárat), és írasd ki mindhármat.
- Hozz létre egy listát 3 szótárral, ami 3 különböző autó adatait tartalmazza, majd for ciklussal írasd ki mindegyiket egy szép mondatba foglalva.
- Új gyakorlat: próbálj meg elérni egy olyan kulcsot a szemely szótárban, ami nem létezik (pl. print(szemely["telefonszam"])) — nézd meg pontosan, milyen hibaüzenetet kapsz, és gondold át, miért pont ilyen hibát ad (összevetve azzal, mi történne egy listánál, ha egy nem létező indexet kérnél le).