Bónusz · 07. Modul · 24. lecke · a nagy összekötés
PyTorch a gyakorlatban — az első tanuló neuron
Most minden összeér: kódban látod, ahogy egy neuron a semmiből, puszta példákból megtanul egy szabályt. Ez a híd a matek-tudástár és az AI-kurzus Python/PyTorch leckéi között.
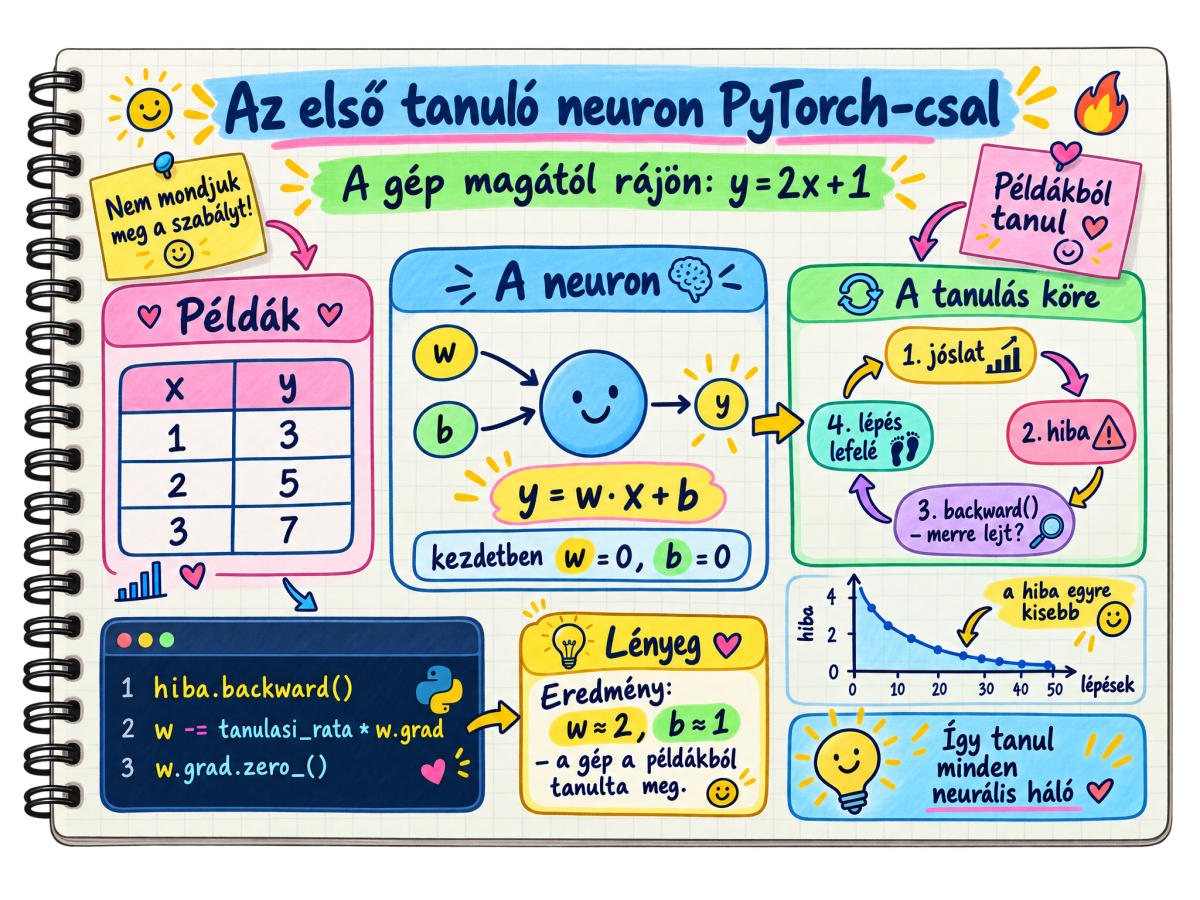
Építsünk egy pici programot, ami megtanulja az y = 2x + 1 szabályt — de a „2"-t és az „1"-et nem áruljuk el neki, csak példákat adunk. A gépnek magának kell rájönnie, pontosan úgy, ahogy a 18. leckében a labda legurul a hibavölgybe.
Nézd meg a kódot — a megjegyzések (széljegyzet-stílusban) minden sort visszakötnek egy-egy leckéhez:
import torch

# ADAT — a rejtett szabály, amit a gépnek ki kell találnia: y = 2x + 1
# Csak a példákat adjuk oda; a "2"-t és az "1"-et NEM!
x = torch.tensor([1., 2., 3., 4., 5.])
y = torch.tensor([3., 5., 7., 9., 11.])      # = 2*x + 1

# A KÉT ISMERETLEN (15. lecke: y = w*x + b), 0-ról indulva.
# requires_grad=True → "erre figyeld a meredekséget" (18. lecke)
w = torch.tensor(0.0, requires_grad=True)
b = torch.tensor(0.0, requires_grad=True)

tanulasi_rata = 0.01     # 18. lecke: mekkorát lépjünk a lejtőn

# TANULÁS: gradiens-ereszkedés — ezt ismételjük sokszor
for lepes in range(1000):
    y_becsult = w * x + b                  # 15. lecke: a neuron tippel
    hiba = ((y_becsult - y) ** 2).mean()   # 11+13. lecke: négyzetes hiba (MSE)

    hiba.backward()                        # 18. lecke: derivált = "merre lejt?"

    with torch.no_grad():
        w -= tanulasi_rata * w.grad        # 6. lecke: a lejtővel LEFELÉ lépünk
        b -= tanulasi_rata * b.grad
        w.grad.zero_()                     # nullázzuk a következő körre
        b.grad.zero_()

    if lepes % 100 == 0:
        print(f"{lepes}. lepes | hiba: {hiba.item():.4f} | w={w.item():.3f}, b={b.item():.3f}")

print(f"\nMegtanult szabaly: y = {w.item():.2f} * x + {b.item():.2f}")
Mert e nélkül a PyTorch az updatelést (a w -= ... sort) is bele akarná számítani a következő derivált-számításba, ami hibás gráfot és felesleges memóriahasználatot okozna. A no_grad() blokk annyit mond a gépnek: „ezt csak végezd el, ne kövesd hozzá a deriváltat" — ez az egyik leggyakoribb hibaforrás PyTorch-kezdőknél.
Ha lefuttatod, ezt látod: a w lassan a 2 felé kúszik, a b az 1 felé, a hiba pedig szinte nullára csökken. A gép senkitől nem kapta meg a megoldást — kizárólag a példákból, a hibáját mérve és a lejtőn lefelé lépegetve találta ki a szabályt.
Ez a négy sor a ciklus magjában — tippelj, mérd a hibát, számold a meredekséget, lépj lefelé — szó szerint ugyanaz, amit a legnagyobb modellek is csinálnak. A különbség csak a méret: ott nem 2, hanem sok milliárd ismeretlen (w és b) hangolódik egyszerre, és nem 5, hanem több milliárd példán. De a matek, amit most már értesz, ugyanez.
Mentsd el ezt a kódot egy .py fájlba — felteheted a saját GitHub-repódba is (pl. ai-tanulas) —, és VS Code-ban futtasd le (előbb: pip install torch). Innen már otthonosan mozogsz majd az AI-kurzus Python/PyTorch leckéiben — minden képlet, amivel ott találkozol, ebből a tudástárból köszön vissza. Ez a matek volt az egész AI alapja — és most már a tiéd.
24 lecke, a szorzótáblától a tanuló neuronig. Innen az AI-kurzusban folytathatod: konvolúció, transformer-alapok, több-neuronos hálók PyTorch-csal.
1. Írd át a példákat úgy, hogy a szabály y = 3x − 2 legyen. Megtalálja a gép a 3-at és a −2-t?
2. Növeld tízszeresére a tanulási rátát. Mi történik a hibával — gyorsabban csökken, vagy „szétszáll"?
3. Felezd meg a tanítási körök számát. Mennyire lesz pontatlanabb a végeredmény?