37. lecke
Nagy záróprojekt: Minőségosztályozó rendszer
Általános, tetszőleges területre alkalmazható példa
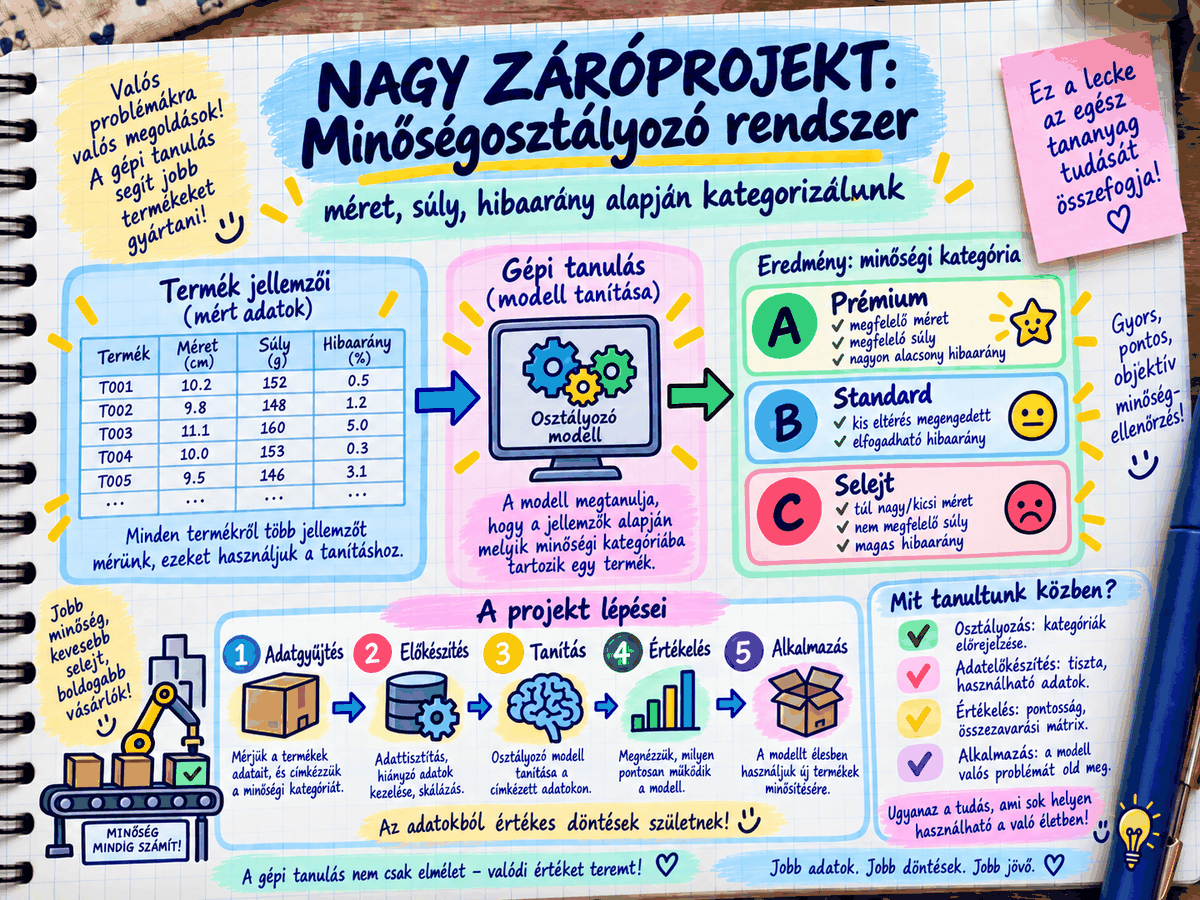
Ez a záróprojekt nem új témát tanít, hanem összefűzi az egész kurzust. Egy olyan rendszert építesz végig, amely termékeket mért tulajdonságaik alapján minőségi kategóriákba sorol: adat-előkészítés, sztenderdizálás, adatfelosztás, osztályozó modell, hiperparaméter-választás, végső kiértékelés, éles becsomagolás, végül jogi és etikai szempontok. Minden lépésnél látod, melyik leckére épül.
- Adat előkészítése (emlékeztető a 15, 22. leckére)
- Train/val/test felosztás (emlékeztető a 20. leckére)
- Standardizálás a tanító adat alapján (emlékeztető a 22. leckére)
- Egyszerű osztályozó modell (emlékeztető a 14b lecke k-NN algoritmusára —…
- Hiperparaméter-választás a validációs adaton (emlékeztető a 20. leckére: miért…
- Végső kiértékelés a teszt adaton (emlékeztető a 24. leckére: confusion matrix,…
- "éles" becsomagolás (emlékeztető a 25. lecke MLOps elveire — illusztratív, nem…
- Jogi/etikai megjegyzés (emlékeztető a 27. leckére)
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 9 rész · 28 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Ez a lecke nem egy új témát tanít — hanem az összes korábbi lecke (1–28.) tudását egyetlen, valósághoz közeli projektbe fűzi össze.
Feladat: építsünk egy rendszert, ami mért tulajdonságok (méret, súly, hibaarány) alapján 3 minőségi kategóriába sorol be egy terméket:
- "A osztály" (jó méret, jó súly, alacsony hibaarány)
- "B osztály" (elfogadható, de nem tökéletes)
- "selejt" (túl sok hiba/eltérés)
Ez a záróprojekt szándékosan egy olyan, általános területet választ (minőségellenőrzés mért adatok alapján), ami bármilyen iparágra/helyzetre átültethető — lehet szó gyümölcsről, alkatrészről, termékről, vagy bármi másról, amit számokkal le lehet írni és kategóriákba lehet sorolni — a cél, hogy a példa magától értetődő legyen, függetlenül attól, ki olvassa, és milyen területen dolgozik. A lényeg nem a konkrét téma, hanem a folyamat (pipeline), amit bemutat — ez a folyamat ugyanúgy működne bármilyen más osztályozási feladatra.
Végigjárt lépések (mindegyik egy-egy korábbi leckére épül)
- Adat előkészítése -> 15, 22. lecke
- Jellemzők (feature-ök) kinyerése -> 00b, 22. lecke
- Train/val/test felosztás -> 20. lecke
- Modell felépítése (osztályozó) -> 14, 21. lecke
- Tanítás + túltanulás elleni védekezés -> 14, 20. lecke
- Kiértékelés (precision/recall/F1) -> 24. lecke
- "Éles" becsomagolás (MLOps-szerűen) -> 25. lecke
- Jogi/etikai megjegyzések -> 27. lecke
Fontos: ez egy oktatási, leegyszerűsített példa, kis, mesterségesen létrehozott adathalmazzal — a cél nem az, hogy "éles rendszerként" használd, hanem hogy lásd, hogyan áll össze a teljes folyamat elejétől végéig, egyetlen fájlban.
import numpy as np
Lépés 1 — Adat előkészítése (emlékeztető a 15, 22. leckére)
Valós projektben itt nyers mérési adatokat (pl. egy érzékelő vagy egy kamera által rögzített értékeket) kellene összegyűjteni és rendszerezni — ez a záróprojekt egyszerűsít: feltesszük, hogy már kinyertünk 3 egyszerű, számszerű "jellemzőt" (feature-t) minden termékből (emlékeztető a 00b lecke vektor fogalmára — minden termék egy vektorrá alakul):
- meret_cm: a termék mérete centiméterben
- suly_g: a termék súlya grammban
- hiba_pontszam: hány apró hibát/eltérést észleltünk rajta (0 = tökéletes, minél magasabb, annál rosszabb)
Ez a fajta "kézi jellemző-kinyerés" egy egyszerűbb, általános megközelítés (mielőtt pl. egy képet embedding-gé alakítottunk volna — 17. lecke) — de oktatási célra tökéletesen mutatja a folyamat lényegét, és bármilyen mérhető termékre/jelenségre átültethető.
Mesterséges példaadat: 30 "termék" jellemzői + a valós kategória (0 = B osztály, 1 = A osztály, 2 = selejt)
np.random.seed(42) # EMLÉKEZTETŐ: EZ BIZTOSÍTJA, hogy MINDIG
Ugyanazt a "véletlen" adatot kapjuk — fontos a reprodukálhatósághoz (25. lecke)!
A osztályú termékek (ideális méret, ideális súly, kevés hiba):
a_osztaly = np.column_stack([
    np.random.uniform(8.0, 10.0, 10),   # méret: 8-10 cm
    np.random.uniform(180, 220, 10),    # súly: 180-220 g
    np.random.randint(0, 2, 10),        # hibapontszám: 0-1
])
a_osztaly_cimke = np.ones(10)  # kategória: 1 (A osztály)
B osztályú termékek (elfogadható, de kisebb/nagyobb eltérés, közepes hibaszám):
b_osztaly = np.column_stack([
    np.random.uniform(6.5, 11.0, 10),   # méret: kissé szélesebb tartomány
    np.random.uniform(150, 250, 10),    # súly: kissé szélesebb tartomány
    np.random.randint(2, 4, 10),        # hibapontszám: 2-3
])
b_osztaly_cimke = np.zeros(10)  # kategória: 0 (B osztály)
Selejt termékek (nagyon eltérő méret/súly, vagy sok hiba):
selejt = np.column_stack([
    np.random.uniform(3.0, 15.0, 10),   # méret: nagyon szélsőséges
    np.random.uniform(80, 320, 10),     # súly: nagyon szélsőséges
    np.random.randint(4, 8, 10),        # hibapontszám: 4-7 (!)
])
selejt_cimke = np.full(10, 2)  # kategória: 2 (selejt)
Összefűzés egy adathalmazzá (emlékeztető a 15. lecke pandas-os megközelítésére — itt NumPy-val egyszerűsítve):
X = np.vstack([a_osztaly, b_osztaly, selejt])       # jellemzők (30 x 3 mátrix)
y = np.concatenate([a_osztaly_cimke, b_osztaly_cimke, selejt_cimke])  # címkék (30,)
print("LÉPÉS 1 — Adat előkészítve.")
print(f"Adathalmaz alakja: X={X.shape} (30 termék, 3 jellemző), y={y.shape}")
print(f"Egy példa 'A osztály' termék jellemzői: {X[0].round(1)} -> kategória: {int(y[0])}")
print(f"Egy példa 'selejt' termék jellemzői: {X[-1].round(1)} -> kategória: {int(y[-1])}")
print()
Lépés 2 — Train/val/test felosztás (emlékeztető a 20. leckére)
Emlékeztető a 20. lecke fő tanulságára: soha ne értékeld a modellt ugyanazon az adaton, amin tanítottad — ezért három részre osztjuk az adatot.
Először összekeverjük a sorrendet (hogy ne legyen "csoportosítva" a 3 kategória szerint egymás után):
indexek = np.random.permutation(len(X))
X_kevert = X[indexek]
y_kevert = y[indexek]
60% tanító, 20% validációs, 20% teszt (Emlékeztető a 20. lecke arányaira):
n = len(X_kevert)
n_train = int(n * 0.6)
n_val = int(n * 0.2)
X_train, y_train = X_kevert[:n_train], y_kevert[:n_train]
X_val, y_val = X_kevert[n_train:n_train+n_val], y_kevert[n_train:n_train+n_val]
X_test, y_test = X_kevert[n_train+n_val:], y_kevert[n_train+n_val:]
print("LÉPÉS 2 — Train/val/test felosztás kész (20. lecke módszerével).")
print(f"Tanító adat mérete: {len(X_train)}")
print(f"Validációs adat mérete: {len(X_val)}")
print(f"Teszt adat mérete: {len(X_test)}")
print()
Lépés 3 — Standardizálás a tanító adat alapján (emlékeztető a 22. leckére)
Emlékeztető: a 3 jellemzőnk nagyon különböző skálán mozog (3-15 cm vs. 80-320 gramm vs. 0-7 hibapont) — ha ezt nem standardizálnánk (22. lecke), a nagyobb skálájú jellemző (súly) indokolatlanul "elnyomná" a kisebb skálájúakat a tanítás során.
Mert a validációs és a teszt adatnak a tanítás szempontjából „látatlannak" kell maradnia. Ha a teljes adatsor átlagát és szórását használnánk, a teszt adatról is kerülne információ a tanításba (ezt hívják adatszivárgásnak), és a teszteredmény a valósnál kicsit optimistább lenne. Ezért a helyes sorrend: előbb felosztás, aztán a tanító adatból számolt átlaggal és szórással alakítjuk át mindhárom részt — és később az új, éles adatot is (7. lépés).
X_atlag = X_train.mean(axis=0)        # CSAK a tanító adatból számoljuk!
X_szoras = X_train.std(axis=0)
X_train = (X_train - X_atlag) / X_szoras
X_val = (X_val - X_atlag) / X_szoras    # ugyanazzal az átlaggal és szórással
X_test = (X_test - X_atlag) / X_szoras
print("LÉPÉS 3 — Standardizálás elvégezve (00b + 22. lecke módszerével), a tanító adat alapján.")
print(f"A tanító adat átlaga standardizálás előtt: {X_atlag.round(2)}")
print(f"A tanító adat szórása standardizálás előtt: {X_szoras.round(2)}")
print()
Lépés 4 — Egyszerű osztályozó modell (emlékeztető a 14b lecke k-NN algoritmusára — egyszerűség kedvéért, hogy a teljes pipeline PyTorch nélkül is látható legyen)
Ez a záróprojekt szándékosan egy másik, egyszerűbb algoritmust (14b. lecke) mutat be — ezzel bizonyítva, hogy a korábban tanult lépések (adat-előkészítés, felosztás, kiértékelés) nem csak a neurális hálókra érvényesek, hanem bármely ML- algoritmusra — a "pipeline" (folyamat) ugyanaz marad, csak a középső "modell" rész cserélhető.
def k_nn_osztalyoz(uj_pont, X_tanito, y_tanito, k=3):
    """Egyszerű k-NN implementáció (EMLÉKEZTETŐ a 14b, 00b LECKÉRE):
    megkeresi a k legközelebbi tanítópontot, és a köztük
    leggyakoribb kategóriát adja vissza."""
    tavolsagok = np.linalg.norm(X_tanito - uj_pont, axis=1)
    legkozelebbi_indexek = np.argsort(tavolsagok)[:k]
    legkozelebbi_cimkek = y_tanito[legkozelebbi_indexek]
A leggyakoribb címke kiválasztása (emlékeztető az argmax-ra, 21. lecke — itt "szavazásként" használva):
    ertekek, darabszamok = np.unique(legkozelebbi_cimkek, return_counts=True)
return ertekek[np.argmax(darabszamok)]def modell_ertekeles(X_adat, y_adat, X_tanito, y_tanito, k=3):
"""Végigfuttatja a k-NN-t egy egész adathalmazon, és
visszaadja a jóslatokat."""
joslatok = np.array([
k_nn_osztalyoz(pont, X_tanito, y_tanito, k)
for pont in X_adat
])
return joslatokprint("LÉPÉS 4 — k-NN osztályozó modell elkészítve (14b. lecke).")
print()Lépés 5 — Hiperparaméter-választás a validációs adaton (emlékeztető a 20. leckére: miért külön validációs halmaz?)
Kipróbálunk több "k" értéket (hány szomszédot nézzünk), és a validációs adaton nézzük meg, melyik a legjobb — ez pontosan az a folyamat, amit a 20. lecke tanított: a validációs adatot a modell "beállításainak" hangolására használjuk, nem a végső értékelésre.
legjobb_k = None
legjobb_pontossag = 0
print("LÉPÉS 5 — Hiperparaméter-keresés (k érték) a validációs adaton:")
for k_ertek in [1, 3, 5, 7]:
    joslatok_val = modell_ertekeles(X_val, y_val, X_train, y_train, k=k_ertek)
    pontossag = np.mean(joslatok_val == y_val)
    print(f"  k={k_ertek}: pontosság a validációs adaton = {pontossag*100:.1f}%")
    if pontossag > legjobb_pontossag:
        legjobb_pontossag = pontossag
legjobb_k = k_ertekprint(f"-> Legjobb k érték: {legjobb_k} (validációs pontosság: {legjobb_pontossag*100:.1f}%)")
print()Lépés 6 — Végső kiértékelés a teszt adaton (emlékeztető a 24. leckére: confusion matrix, precision, recall, F1)
Ez a lépés csak egyszer fut le, a legvégén, a teszt adaton — ez adja a valós, elfogulatlan képet a modell teljesítményéről (emlékeztető: a teszt adatot soha nem használtuk sem tanításra, sem hiperparaméter-választásra — 20. lecke alapelve).
joslatok_teszt = modell_ertekeles(X_test, y_test, X_train, y_train, k=legjobb_k)
print("LÉPÉS 6 — Végső kiértékelés a teszt adaton:")
print(f"Valós kategóriák:   {y_test.astype(int)}")
print(f"Jósolt kategóriák: {joslatok_teszt.astype(int)}")vegso_pontossag = np.mean(joslatok_teszt == y_test)
print(f"Teszt pontosság: {vegso_pontossag*100:.1f}%")
print()Egyszerűsített confusion matrix (emlékeztető a 24. leckére) — 3 kategóriára (0=B osztály, 1=A osztály, 2=selejt):
kategoriak = [0, 1, 2]
kategoria_nevek = ["B oszt.", "A oszt.", "selejt"]
print("Confusion matrix (sor = valós, oszlop = jósolt):")
print(f"{'':10}", end="")
for nev in kategoria_nevek:
    print(f"{nev:>10}", end="")
print()
for valos_kat, valos_nev in zip(kategoriak, kategoria_nevek):
    print(f"{valos_nev:10}", end="")
    for jos_kat in kategoriak:
        darab = np.sum((y_test == valos_kat) & (joslatok_teszt == jos_kat))
        print(f"{int(darab):>10}", end="")
    print()
print()
Melyik hiba a legveszélyesebb ebben a forgatókönyvben? Emlékeztető a 24. lecke precision/recall gondolatmenetére: ha egy valós "selejt" terméket a rendszer tévesen "A osztályúnak" jelöl (alacsony recall a "selejt" kategórián), az komoly minőségi problémát okozhat (egy hibás termék eljut a vevőhöz) — ezért egy valós projektben külön figyelmet érdemelne a "selejt" kategória recall értékének maximalizálása, még akkor is, ha ez néhány "A osztályú" terméket tévesen "selejtnek" jelölne (alacsonyabb precision a "selejt" kategórián) — ez egy tudatos, üzleti/szakmai döntés, nem csak technikai kérdés.
Lépés 7 — „Éles" becsomagolás (emlékeztető a 25. lecke MLOps elveire — illusztratív, nem teljes FastAPI-kód)
def mino_osztalyozo_szolgaltatas(meret_cm, suly_g, hiba_pontszam):
    """Ez a függvény reprezentálja azt, amit egy VALÓS projektben
    egy API-végpont (25. lecke FastAPI példája) hívna meg —
    bemenetként egy ÚJ termék jellemzőit kapja, kimenetként a
    jósolt kategóriát adja vissza, EMBERI OLVASÁSRA ALKALMAS
    FORMÁBAN."""
    uj_pont_nyers = np.array([meret_cm, suly_g, hiba_pontszam])
Fontos: az új adatot is ugyanazzal az átlaggal/szórással kell standardizálni, amit a tanító adaton számoltunk (lépés 3) — ez egy gyakori hibaforrás éles rendszerekben (emlékeztető a 25. lecke "verziókezelés" elvére: a standardizálási paramétereket is el kell menteni/követni a modellel együtt!):
    uj_pont_standardizalt = (uj_pont_nyers - X_atlag) / X_szoras
    joslat = k_nn_osztalyoz(uj_pont_standardizalt, X_train, y_train, k=legjobb_k)
    kategoria_map = {0: "B osztály", 1: "A osztály", 2: "selejt"}
return kategoria_map[int(joslat)]print("LÉPÉS 7 — 'Éles' szolgáltatás kipróbálása ÚJ, korábban nem")
print("látott termékekkel:")
print()Teszteljük le 3 új, kitalált termékkel:
teszt_termekek = [
    (9.0, 200, 0),    # ideális méret/súly, nincs hiba -> valószínűleg A osztály
    (7.0, 160, 3),    # kissé eltérő, közepes hiba -> valószínűleg B osztály
    (14.0, 300, 6),   # nagyon szélsőséges méret, sok hiba -> valószínűleg selejt
]
for me, su, hi in teszt_termekek:
    eredmeny = mino_osztalyozo_szolgaltatas(me, su, hi)
    print(f"  Termék (méret={me}cm, súly={su}g, hiba={hi}) -> KATEGÓRIA: {eredmeny}")
print()
Lépés 8 — Jogi/etikai megjegyzés (emlékeztető a 27. leckére)
Emlékeztető a 27. lecke rész 3-ra: egy ilyen minőségosztályozó rendszer (ami mért, objektív adatok alapján sorol be termékeket, de nem személyekről dönt) tipikusan a "minimális kockázat" kategóriába esne az EU AI Act szerint — de ha a rendszer eredménye közvetlenül befolyásolna pl. egy munkavállaló teljesítmény-értékelését (ha a "sok selejtet gyártó" gépsort vagy operátort automatikusan "megbüntetné"), az már egy magasabb kockázati szintet jelenthetne — ezért a gyakorlati javaslat (27. lecke rész 5 checklistája alapján): mindig legyen emberi áttekintési lehetőség, különösen határeseti ("B osztály" közeli) besorolásoknál.
A 27. lecke elvei alapján az ilyen rendszert érdemes előszűrésre használni, nem pedig emberi felülvizsgálat nélküli végleges döntésre. Különösen a határeseteknél maradjon lehetőség emberi ellenőrzésre.
Összefoglaló — a teljes pipeline egyben
| Lépés | Mit csináltunk? | Kapcsolódó lecke |
|---|---|---|
| 1. | Nyers adat → jellemzővektorok | 00b, 15, 22 |
| 2. | Train/val/test felosztás | 20 |
| 3. | Standardizálás a tanító adat alapján | 00b, 22 |
| 4. | Modell választása (k-NN) | 14b, 00b |
| 5. | Hiperparaméter-hangolás a validációs adaton | 20 |
| 6. | Végső kiértékelés a teszt adaton (confusion matrix) | 24 |
| 7. | „Éles" becsomagolás (szolgáltatás-függvény) | 25 |
| 8. | Jogi/etikai kockázat átgondolása | 27 |
Mi marad ugyanaz, ha más modellt választasz? A teljes sorozat végső tanulsága: ez a 8 lépés pontosan az a folyamat, amit bármilyen valós osztályozási/minőségellenőrzési projekt végigjárna — legyen szó gyártásról, mezőgazdaságról, logisztikáról, vagy bármi másról, ahol mért adatok alapján kell döntést hozni — csak a középső rész, a modell (lépés 4) változna (k-NN helyett lehetne neurális háló — 14. lecke, vagy bármely más, a 14b. leckében bemutatott algoritmus) — de a keretrendszer (adat előkészítése, felosztás, hangolás, kiértékelés, csomagolás, jogi átgondolás) ugyanaz marad, függetlenül a konkrét algoritmustól vagy alkalmazási területtől. Ez a "gondolkodásmód" az, amit ez a tananyag ténylegesen át akart adni — nem csak egyes technikákat, hanem egy teljes, megbízható, általánosan alkalmazható munkafolyamatot.
1. Módosítsd a lépés 1 adatgenerálást: adj hozzá egy negyedik jellemzőt (pl. "szín_eltérés" — mennyire tér el a termék színe az ideálistól) — futtasd újra a teljes pipeline-t, és nézd meg, változik-e a teszt pontosság.
2. Cseréld le a lépés 4 k-NN modellt egy valódi PyTorch neurális hálóra (emlékeztető a 14, 21. leckére — három kimeneti neuron kell a 3 kategóriához, CrossEntropyLoss-szal) — ez a legjobb gyakorlat annak bizonyítására, hogy a többi lépés (1, 2, 3, 5, 6, 7, 8) változatlan maradhat.
3. Gondold végig: válassz egy saját területet (bármit, ami érdekel — lehet gasztronómia, sport, kertészkedés, bármi), és írj le legalább 3 mérhető jellemzőt, amivel egy hasonló osztályozó rendszert építhetnél arra a területre.
4. Új gyakorlat — a teljes sorozat lezárása: nézd végig a 00a. lecke (tartalomjegyzék) teljes listáját, és írj magadnak egy rövid (5-10 mondatos) összefoglalót: mit tanultál a legfontosabbnak ebből a teljes sorozatból, és mi az, amivel a jövőben a legszívesebben folytatnád a tanulást?
Gratulálunk! Ezzel a tananyag végigért: a Python alapoktól a matematikai háttéren, a neurális hálókon és nyelvi modelleken át a jogi és gazdasági kontextusig. A záróprojektben láthatóvá vált, hogyan áll össze mindez egyetlen gyakorlati folyamatban. Ha szeretnéd lemérni, mennyi maradt meg belőle, próbáld ki a 00e. lecke végén a 60 kérdéses, pontozott záróvizsgát.