05. Modul · 18. lecke
A derivált intuíciója — a tanulás motorja
Honnan tudja a gép, merre hangolja a súlyait, hogy kevesebbet tévedjen? A derivált mondja meg. Ez a gépi tanulás legmélyebb motorja.
A derivált egyetlen kérdésre válaszol: „ha most egy egészen picit megváltoztatom a bemenetet, mennyivel és merre változik a kimenet?" Vagyis: mennyire meredek a függvény ezen a ponton. A 15. lecke egyenesének a meredeksége mindenütt ugyanaz volt (w). De egy görbénél a meredekség pontról pontra változik — a derivált az adott ponthoz tartozó meredekség.
A legjobb kép hozzá a ködös hegyoldal. Képzeld: bekötött szemmel állsz egy domboldalon, és le akarsz jutni a völgybe (a legkisebb hibához). Mit teszel? Megtapogatod a lábad alatt, merre lejt a talaj, és arra lépsz egyet. Aztán újra. A „merre lejt" — ez a derivált. A völgy alja — a legkisebb hiba.
Nem feltétlenül — előfordulhat, hogy egy sekélyebb, de nem a legmélyebb völgyben („lokális minimum") ragad be, és onnan a puszta lejtőkövetés nem visz tovább lefelé. A modern gépi tanulás emiatt trükköket is bevet (pl. „momentum" vagy véletlenszerű zaj), hogy a labda át tudjon lendülni a kisebb gödrökön a mélyebb völgy felé.
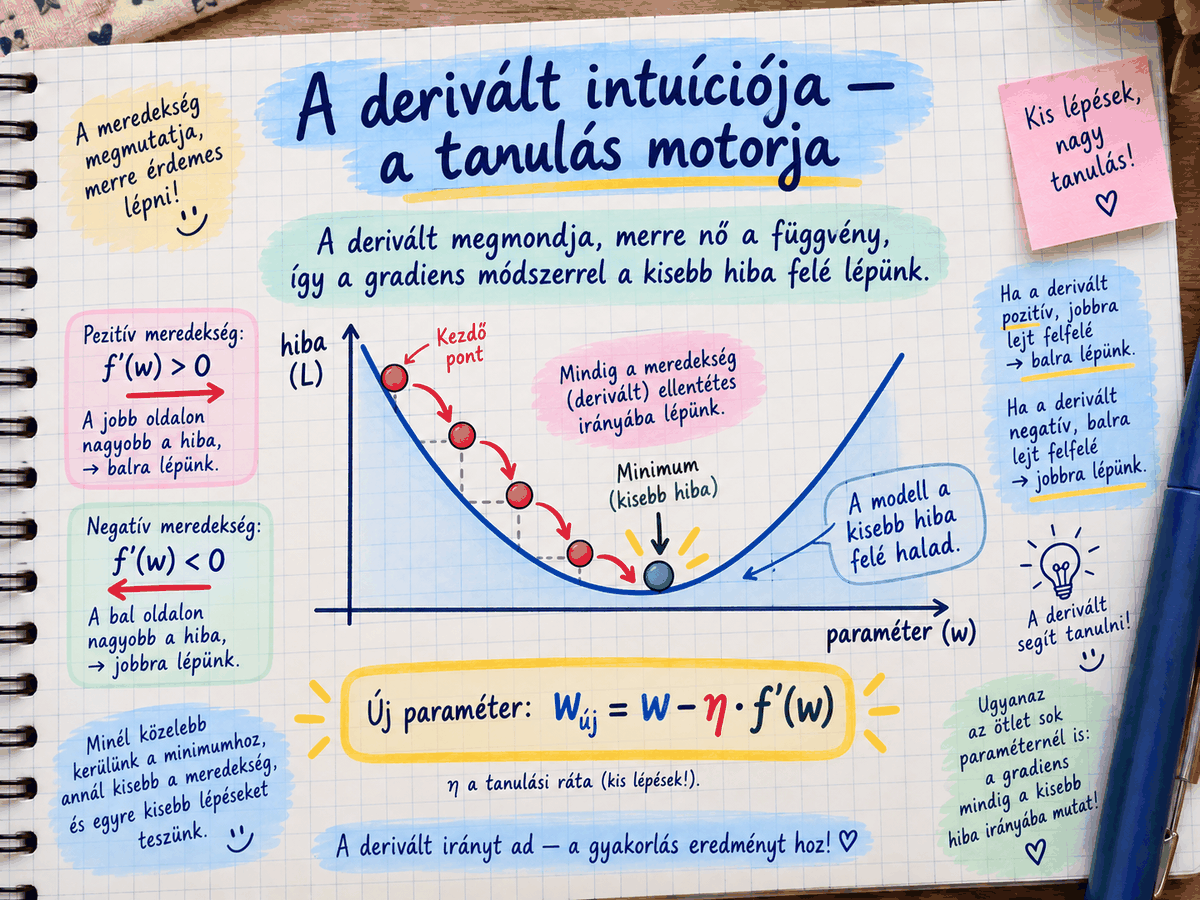
A tanulás pontosan ez: a gép kiszámolja a hiba meredekségét (a deriváltat) minden súlyra, majd a súlyt a lejtővel lefelé tolja egy picit — a kisebb hiba felé. Aztán újra, és újra, sok millió lépésen át. És itt köszön vissza a 6. lecke: a meredekség lehet negatív (növelni kell a súlyt) vagy pozitív (csökkenteni) — az előjel mondja meg az irányt.
Miért csak kicsi lépések? Mert ha nagyot lépsz, átugorhatod a völgy alját, és a túloldalon kötsz ki — sőt, ide-oda pattoghatsz anélkül, hogy valaha leérnél. A lépés méretét tanulási rátának (learning rate) hívják, és ez az egyik legfontosabb beállítás: túl kicsi → lassú a tanulás; túl nagy → a gép „elpattog" és sosem talál le a völgybe.
Kidolgozott példák
Előbb próbáld meg magad papíron, aztán nyisd le a lépésenkénti megoldást, és vesd össze a sajátoddal.
Példa 1 · Becsüld meg az f(x) = x² függvény meredekségét az x = 3 pontban.
2. A változás aránya: (9,0601 − 9) : 0,01 = 0,0601 : 0,01 = 6,01.
A meredekség tehát kb. 6. (Ez nem véletlen: az x² deriváltja 2x, és 2 × 3 = 6.) ✔
Példa 2 · Két lépés gradiens-ereszkedés: a hiba (w − 4)², ennek deriváltja 2(w − 4). A w = 0-ról indulunk, a tanulási ráta 0,25.
2. lépés: derivált = 2 × (2 − 4) = −4. Új w = 2 − 0,25 × (−4) = 3.
A w lépésről lépésre közelít a 4-hez, ahol a hiba 0 — a völgy aljához. A lépések egyre kisebbek, mert a lejtő egyre laposabb. ✔
Nézd az ábrát: a piros labda a völgy jobb oldalán van. Merre kell gurulnia, hogy a legkisebb hibához (a völgy aljához) jusson — balra vagy jobbra? És ha a bal oldalon lenne?
Megoldás
Ez a gépi tanulás igazi motorja. A hírhedt „backpropagation" és „gradient descent" pontosan ennyi: számold ki minden súlyra, merre lejt a hiba (derivált), és lépj arra egy kicsit. Sok millió ismétlés után a gép magától megtalálja a jó súlyokat — senki nem állítja be őket kézzel. Itt kel életre minden, amit eddig tanultál: a szorzás, a negatív számok, a függvény meredeksége.