05. Modul · 17. lecke
Mátrixok — a súlyok táblázata
Egy egész réteg neuron = egy mátrix. A videokártyák (GPU-k) szinte teljes munkája mátrixszorzás. Ez az AI „nyers ereje" matematikailag.
Ha a vektor egy számlista, a mátrix egy számtáblázat: sorokba és oszlopokba rendezett számok. Olyan, mint egy Excel-táblázat, ahol minden cellában egy szám ül.
Miért van rá szükség? Egy neuronnak sok súlya van (egy minden bemenethez). Ha sok neuron van egymás mellett — egy „réteg" —, akkor sok neuron sok súlya együtt egy táblázatot, azaz mátrixot alkot. És a mátrix egyetlen művelettel elvégzi az összes neuron szorzás-összeadását egyszerre.
Nem — szigorú szabály van rá: az első mátrix oszlopainak száma pontosan meg kell egyezzen a második mátrix (vagy vektor) elemeinek számával. Ha ez nem stimmel, a szorzás értelmezhetetlen, és a program hibát dob. Ezért kell, hogy egy neurális háló egymást követő rétegeinek mérete pontosan illeszkedjen egymáshoz.
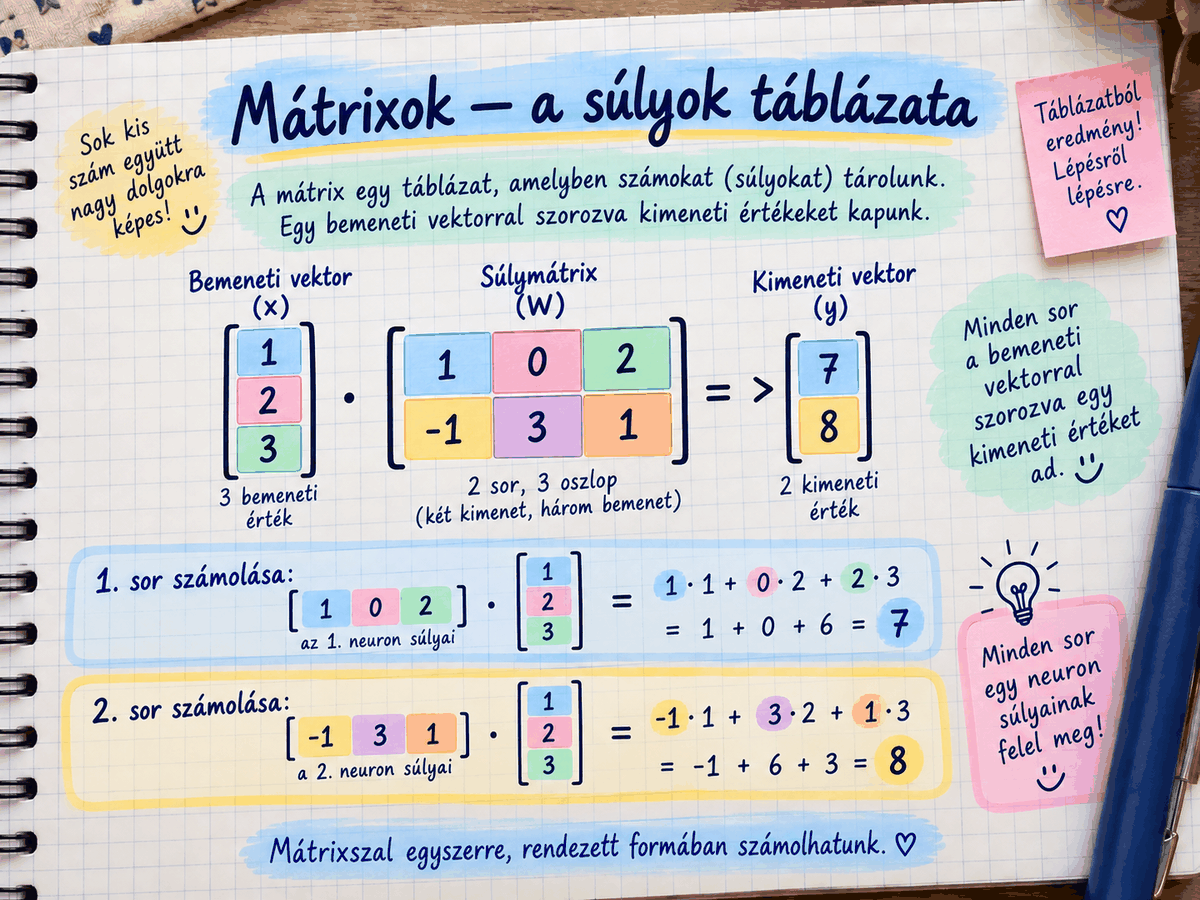
A művelet lelke ismerős: a mátrix minden sora egy neuron súlyait tartalmazza, és ezt a sort a bemeneti vektorral „összeszorozzuk, majd összeadjuk". Az első sor (1, 0, 2) a bemenettel (2, 5, 1): 1·2 + 0·5 + 2·1 = 4. Ez pontosan a 15. lecke neuronszámítása — csak most egy mozdulattal az összes neuronra.
Miért kellenek az AI-hoz drága videokártyák? Mert a mátrixszorzás rengeteg apró, egyforma szorzás-összeadásból áll, amiket egyszerre, párhuzamosan is el lehet végezni. A GPU pont erre való: több ezer parányi számolómagja van, amik mind egyszerre dolgoznak egy-egy cellán. Egy hagyományos processzor egyesével csinálná; a GPU ezret egy pillanat alatt. Ez a párhuzamosítás tette egyáltalán lehetővé a modern AI-t.
Kidolgozott példák
Előbb próbáld meg magad papíron, aztán nyisd le a lépésenkénti megoldást, és vesd össze a sajátoddal.
Példa 1 · Számold ki: [[2, 0], [1, 3]] × [4, 5]
2. Második sor × vektor: 1 × 4 + 3 × 5 = 4 + 15 = 19.
Eredmény: [8, 19] — két sor, két szám. ✔
Példa 2 · Egy réteg 4 bemenetből 3 kimenetet csinál. Mekkora a súlymátrixa, és hány tanulható szám van benne a biasokkal együtt?
2. Súlyok: 3 × 4 = 12. Biasok: kimenetenként egy, azaz 3.
Összesen 15 paraméter. A nagy nyelvi modellek „milliárd paramétere" pontosan ilyen számokból áll össze. ✔
A fenti mátrix második sora (3, 1, 0). Számold ki te: mennyi a szorzata a (2, 5, 1) vektorral?
Megoldás
Egy neuronháló-réteg gyakorlatilag egy mátrix (a súlyok) és egy vektor (a biasok). A modell „futtatása" nem más, mint mátrixszorzások hosszú lánca, egyik réteg a másik után. És amikor azt hallod, „a modellnek 7 milliárd paramétere van" — azok jórészt ezeknek a súlymátrixoknak a cellái. A mátrix az, ami a sok neuront egyetlen, gyors műveletté fogja össze.