28. lecke
AI piac és gazdaság: kik a nagy szereplők, mennyibe kerül mindez?
2026. szeptemberi, frissített állapot — üzleti modellek, API-árazás vs. saját modell futtatása, gyakorlati költségbecslés egy kisvállalkozás számára
Mennyibe kerül egy AI-megoldás, és kik uralják a piacot? Ez a lecke bemutatja a nagy szereplőket, az AI-cégek üzleti modelljeit, részletesen az API-árazást hivatalos források alapján, egy gyakorlati költségbecslést egy kisvállalkozás chatbotjára, és segít eldönteni, mikor éri meg API-t használni, és mikor saját modellt futtatni.
- Kik a nagy szereplők a piacon? (2026-os állapot)
- Üzleti modellek: hogyan keres pénzt egy AI-cég?
- API-árazás részletesen, hivatalos források alapján (2026. Szeptemberi,…
- Gyakorlati költségbecslés: mennyibe kerülne egy kisvállalkozás chatbotja?
- API használat vs. saját modell futtatása: mikor éri meg melyik?
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 6 rész · 5 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Ez az utolsó lecke ebben a "komplex kiegészítő" sorozatban (20-28. lecke) — most már nem a technikai működést, hanem a gazdasági környezetet nézzük meg, amiben mindez a technológia létezik — ez közvetlenül hasznos, ha valaha AI-funkciót használnál egy saját vagy megrendelői projektben.
Frissítve: 2026. szeptember. Az árak két gyártó (Anthropic, OpenAI) saját, hivatalos árlista-oldaláról származnak — nem harmadik fél összesítőjéből.
Forrás (2026. Szeptemberi, ellenőrzött állapot):
- Anthropic hivatalos árlista: platform.claude.com/docs/en/ about-claude/pricing
- OpenAI hivatalos árlista: developers.OpenAI.com/api/docs/ pricing
Fontos tudnod: az AI-API árak gyakran, akár havonta változnak, új modellek jelennek meg, régiek vonulnak ki — ezért egy valós projekt tervezésekor mindig ellenőrizd a szolgáltató aktuális, hivatalos árlistáját közvetlenül (ne harmadik fél összesítőt), mielőtt valós döntést hoznál.
Harmadik fél összesítő oldalain előfordul számolási hiba (volt rá példa, hogy egy példa-számítás kb. 1000-szeres tévedést tartalmazott) — ez jól mutatja: minél közelebb vagy az eredeti forráshoz (a gyártó saját oldala), annál kisebb az esélye, hogy közvetített, másodlagos hiba kerül a számításodba.
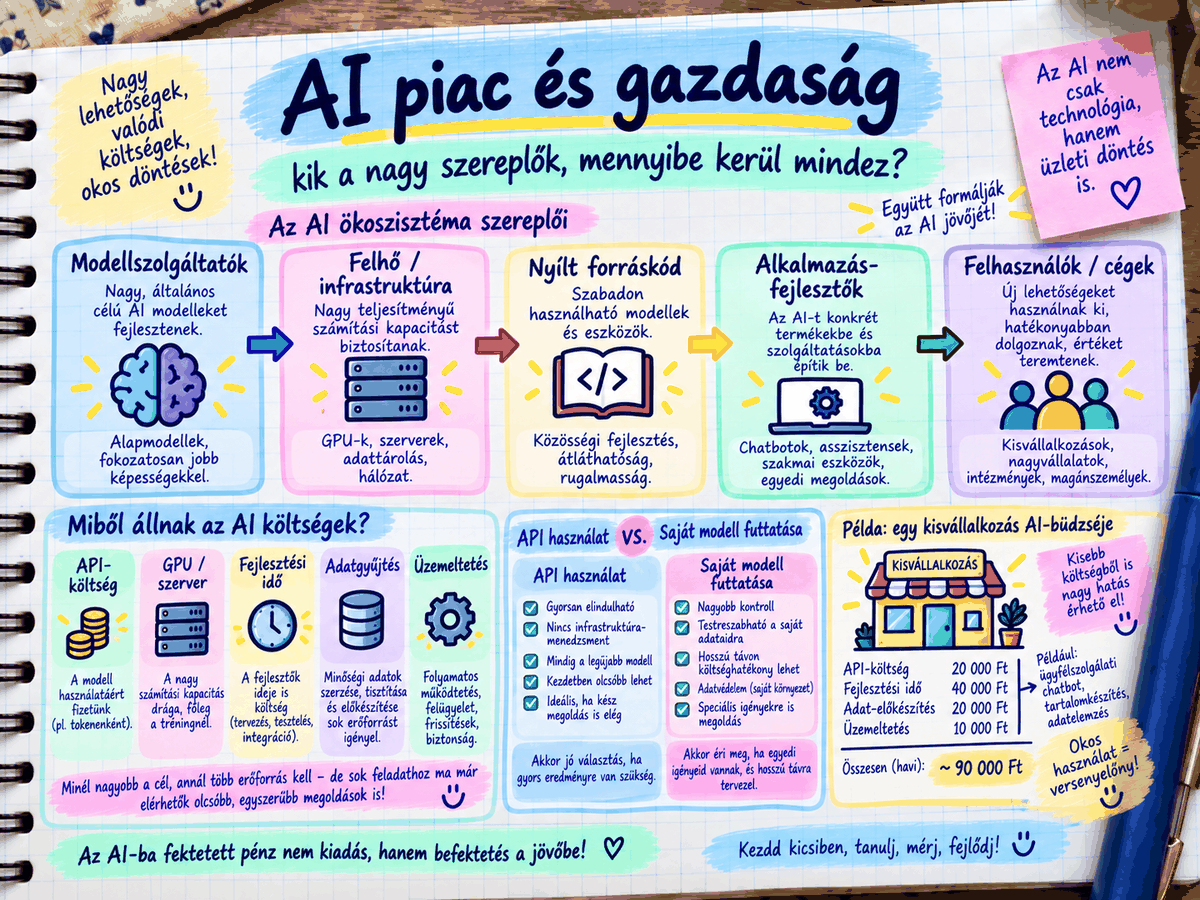
Rész 1 — Kik a nagy szereplők a piacon? (2026-os állapot)
Emlékeztető a 19. lecke történeti áttekintéséből: a nagy nyelvi modellek piaca 2022 (ChatGPT) óta gyorsan növekedett, és ma (2026) több, egymással versenyző nagy szereplő osztja a piacot:
- OpenAI (gpt-modellcsalád) — a ChatGPT fejlesztője, a terület egyik úttörője (17, 19. lecke).
- Anthropic (Claude modellcsalád) — biztonság-központú megközelítéséről ismert cég (emlékeztető a 12b lecke rész 6-ra: a "responsible disclosure" és biztonsági rétegek hangsúlyozása).
- Google (Gemini modellcsalád) — a Google saját kutatási hátterére épít (emlékeztető a 19. leckére: a Transformer architektúrát is eredetileg Google-kutatók publikálták 2017-ben!).
- Meta (Llama modellcsalád) — más megközelítést választott: "nyílt súlyozású" (open-weight) modelleket ad ki, amiket bárki letölthet, saját gépén/szerverén futtathat (emlékeztető a 19. leckére: Llama 3.1, 2024).
- További szereplők: xAI (Grok), Mistral (európai, francia fejlesztésű modellek), és számos kisebb, specializált cég/nyílt forrású közösségi projekt.
Miért van ennyi különböző szereplő, miért nem 'egy győztes viszi mindet'? Mert (emlékeztető a 18. leckére) egy nagy nyelvi modell betanítása óriási, de nem leküzdhetetlen tőkebefektetést igényel — több nagy cégnek (és egyre több nyílt közösségnek) is megvan az erőforrása ehhez, és a különböző cégek különböző stratégiákat követnek (pl. Anthropic a biztonságra, Meta a nyíltságra helyezi a hangsúlyt) — ez a verseny a felhasználóknak (tehát neked is) előnyös, mert több választási lehetőséget, és folyamatosan csökkenő árakat eredményez.
Rész 2 — Üzleti modellek: hogyan keres pénzt egy AI-cég?
A nagy AI-cégek többféle üzleti modellt használnak egyszerre:
1. API-előfizetés/használat alapú díjazás: fejlesztők (mint te, ha építenél valamit) "tokenenként" (emlékeztető a 17. lecke tokenizálás fogalmára!) fizetnek a modell használatáért — ez a leggyakoribb módja annak, hogy harmadik fél fejlesztők (saját alkalmazásba) beépítsék a modellt.
2. Fogyasztói előfizetés: közvetlenül a végfelhasználóknak (pl. havi díjas "pro" változatok a chat-felületekhez, több használattal/képességgel).
3. Vállalati/enterprise szerződések: nagyvállalatoknak testreszabott megoldások, gyakran egyedi árazással, speciális biztonsági/megfelelési (27. lecke!) garanciákkal.
Miért 'tokenenként' fizetünk, miért nem 'kérdésenként' vagy 'havi átalányban'? Emlékeztető a 18. leckére: minden egyes token feldolgozása tényleges számítási költséggel (áram, GPU-idő) jár a szolgáltató számára — egy hosszú kérdés/válasz több számítást igényel, mint egy rövid — ezért a tokenenkénti árazás közvetlenül tükrözi a tényleges, alapul szolgáló költséget, szemben egy "minden kérdés ugyanannyiba kerül" modellel, ami igazságtalan lenne (egy 2 szavas és egy 2000 szavas kérdés nagyon különböző költséggel jár a szolgáltatónak).
Rész 3 — API-árazás részletesen, hivatalos források alapján (2026. Szeptemberi, frissített adatok)
Konkrét, gyártói hivatalos árak: az alábbi táblázat nem általános "kategóriákkal" dolgozik, hanem valós, névvel azonosított modellek hivatalos áraival.
Anthropic (Claude) — hivatalos ár, $/millió token:
| Modell | Bemenet ($ / millió token) | Kimenet ($ / millió token) |
|---|---|---|
| Claude Haiku 4.5 | 1 | 5 |
| Claude Sonnet 5 | 2 | 10 |
| Claude Opus 5 | 5 | 25 |
| Claude Opus 5.5 (2026. szeptember 22.) | 4 | 20 |
| Claude Fable 5.1 / Mythos 5.1 (legerősebb, „csúcs" kategória) | 10 | 50 |
OpenAI (gpt) — hivatalos ár, $/millió token (a 2026 szeptemberében aktuális modellnevek — fontos: az OpenAI gyakran nevezi át/frissíti a modellcsaládját, ezért a konkrét nevek gyorsabban elavulnak, mint az árszintek):
| Modellszint | Bemenet ($ / millió token) | Kimenet ($ / millió token) |
|---|---|---|
| Költséghatékony (belépő) | 0,10 | 0,60 |
| Közepes teljesítményű | 1,00 | 6,00 |
| Zászlóshajó (promóciós áron) | 2,00 | 10,00 |
| Legfejlettebb („flagship") | 5,00 | 25,00 |
Miért van, hogy az anthropic táblázatban konkrét modellneveket látsz, az OpenAI-nál pedig csak 'szinteket'? Ez a lecke szándékosan így kezeli a két gyártót: az anthropic modellnevei (Haiku, Sonnet, Opus, Fable/Mythos) viszonylag stabilak, hosszabb távon használatban maradnak — az OpenAI gyakrabban vezet be új modellverziókat új nevekkel (ezért egy konkrét név megadása itt gyorsan elavulna a leckében) — a "szint szerinti" megközelítés (belépő/közepes/zászlóshajó) stabilabb, hosszabb távon is használható tájékozódási pont. Ezért: ha valós projektet tervezel, mindig nézd meg a gyártó aktuális modelllistáját — a konkrét név és ár változhatott, mire ezt olvasod.
Miért ilyen nagy a különbség a bemenet és a kimenet ára között (a kimenet mindig drágább, kb. 5-Szörös szorzóval)? Emlékeztető a 17. lecke lépés 4-re (előtanítás/next-token prediction): a modellnek a bemenetet "csak" fel kell dolgoznia (egyszeri átfutás a Transformer rétegeken — 17. lecke lépés 3), de a kimenet generálása során minden egyes új tokenhez újra le kell futtatnia a teljes számítást (mert minden új token függ az összes korábbi tokentől, beleértve a már generált választ is) — ez számításilag lényegesen költségesebb, ezért drágább. Figyeld meg: ez az 5-szörös arány (pl. Claude Sonnet 5-nél $2 vs. $10) mindkét gyártónál nagyjából hasonló nagyságrendű — ez nem véletlen, hanem azt tükrözi, hogy a mögöttes számítási költségarány hasonló mindkét cégnél, mert ugyanaz a Transformer-alapú architektúra (17. lecke) áll a háttérben.
Cache-elés: hogyan lehet olcsóbbá tenni az API-használatot? Az Anthropic (és más gyártók is) kínálnak "prompt caching" (kontextus-gyorsítótárazás) lehetőséget: ha ugyanazt a hosszú bevezető szöveget (pl. egy részletes rendszerutasítást — 26. lecke) többször használod rövid időn belül, a modellnek nem kell újra "végigolvasnia" azt minden egyes alkalommal — ez jelentősen (akár 90%-kal) csökkentheti a költséget ismétlődő, hosszú kontextusú használat esetén (pl. egy chatbot, ami mindig ugyanazt a hosszú termékleírást használja kontextusként — ez tipikus használati minta egy webáruház vagy egy szolgáltató chatbotjánál).
Ha a válaszokat nem kell azonnal (valós időben) megkapnod — pl. egy éjszakai, tömeges adatfeldolgozási feladatnál — a "batch" (kötegelt) API használata 50%-os kedvezményt ad mindkét gyártónál az árakból — ez egy fontos gyakorlati tanulság: nem minden AI-használatnak kell "azonnalinak" lennie — ha a feladat engedi a késleltetést, jelentős megtakarítás érhető el.
Mit jelent konkrétan egy 'millió token' — sok ez vagy kevés? Emlékeztető a 17. lecke tokenizálás részére: egy token körülbelül egy rövid szórészletnek felel meg — magyar szövegnél (ami hosszabb szavakkal/toldalékokkal dolgozik) nagyjából 1 millió token kb. 600.000-750.000 Magyar szónak felel meg (ez egy közelítő érték — a pontos arány modellenként eltér) — tehát egy millió token egy elég nagy mennyiségű szöveget jelent, több száz oldalnyi olvasmányt.
Rész 4 — Gyakorlati költségbecslés: mennyibe kerülne egy kisvállalkozás chatbotja?
Nézzünk egy konkrét, számolt példát — ez pontosan az a fajta számítás, amit egy valós projekt előtt érdemes elvégezni.
Feltételezett használat: egy kis weboldal ügyfélszolgálati chatbotja, havi 500 beszélgetéssel, átlagosan 300 token bemenet (a látogató kérdése + a rendszer kontextusa) és 200 token kimenet (a válasz) beszélgetésenként.
havi_beszelgetesek = 500
atlagos_bemenet_tokenenkent = 300
atlagos_kimenet_tokenenkent = 200
teljes_havi_bemenet = havi_beszelgetesek * atlagos_bemenet_tokenenkent
teljes_havi_kimenet = havi_beszelgetesek * atlagos_kimenet_tokenenkent
print(f"Havi bemeneti tokenek összesen: {teljes_havi_bemenet:,}")
print(f"Havi kimeneti tokenek összesen: {teljes_havi_kimenet:,}\n")
Konkrét, névvel azonosított modellek hivatalos árával számolva (rész 3 táblázata alapján, dollárban, $/millió token):
modellek = {
    "Claude Haiku 4.5 (Anthropic, olcsó)":       {"bemenet_ar": 1.00,  "kimenet_ar": 5.00},
    "Claude Sonnet 5 (Anthropic, kiegyensúlyozott)": {"bemenet_ar": 2.00,  "kimenet_ar": 10.00},
    "Claude Opus 5 (Anthropic, erős)":            {"bemenet_ar": 5.00,  "kimenet_ar": 25.00},
    "OpenAI belépő szintű modell":                 {"bemenet_ar": 0.10,  "kimenet_ar": 0.60},
    "OpenAI zászlóshajó (promóciós áron)":         {"bemenet_ar": 2.00,  "kimenet_ar": 10.00},
}print("HAVI BECSÜLT KÖLTSÉG, KONKRÉT MODELLENKÉNT:")
print("=" * 65)
for nev, arak in modellek.items():
bemenet_koltseg = (teljes_havi_bemenet / 1_000_000) * arak["bemenet_ar"]
kimenet_koltseg = (teljes_havi_kimenet / 1_000_000) * arak["kimenet_ar"]
teljes_koltseg = bemenet_koltseg + kimenet_koltseg
print(f"{nev:48} ~${teljes_koltseg:.3f} / hónap")A példában szereplő használat — havi 500 beszélgetés egy kis üzleti chatbotnál — még erős modell használata mellett is viszonylag alacsony havi költséget eredményezhet. Nagy használati volumen mellett viszont a költség már jelentőssé válhat; ilyenkor érdemes megvizsgálni a prompt caching és a batch API lehetőségeit.
Rész 5 — API használat vs. saját modell futtatása: mikor éri meg melyik?
Emlékeztető a 23. leckére (Transfer Learning): létezik nyílt súlyozású (open-weight) modell is (pl. Llama — rész 1), amit elméletben le lehet tölteni és saját szerveren futtatni, API- költség nélkül. Mikor éri ezt meg választani, az API-használat helyett?
| Szempont | API használata (3–4. rész) | Saját modell futtatása |
|---|---|---|
| Kezdeti befektetés | Gyakorlatilag nulla (csak regisztráció) | Jelentős (saját GPU-szerver vétele/bérlése — 18. lecke!) |
| Folyamatos költség | Használattal arányos (4. rész) | Fix (a szerver üzemben tartása, a használattól függetlenül) |
| Karbantartás | A szolgáltató felelőssége | Saját felelősség (a 25. lecke MLOps-elvei szerint) |
| Adatvédelem / kontroll | Az adat elhagyja a saját rendszert (27. lecke: GDPR!) | Teljes kontroll, az adat nem hagyja el a saját infrastruktúrát |
| Modell minősége / frissessége | Mindig a legújabb, legjobb modellhez férsz hozzá | A letöltött verzióhoz kötött, kézi frissítést igényel |
Mikor választaná egy kisvállalkozás a saját modell futtatását, ha az API ilyen olcsó (rész 4)? A leggyakoribb ok nem a költség, hanem az adatvédelem/kontroll: ha a megrendelő (pl. egy egészségügyi vagy pénzügyi cég) szigorú szabályozás (27. lecke!) alatt áll, és nem engedheti meg, hogy érzékeny adatok egy külső, harmadik fél szerverére kerüljenek, a saját, helyben futó modell (bár drágább és bonyolultabb üzemeltetni) lehet az egyetlen megfelelő választás — a legtöbb kisebb, általános projektnél (pl. egy kisvállalkozás chatbotjánál) viszont az API-használat sokkal egyszerűbb és gazdaságosabb.
Összefoglaló táblázat — a teljes 20-28. lecke-sorozat íve
| Lecke | Téma | Gyakorlati haszon |
|---|---|---|
| 20. | Túltanulás/alultanulás elleni védekezés | Megbízható modell építése |
| 21. | Osztályozás a gyakorlatban | Új feladattípus (nem csak számjóslás) |
| 22. | Adat-előkészítés mélyebben | Gyorsabb, stabilabb tanítás |
| 23. | Transfer learning | Kevés adattal is jó eredmény |
| 24. | Modellértékelés komolyan | Tudod, tényleg jó-e a modelled |
| 25. | MLOps — éles használatba állítás | A modell tényleg használható legyen |
| 26. | Prompt engineering tudományosan | Hatékony AI-használat, nem csak -építés |
| 27. | Etika, jog, felelősség | Jogilag/etikailag megalapozott munka |
| 28. | Piac és gazdaság | Reális költségbecslés |
Mit tudsz most, a sorozat végén? A teljes sorozat záró gondolata: ezzel a 9 leckével (20-28) már nem csak érted, hogyan működik az AI (1-19. lecke), hanem tudod, hogyan építs megbízható modellt (20, 22, 24), hogyan használj már meglévő tudást (23, 26), hogyan vidd élesbe (25), és milyen jogi/gazdasági keretek között mozogsz (27, 28) — ez a teljes ív, ami egy kezdőből valódi AI-tudatos szakembert csinál.
1. Módosítsd a rész 4 kódját: számold ki, mennyibe kerülne havonta, ha a példabeli chatbot nem 500, hanem 5000 beszélgetést kezelne havonta — melyik ponton válik a költség "érdemlegessé" (pl. több száz dollár/hónap)?
2. Gondolkodj el: ha egy vállalkozásnak ajánlanád egy AI-chatbot beépítését, milyen szempontok alapján választanál a rész 3 konkrét modelljei közül (Haiku vs. sonnet vs. opus)? Mikor érdemes többet fizetni a jobb modellért?
3. Új gyakorlat: nézz utána (webes keresés) a jelenlegi, hivatalos árlistáknak (platform.claude.com/docs/en/about- claude/pricing és developers.OpenAI.com/api/docs/pricing) — hasonlítsd össze a talált értékeket a rész 3 táblázatával — változtak-e az árak azóta, hogy ez a lecke íródott (2026 szeptembere)? Ez a gyakorlat maga a legfontosabb tanulság: egy gazdasági témánál (akárcsak a 27. lecke jogi témájánál) soha ne tekints egy számot "véglegesnek" — mindig ellenőrizd az aktuális állapotot közvetlenül a gyártó oldalán, mielőtt valós döntést hoznál.
A tananyag ezen része 2026 szeptemberében frissült; az itt szereplő árak forrásaként a tananyag az Anthropic és az OpenAI hivatalos árlista-oldalait jelöli meg.