Kiegészítő lecke
Az AI/gépi tanulás algoritmusainak térképe
Melyik algoritmust mikor, miért használjuk — képletekkel, gyakorlati példákkal
Eddig egyesével ismerkedtél az algoritmusokkal; ez a lecke a nagy térképet adja. Áttekinti a fő tanulási típusokat, a regresszió és az osztályozás különbségét, majd sorra veszi a legfontosabb algoritmuscsaládokat — a lineáris regressziótól a döntési fán és a klaszterezésen át a konvolúciós hálókig és a Transformerig —, képlettel és példával. A végén egy táblázat segít eldönteni, melyiket mikor érdemes használni.
- A nagy felosztás: 3 fő tanulási típus
- Felügyelt tanulás: regresszió vs. osztályozás
- Algoritmus-családok, képlettel és példával
- Lineáris regresszió (Linear Regression) — már ismered (12. lecke)
- Logisztikus regresszió (Logistic Regression) — új fogalom
- Döntési fa (Decision Tree) — új fogalom
- K-legközelebbi szomszéd (k-Nearest Neighbors, k-NN) — új fogalom
- K-középpont klaszterezés (k-Means Clustering) — új fogalom
- Neurális háló / backpropagation — már ismered (14. lecke)
- Olvasási idő: kb. 15 perc (a kódok kipróbálásával több)
- 13 rész · 0 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Eddig sorban, egyesével tanultuk meg az algoritmusokat (lineáris regresszió a 12. leckében, neurális háló a 14.-ben), de sosem álltunk meg egy pillanatra, hogy megnézzük: hányféle ilyen "eszköz" létezik összesen, és melyiket mikor veszi elő egy AI-fejlesztő. Ez a lecke pontosan ez a térkép — nem új kód, hanem rendszerezés és áttekintés, hogy tudd, mi micsoda, amikor a gyakorlatban szembejön.
Mert az AI-szakmában nem azt várják el tőled, hogy minden algoritmust fejből, képlettel tudj levezetni — hanem hogy adott problémára fel tudd ismerni, melyik családba tartozik a feladat, és melyik eszköz illik rá. Olyan ez, mint egy tapasztalt szerelő: nem kell fejből tudnia minden alkatrész katalógusszámát, de ránézésre felismeri, melyik feladathoz melyik szerszám kell — ugyanez itt az algoritmus-választás.
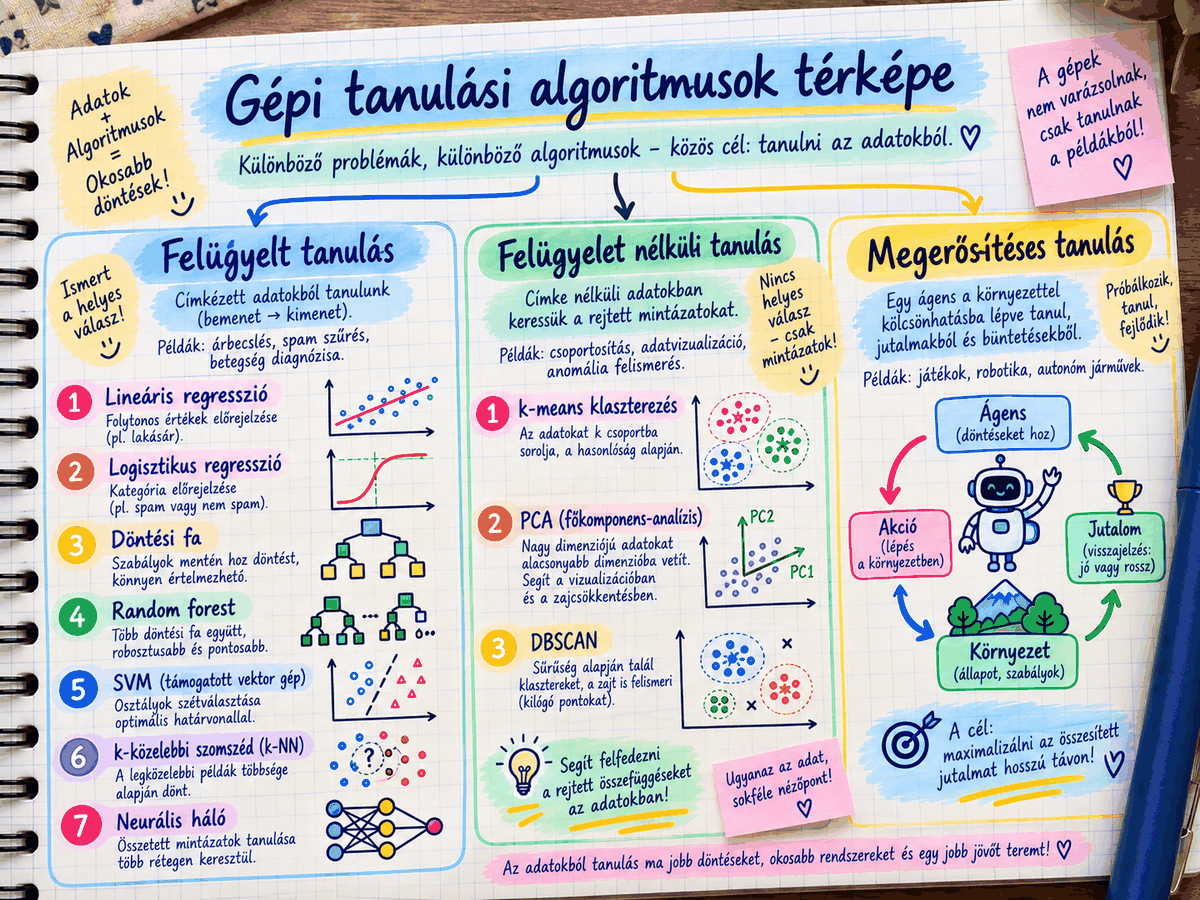
Rész 1 — A nagy felosztás: 3 fő tanulási típus
Mielőtt az egyes algoritmusokba mennénk, ismerd meg a legfelsőbb szintű felosztást — ez alá tartozik minden, amit eddig és ezután tanulsz.
1. Felügyelt tanulás (Supervised Learning) — van címkézett adatod: ismered a "helyes választ" minden tanító adatponthoz (pl. a 12. lecke autós példájában: tudod az árat minden km-értékhez). A modell ebből tanulja meg a km -> ár összefüggést. Ide tartozik: lineáris regresszió, döntési fa, k-NN, a legtöbb neurális háló alkalmazás (pl. képosztályozás, ahol tudod, melyik kép "macska" és melyik "kutya").
2. Felügyelet nélküli tanulás (Unsupervised Learning) — nincs címkézett adatod, csak nyers adatpontok, és a modellnek kell találnia bennük valamilyen szerkezetet vagy csoportosítást, "helyes válasz" nélkül. Ide tartozik: k-means klaszterezés (pl. vásárlók csoportosítása vásárlási szokás alapján, anélkül hogy előre megmondanád, hány csoport legyen és melyik vásárló melyikbe tartozik).
3. Megerősítéses tanulás (Reinforcement Learning) — a modell egy környezetben cselekszik, és jutalom/büntetés visszajelzést kap a döntéseiért, ebből tanulja meg, melyik cselekvés vezet jó eredményhez, hosszú távon. Ide tartozik: játékot tanuló AI-k (pl. sakk, Go), robotika, önvezető autók döntéshozatala.
Ez a lecke elsősorban az 1. Típusra (felügyelt tanulás) fókuszál részletesen, mert eddig is ezt tanultuk, de a 2. és 3. típust is bemutatjuk áttekintő szinten a teljes kép kedvéért.
Rész 2 — Felügyelt tanulás: regresszió vs. osztályozás
A felügyelt tanuláson belül is van egy fontos, alap megkülönböztetés — ez dönti el, melyik algoritmus-családba nézel bele:
- Regresszió (regression): a kimenet egy folytonos szám. Példa: autó ára (2 100 000 Ft, 3 450 500 Ft, bármi lehet).
- Osztályozás (classification): a kimenet egy véges kategória-halmazból választott címke. Példa: "macska" vagy "kutya", "spam" vagy "nem spam", "beteg" vagy "egészséges".
Miért számít ez a különbség? Mert matematikailag teljesen más a hibaszámítás módja: a regressziónál "mennyivel tévedtem számban" a kérdés (pl. 200 ezer Ft-tal alul/felül becsültem), az osztályozásnál "eltaláltam-e a kategóriát" a kérdés (nincs "kicsit macska, kicsit kutya" köztes állapot). Ez a különbség határozza meg, milyen hibafüggvényt (loss function) használ a modell tanítás közben — emlékezz a 14. lecke nn.MSELoss()-ára, ami regressziós hibafüggvény; osztályozáshoz másik típusú hibafüggvény kell (pl. "Cross-Entropy loss" — ezt majd akkor tanuljuk meg részletesen, amikor osztályozó modellt építünk).
Rész 3 — Algoritmus-családok, képlettel és példával
3.1 Lineáris regresszió (Linear Regression) — már ismered (12. lecke)
Képlet: y = w*x + b (y = kimenet, x = bemenet, w = meredekség/súly, b = kezdőpont/eltolás — a 14. leckében ugyanezt "weight" és "bias" néven is emlegettük)
Többváltozós változata (ha nem 1, hanem több bemeneted van, pl. km és évjárat és állapot együtt jósolja az árat): y = w1*x1 + w2*x2 + w3*x3 + ... + b
Mikor használd: ha a bemenet és kimenet kapcsolata nagyjából egyenes vonalú, és a feladat regresszió (számot jósolsz). Gyakorlati példa: lakásár becslése négyzetméter alapján, autó ára km alapján (amit már megcsináltunk), eladási előrejelzés marketingköltés alapján. Előnye: egyszerű, gyors, könnyen értelmezhető (látod is, mit jelent a w és b). Hátránya: ha a valós összefüggés görbe, nem tudja jól leírni (ezért kellett a 14. leckében a neurális háló).
3.2 Logisztikus regresszió (Logistic Regression) — új fogalom
Képlet: p = 1 / (1 + e^(-(w*x + b))) (ez a "szigmoid függvény" — bármilyen számot 0 és 1 közé "szorít össze", ez lesz a valószínűség)
Történeti okokból furcsa a név — a "logisztikus regresszió" valójában osztályozó algoritmus (a névben a "regresszió" arra utal, hogy a belső számítás ugyanaz a w*x+b lineáris képlet, mint a 3.1-ben, csak a végén egy szigmoid-lépéssel egy 0-1 közötti valószínűséggé alakítja, amiből aztán eldönti: "ha a valószínűség > 0.5, mondjuk igen-t, ha nem, nem-et.")
Mikor használd: ha a kimenet két kategória közül választ (bináris osztályozás) — pl. "ez az email spam vagy nem", "ez a páciens beteg vagy nem", "ez a vásárló vásárol vagy nem". Gyakorlati példa: hitelbírálat (visszafizeti-e a kölcsönt), orvosi szűrés (kockázatos-e vagy sem), email-spamszűrés.
3.3 Döntési fa (Decision Tree) — új fogalom
Nincs egyetlen képlet — a döntési fa egy sorozat egymás utáni igen/nem kérdést tesz fel az adatokról, amíg el nem jut egy válaszhoz. Olyan, mint egy "húsz kérdés" játék:
- km_futott < 50 000?
- igen → évjárat > 2020?
- igen → „drága kategória"
- nem → „közepes kategória"
- nem → „olcsó kategória"
- igen → évjárat > 2020?
Miért ilyen más ez, mint az előző kettő? A lineáris és logisztikus regresszió mindig egy sima, folytonos matematikai képletet számol. A döntési fa ezzel szemben lépcsőzetes, éles határokkal dolgozik — mint amikor Pythonban if/elif/else láncot építesz (emlékezz a 4. leckére!) — a döntési fa valójában pontosan ez: egymásba ágyazott if/else szabályok, amiket a gép maga talál ki az adatokból, ahelyett hogy neked kellene megírnod őket.
Mikor használd: ha fontos, hogy a modell döntése emberi szemmel követhető, magyarázható legyen (pl. orvosi vagy pénzügyi döntéseknél gyakran követelmény, hogy meg tudd indokolni, "miért utasította el a hitelt" — egy döntési fánál ez könnyen kiolvasható, egy neurális hálónál sokkal nehezebben). Gyakorlati példa: hitelbírálati rendszerek (ahol jogi követelmény a magyarázhatóság), orvosi diagnosztikai segédrendszerek, ügyfélszegmentálás.
Igen — a gyakorlatban egyetlen döntési fa helyett gyakran sok fát kombinálnak össze (pl. "Random Forest" vagy "Gradient Boosting", mint az XGBoost). Ezek az "együttes módszerek" (ensemble methods) általában pontosabbak, mint egyetlen fa, cserébe kicsit nehezebben magyarázhatók.
3.4 K-legközelebbi szomszéd (k-Nearest Neighbors, k-NN) — új fogalom
Nincs "tanítás" a hagyományos értelemben — a k-NN egyszerűen megjegyzi az összes tanító adatpontot, és amikor egy új adatpontról kell döntenie, megnézi: "melyik K darab tanító adatpont van hozzá legközelebb (távolság alapján)?", és azok többségi véleménye alapján dönt.
Távolság képlete (a legelterjedtebb, "euklideszi távolság" — ez pontosan az a Pitagorasz-tétel, amit iskolában tanultál): táv = négyzetgyök((x1-x2)² + (y1-y2)² + ...)
Ez olyan, mint amikor egy ingatlant az árazol, hogy megnézed, mennyiért kelt el a 3 leghasonlóbb, közeli lakás? Pontosan ez az elve! Ha egy autó árát akarod megbecsülni, a k-NN megnézi: "melyik 5 autó a leghasonlóbb (km, évjárat, állapot alapján) a tanító adatok közül?", és ezek árának átlagát adja becslésként — nincs mögötte képlet, ami "megtanult" valamit, csak egy okos "keresd meg a hasonlókat" logika.
Mikor használd: kisebb adathalmazoknál, ahol a "hasonló esetek hasonlóan viselkednek" feltételezés ésszerű, és nem kritikus a sebesség (mert minden új becsléshez össze kell hasonlítani az összes tanító adattal — ez nagy adathalmaznál lassú). Gyakorlati példa: ajánlórendszerek egyszerű változatai ("akik ezt vették, ezt is szokták"), ingatlanárazás hasonló ingatlanok alapján, kézzel írott számjegyek felismerésének egyszerű kezdő-megoldásai.
3.5 K-középpont klaszterezés (k-Means Clustering) — új fogalom
Ez már felügyelet nélküli tanulás (nincs "helyes válasz" előre megadva) — a cél: az adatpontokat K darab csoportba (klaszterbe) rendezni úgy, hogy egy csoporton belül az adatpontok hasonlítsanak egymásra, a csoportok között pedig különbözzenek.
Működési elv (lépésről lépésre, a 12b lecke "próbálgatás + javítás" logikájával rokon):
- Véletlenszerűen kijelöl K darab "középpontot"
- Minden adatpontot a hozzá legközelebbi középponthoz sorol
- Minden csoportnál újraszámolja a középpontot (a csoportba tartozó pontok átlaga alapján)
- Ismétli a 2-3. lépést, amíg a középpontok már alig mozdulnak — ekkor a csoportosítás "stabilizálódott"
Mikor használd: amikor csoportokat akarsz felfedezni az adatokban, anélkül hogy előre tudnád, milyen csoportok léteznek. Gyakorlati példa: egy webáruház vásárlóinak automatikus csoportosítása vásárlási szokás vagy aktivitás alapján ("gyakori, kis értékű vásárlók" / "ritka, nagy értékű vásárlók" / "inaktív ügyfelek") — anélkül, hogy neked kellene kézzel kitalálnod ezeket a kategóriákat, a k-means megtalálja őket az adatokból.
Ez az egyik legnagyobb gyakorlati nehézség a k-means-nél: a K értékét neked kell megadnod előre, a modell nem találja ki magától, hány csoport van. A gyakorlatban többször lefuttatják különböző K-értékekkel, és valamilyen mérőszám segít eldönteni, melyik K adja a legértelmesebb csoportosítást.
3.6 Neurális háló / backpropagation — már ismered (14. lecke)
Képlet (a 14. lecke EgyszeruHalo-jának megfelelően, rétegenként): rejtett = ReLU(W1*x + b1) kimenet = W2*rejtett + b2
A tanítás algoritmusa ("backpropagation" — "hiba visszaterjesztés"): pontosan az az 5 lépéses ciklus, amit a 14. leckében megírtunk (predikció -> hiba -> zero_grad -> backward -> step) — a "backward()" hívás végzi a backpropagation számítást, ami a hibát visszafelé, rétegről rétegre terjeszti, hogy kiszámolja, melyik súlyt merre kell módosítani.
Mikor használd: amikor a bemenet-kimenet kapcsolat bonyolult, görbe, vagy a bemenet maga is bonyolult (kép, hang, szöveg) — olyan esetekben, ahol a fenti egyszerűbb algoritmusok (lineáris regresszió, döntési fa) már nem elég pontosak. Gyakorlati példa: képfelismerés, hangfelismerés, nyelvi modellek (ChatGPT, Claude) — összetett mintázatok, ahol egyszerű szabályokkal nem lehet jól leírni az összefüggést.
3.7 Konvolúciós háló (CNN — Convolutional Neural Network) — új fogalom
Ez a neurális háló egy specializált változata — kifejezetten képekhez (vagy rácsszerű adatokhoz) találták ki.
Miért nem elég a 14. lecke sima EgyszeruHalo-ja képekhez? Egy fénykép óriási mennyiségű számból áll (emlékezz a korábbi tenzor-diagramra: magasság × szélesség × színcsatorna — pl. egy 1000×1000 pixeles kép 3 000 000 számból áll!). Ha ezt a 14. lecke módján, minden pixelt külön bemenetként kezelnéd egy nn.Linear rétegben, astronomikusan sok paramétert kellene tanítani, és a modell nem venné észre, hogy egy "fül" vagy "szem" mintázata ugyanaz, akárhol is helyezkedik el a képen.
A CNN "konvolúciós szűrőket" (kis, néhány pixeles "ablakokat") csúsztat végig a kép egészén, és mindenhol ugyanazt a mintázatot keresi (pl. "van-e itt egy él, egy sarok, egy kör?") — ezért sokkal kevesebb paramétert igényel, és felismeri a mintázatot függetlenül attól, hogy a kép melyik részén van.
Mikor használd: képfelismerés, objektumdetektálás, bármilyen feladat, ahol a bemenet kép vagy képszerű (rácsos) adat. Gyakorlati példa: arcfelismerés, orvosi képek elemzése (röntgen, MRI), önvezető autók "látása" — de akár egy javítószolgáltatás weboldalán egy "töltsd fel a hibás alkatrész fotóját, és az AI beazonosítja" funkció alapja is lehet.
3.8 Visszacsatoló háló / LSTM (RNN, LSTM) — új fogalom
Ez a neurális háló egy másik specializált változata — sorozatokhoz (idősorokhoz, szöveghez) találták ki, ahol a sorrend számít.
Miért nem elég a sima neurális háló szöveghez vagy időbeli adathoz? A 14. lecke EgyszeruHalo-ja egy "pillanatfelvételt" néz — nincs beépített "emlékezete" arról, mi történt korábban. De egy mondatban ("A macska leugrott A_____") a következő szó megjóslásához emlékezned kell az előző szavakra — az RNN/LSTM pontosan ezt csinálja: minden lépésnél egy "belső memóriát" is továbbad a következő lépésnek, hogy a korábbi kontextus ne vesszen el.
(Ma a gyakorlatban az RNN/LSTM helyett egyre inkább a 3.9-ben leírt Transformer-architektúrát használják, de fontos ismerned a fogalmat, mert sok régebbi és ma is élő rendszer erre épül, és a "miért kell emlékezni a sorrendre" alapkérdés itt vált nyilvánvalóvá.)
Mikor használd (történetileg): szövegelemzés, időbeli előrejelzés (pl. tőzsdei árfolyam, időjárás), beszédfelismerés — bármi, ahol a sorrend hordoz információt. Gyakorlati példa: gépi fordítás korábbi generációi, egyszerűbb chatbotok, forgalmi előrejelzés.
3.9 Transformer / figyelem-mechanizmus (Attention) — új fogalom
Ez az architektúra áll a mai nagy nyelvi modellek (ChatGPT, Claude, és a legtöbb modern AI-rendszer) mögött.
Mi az az 'attention' (figyelem), miért olyan fontos áttörés? Az RNN/LSTM (3.8) sorban, egyenként dolgozza fel a szavakat — ez lassú, és a "memória" hosszú mondatoknál elhalványul (a modell "elfelejti" a mondat elejét, mire a végére ér). A Transformer áttörése: az "attention" mechanizmus lehetővé teszi, hogy a modell egy mondat minden szavát egyszerre, párhuzamosan nézze, és kiszámolja, melyik szó mennyire fontos (mennyi "figyelmet" érdemel) a többi szó megértéséhez — függetlenül attól, milyen messze van egymástól a mondatban.
Egyszerűsített példa: a "A kutya, ami tegnap a kertben futkosott, éhes volt" mondatban a modellnek a "volt" szónál "vissza kell figyelnie" egészen a "kutya" szóra, hiába van köztük sok más szó — az attention-mechanizmus ezt a "hosszú távú odafigyelést" teszi lehetővé, matematikailag kiszámolt "súlyokkal" (mennyire fontos az adott szó a másikhoz képest).
Ez az, ami lehetővé teszi, hogy egy nagy nyelvi modell egész bekezdéseket, dokumentumokat tudjon "egyszerre átlátni", és koherens, hosszú válaszokat generáljon — miközben mindvégig ugyanaz a 12b leckében tanult alapelv (statisztikai mintaillesztés, próbálgatás + hibajavítás a tanítás során) működik a motorháztető alatt, csak sokkal nagyobb léptékben és ezzel az attention-trükkel kiegészítve.
A mai nagy nyelvi modellek (mint a GPT-család vagy a Claude) tipikusan az eredeti Transformer "dekóder" felét használják, szöveget mindig balról jobbra, szóról szóra generálva. A teljes, kódoló-dekódoló Transformer inkább fordításnál vagy más, bemenet-kimenet párokat kezelő feladatoknál maradt hasznos.
Mikor használd: gyakorlatban ma már ritkán építesz Transformert nulláról — inkább már betanított, kész modelleket (pl. GPT, BERT, vagy nyílt forráskódú modellek) használsz, és azokat "finomhangolod" (fine-tuning) a saját adataidra. Ez egy későbbi lecke témája lesz, amikor eljutunk odáig. Gyakorlati példa: nyelvi modellek (ChatGPT, Claude), gépi fordítás mai generációja, kép-generáló AI-k szöveges leírás értelmezése (pl. "rajzolj egy naplementét" -> a modell érti a mondat szavainak egymáshoz való viszonyát az attention miatt).
Rész 4 — Összefoglaló táblázat: melyiket mikor?
| Algoritmus | Típus | Mikor használd |
|---|---|---|
| Lineáris regresszió | Regresszió | Egyenes vonalú összefüggés, szám a kimenet |
| Logisztikus regresszió | Osztályozás | Két kategória közül választ |
| Döntési fa | Mindkettő | Magyarázhatóság fontos |
| k-NN | Mindkettő | Kis adathalmaz, "hasonlók hasonlóan viselkednek" |
| k-means | Felügyelet nélküli | Csoportok felfedezése, nincs előre címke |
| Neurális háló (14. lecke) | Mindkettő | Görbe, bonyolult mintázat |
| CNN | Mindkettő | Kép/rácsos adat |
| RNN/LSTM | Mindkettő | Sorozat, ahol a sorrend számít (történetileg) |
| Transformer | Mindkettő | Szöveg, nyelv, mai nagy AI-modellek alapja |
Ez a táblázat nem végleges és nem kizárólagos — a valóságban sokszor több algoritmust is ki lehet próbálni ugyanarra a problémára, és méréssel (a 12. lecke .score()-jához hasonló módon) derül ki, melyik teljesít jobban a te konkrét adataidon. Az AI-fejlesztői munka nagy része pont ez: kipróbálás, mérés, összehasonlítás — nem "tudod fejből, melyik a legjobb", hanem "meg tudod indokolt módon vizsgálni, melyik illik a feladatra."
- Gondolj egy általad ismert vállalkozás (pl. egy webáruház, egy szerviz vagy egy iskola) adataira (nem kell ténylegesen megcsinálnod): tudnál mondani egy-egy példát, ami regressziós feladat lenne, és egyet, ami osztályozás lenne?
- A 3.4-es k-NN leírása alapján: mi történne, ha egy 10 milliós adatbázisban akarnál k-NN-nel becslést adni? Miért lenne ez problémás sebesség szempontjából, a lineáris regresszióhoz képest (ami egyszer "megtanul", utána egy egyszerű képlettel azonnal válaszol)?
- Gondolkodj el: a döntési fa (3.3) és a neurális háló (3.6) közül melyiket választanád egy olyan rendszerhez, ahol jogszabály írja elő, hogy minden elutasított döntést meg kell tudni magyarázni az ügyfélnek? Miért?
Források és további olvasnivaló
A lecke témájának hivatalos dokumentációi és alapvető cikkei:
• scikit-learn — döntési fák — scikit-learn.org
• scikit-learn — klaszterezés — scikit-learn.org