Kiegészítő lecke
A deriválás, a legalsó szintű alapoktól
Mi az a derivált, miért létezik, hogyan számoljuk kézzel, és miért pont ez hajtja a gépi tanulást
A gépi tanulás motorja a deriválás: ez mondja meg a modellnek, merre változtassa a paramétereit, hogy csökkenjen a hiba. Ez a lecke a legalapabb szintről építi fel a fogalmat: a változás sebességétől és a függvénygrafikontól a határértéken át a deriválási szabályokig, Python-kóddal, egy rövid történeti kitérővel, és azzal, hogyan használja mindezt pontosan egy AI-modell.
- Mi az a "változás sebessége"? (a probléma, amit a derivált megold)
- A függvény, mint "számológép", és a grafikon, mint kép
- A határérték: A deriválás matematikai "motorja"
- A deriválás szabályai: hogyan számoljuk kézzel, pontosan
- Gyakorlati deriválási szabályok
- Python kód: numerikus közelítés és pontos derivált összehasonlítása
- Hogyan jöttek rá? Rövid történeti háttér
- Mire használja ezt az AI, pontosan? (összekötés a 12b és 13. leckével)
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 8 rész · 6 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Ez a lecke a 12b leckében ("hőmérő-hasonlat") és a 13. leckében (requires_grad, .backward()) használt fogalmat magyarázza el teljesen a nulláról — mert ott elfogadtuk, hogy "a derivált megmondja, merre kell módosítani", de sosem építettük fel magát a deriválást, lépésről lépésre. Ez a lecke pontosan ezt pótolja.
Miért éri meg egyáltalán foglalkozni ezzel, ha a PyTorch úgyis automatikusan kiszámolja (.backward())? Mert a 14. leckében látott 5 soros tanítási ciklus (predikció, hiba, zero_grad, backward, step) addig marad "varázslat" a számodra, amíg nem érted, mi történik a backward() hívás belsejében. Ha érted a deriválást, a teljes AI-tanulási folyamat átlátszóvá válik — nem kell "elhinned", hogy működik, látni fogod, miért működik.
Rész 1 — Mi az a "változás sebessége"? (a probléma, amit a derivált megold)
Kezdjük egy hétköznapi példával, matematika nélkül.
Képzeld el, hogy egy autóval mész az úton, és van egy kilométerórád, ami folyamatosan méri a megtett távolságot az indulás óta eltelt idő függvényében:
| Idő (perc) | Megtett táv (km) |
|---|---|
| 0 | 0 |
| 1 | 1 |
| 2 | 2 |
| 3 | 3 |
Itt könnyű a kérdés: "milyen gyorsan mész?" — mert minden percben pontosan 1 km-t teszel meg, tehát a sebességed állandóan 1 km/perc (60 km/óra).
De mi van, ha a táv nem egyenletesen nő? Pl.:
| Idő (perc) | Megtett táv (km) |
|---|---|
| 0 | 0 |
| 1 | 1 |
| 2 | 4 |
| 3 | 9 |
Itt az 1. és 2. perc között 3 km-t tettél meg (4-1=3), a 2. és 3. perc között pedig 5 km-t (9-4=5) — egyre gyorsabban mész! A kérdés: "pontosan milyen gyorsan mentél a 2. perc pillanatában (nem egy időszakban, hanem egyetlen, pontos pillanatban)?"
Ez a kérdés az, amire a deriválás válaszol: "mekkora a változás sebessége egy függvényben, egy adott pontban, pontosan?"
Miért nem elég egyszerűen kivonni két szomszédos értéket, ahogy fentebb csináltuk? Mert az "1. és 2. perc közötti átlagsebesség" nem ugyanaz, mint "a sebesség pontosan a 2. percben". Az átlag egy időszakra vonatkozik (1 egész percre), de a "pontos, adott pillanatbeli" sebesség egy végtelenül rövid pillanatra vonatkozik — ez a különbség vezet el a "határérték" fogalmához, ami a deriválás matematikai alapja (lásd rész 3).
Rész 2 — A függvény, mint "számológép", és a grafikon, mint kép
Mielőtt a deriválás képletéhez érnénk, tisztázzuk, mi az a "függvény" ebben a kontextusban (a 7. leckéből ismered a Python függvényt — ez rokon fogalom, de itt matematikai értelemben használjuk).
Egy matematikai függvény, pl.:
Egy szabály: "bármilyen x számot kapok, emeld négyzetre, és add vissza az eredményt." Ha x=2, akkor f(2) = 4. Ha x=3, akkor f(3) = 9. Pontosan ez volt a fenti táblázatunk (idő -> táv), csak most "x"-nek és "f(x)"-nek hívjuk az időt és a távot.
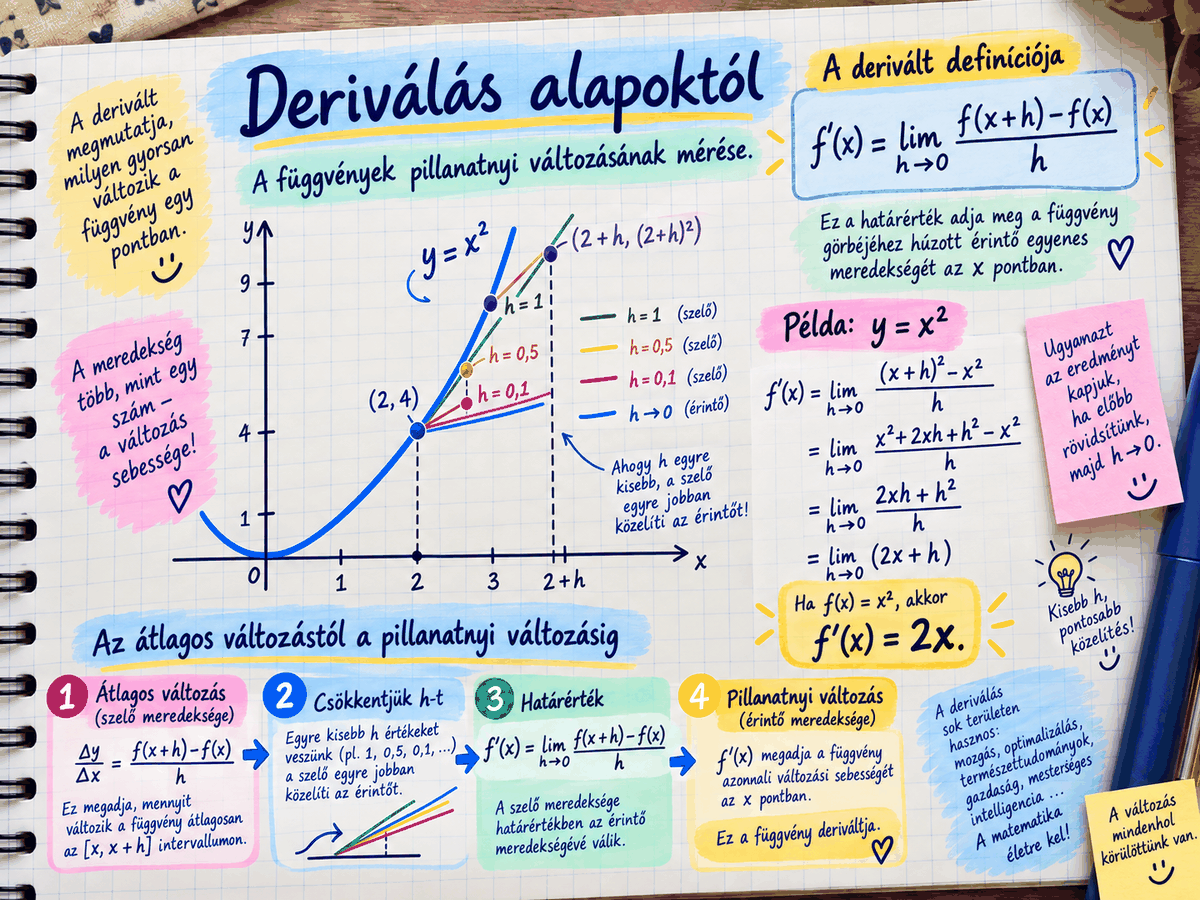
Ha ezt a függvényt lerajzolod (x vízszintes tengely, f(x) függőleges tengely), egy parabolát kapsz — egy görbe vonalat, ami x=0-nál a legalacsonyabb, és mindkét irányba egyre meredekebben emelkedik.
Mert a derivált geometriai jelentése (amit később, rész 4-ben pontosan levezetünk): a derivált egy adott pontban megadja az érintő egyenes meredekségét abban a pontban — vagyis "milyen meredeken emelkedik/csökken a görbe pontosan ott." Ez ugyanaz a "meredekség" fogalom, amit a 12. leckében a lineáris regresszió "w" (súly) paraméterénél már használtunk — csak ott az egész egyenesnek volt egy állandó meredeksége, itt egy görbének pontonként változó meredeksége van, és a derivált ezt a pontonkénti meredekséget számolja ki.
Rész 3 — A határérték: A deriválás matematikai "motorja"
Térjünk vissza az autós példához. Az "átlagsebesség két pont között" képlete:
Ezt matematikai jelöléssel, a f(x) = x² függvényünkre alkalmazva, x=2 körül:
ahol "h" a két pont közötti távolság (az autós példában ez volt az 1 perc), "x" pedig a pont, ahol a pontos sebességet keressük (nálunk x=2).
Számoljuk ki konkrétan, x=2-nél, különböző h értékekkel — figyeld meg, mi történik, ahogy h egyre kisebb lesz:
| h értéke | Számítás | Közelített derivált |
|---|---|---|
| 1 | (f(3) − f(2)) / 1 = (9 − 4) / 1 | 5,0 |
| 0,1 | (f(2,1) − f(2)) / 0,1 = (4,41 − 4) / 0,1 | 4,1 |
| 0,01 | (f(2,01) − f(2)) / 0,01 | 4,01 |
| 0,001 | (f(2,001) − f(2)) / 0,001 | 4,001 |
Látod a mintázatot? Ahogy "h" egyre közelebb kerül 0-hoz, az eredmény egyre közelebb kerül pontosan 4-hez. Soha nem érjük el a h=0-t (mert 0-val nem lehet osztani — emlékezz, ez egy matematikai tilalom), de a sorozat egyértelműen 4 felé tart.
Nem feltétlenül — a számítógépek véges pontossággal tárolják a tizedes törteket, ezért ha h túlságosan kicsi, a kerekítési hibák miatt a közelítés paradox módon pontatlanabbá válhat, nem pontosabbá. Ez az egyik oka, amiért a valódi gépi tanulási rendszerek nem numerikus közelítéssel, hanem algebrai (automatikus) deriválással számolnak.
Ezt a "felé tartást" hívják határértéknek (limit), és pontosan ez a derivált matematikai definíciója:
(Az f'(x) jelölés — a betű mellett egy vessző — az "f deriváltja" kifejezés matematikai rövidítése.)
Ez pontosan olyan, mint amikor egy while ciklusban egyre kisebb lépésekkel közelítesz egy célhoz? Nagyon jó meglátás — ez majdnem pontosan az az elv, amit a Python kód alul (rész 5) be is mutat: numerikusan, egyre kisebb h értékekkel közelítve megmutatjuk, hogy az eredmény tényleg 4 felé tart. A "valódi" matematikai derivált a h -> 0 pontos, végtelen határértéke — ezt algebrai átalakítással (lásd rész 4) pontosan ki lehet számolni, nem csak közelíteni.
Rész 4 — A deriválás szabályai: hogyan számoljuk kézzel, pontosan
A rész 3-ban közelítettünk. Most levezetjük, pontosan miért lesz az f(x) = x² deriváltja minden x értéknél 2x.
Algebrai levezetés: ezt csak egyszer kell végigkövetned. Utána már a deriválási szabályokat használhatod.
Az x = 2 pontnál a numerikus közelítés 4,001 felé tartott. A pontos képlet szerint 2 · 2 = 4. A kettő egyezik.
Gyakorlati deriválási szabályok
Ezeket a szabályokat ezután közvetlenül használhatod; nem kell minden alkalommal a határértékes levezetést újra elvégezni.
1. Hatványszabály
Példa: f(x) = x³ → f′(x) = 3x².
Példa: f(x) = x → f′(x) = 1.
A 13. leckében x = 3 esetén az y = x² függvénynél x.grad = 6 lett. A szabály szerint 2x = 2 · 3 = 6.
2. Konstans szabálya
Ha egy érték nem függ x-től, akkor nem változik. A változás sebessége ezért 0.
3. Összeadás szabálya
Példa: f(x) = x² + 3x → f′(x) = 2x + 3.
4. Konstans szorzó szabálya
Példa: f(x) = 5x² → f′(x) = 5 · 2x = 10x.
5. Szorzatszabály
A szabály akkor kell, amikor két, x-től függő kifejezést szorzunk össze. A 13. leckében a PyTorch ezt a háttérben automatikusan alkalmazta.
6. Láncszabály
Példa: f(x) = (3x + 1)².
Külső derivált: 2(3x + 1). Belső derivált: 3.
A 14. lecke neurális hálója egymásba ágyazott függvényekből áll: kimenet = reteg2(aktivacio(reteg1(x))). Amikor a PyTorch meghívja a .backward() műveletet, rétegről rétegre visszafelé haladva a láncszabályt alkalmazza. Ezt nevezzük backpropagationnek, vagyis visszaterjesztésnek.
Rész 5 — Python kód: numerikus közelítés és pontos derivált összehasonlítása
def f(x):
    """A vizsgált függvényünk: f(x) = x^2"""
return x ** 2def derivalt_kozelites(f, x, h):
"""
Ez a RÉSZ 3-ban leírt numerikus közelítés Python-kódban:
(f(x+h) - f(x)) / h — minél kisebb a h, annál pontosabb a
közelítés a VALÓDI deriválthoz.
"""
return (f(x + h) - f(x)) / hdef derivalt_pontos(x):
"""
Ez a RÉSZ 4-ben KÉZZEL levezetett PONTOS szabály: f(x)=x^2
deriváltja f'(x) = 2x, algebrai levezetéssel, NEM közelítéssel.
"""
return 2 * xx_pont = 2.0
print("NUMERIKUS KÖZELÍTÉS, egyre kisebb h értékekkel:")
for h in [1, 0.1, 0.01, 0.001, 0.0001]:
    kozelites = derivalt_kozelites(f, x_pont, h)
print(f" h = {h:<8} -> közelített derivált: {kozelites:.6f}")print(f"\nPONTOS derivált (2x képlettel, x={x_pont}-nél): {derivalt_pontos(x_pont)}")Nem egészen — a fenti kód a "numerikus deriválás" módszerét mutatja (kis h-val közelít), ami lassú és pontatlansági hibákkal is járhat. A PyTorch (és a legtöbb modern könyvtár) az "automatikus deriválást" (autodiff) használja: a deriválási szabályokat, amiket a rész 4-ben tanultál, építi be a számítás minden lépésébe, így gyors és pontos eredményt ad, közelítés nélkül.
A numerikus közelítés egyre jobban megközelíti a pontos értéket, ahogy h csökken.
Rész 6 — Hogyan jöttek rá? Rövid történeti háttér
A deriválást (és általában a "differenciálszámítást") két tudós dolgozta ki egymástól függetlenül, majdnem egy időben, a 17. század végén:
- Isaac Newton (angol) — elsősorban fizikai kérdésekből indult: hogyan írható le pontosan egy mozgó test (pl. bolygó) sebessége és gyorsulása, egy adott pillanatban? Ez pontosan az az autós hasonlat, amivel ez a lecke kezdődött.
- Gottfried Wilhelm Leibniz (német) — elsősorban matematikai, elvont szemszögből közelített: hogyan lehet pontosan megragadni egy görbe "meredekségét" egy adott pontban? Tőle származik a ma is használt jelölésrendszer nagy része (pl. a "dx", "dy" jelölés, amit haladóbb anyagokban fogsz látni).
Mindketten ugyanarra a matematikai eszközre jutottak — mert ugyanazt az alapproblémát próbálták megoldani: "hogyan ragadható meg pontosan a változás pillanatnyi sebessége?" — ezért történetileg vita is volt köztük, ki "találta fel" előbb, de ma már tudjuk: egymástól függetlenül jutottak el ugyanahhoz a felismeréshez, mert a matematikai szükségszerűség odavezette mindkettőjüket.
Nem — ők kézzel, papíron dolgoztak, számítógép nélkül. Az, hogy ma egy neurális háló milliónyi deriváltat tud kiszámolni másodpercek alatt, kizárólag azért lehetséges, mert a számítógépek ugyanazokat az egyszerű algebrai szabályokat, amiket a rész 4-ben te is megtanultál, elképesztő sebességgel, ismételten képesek végrehajtani.
A gépi tanulás matematikai magja (a "gradiens ereszkedés", amit a 12b leckében megismertél) szó szerint Newton és Leibniz deriválás-fogalmát használja — csak amíg ők egy bolygó mozgását vagy egy görbe meredekségét számolták, addig a mai AI-fejlesztő egy hibafüggvény "meredekségét" számolja ki, hogy megtudja, merre módosítsa a modell paramétereit, hogy a hiba csökkenjen. Ugyanaz a matematikai eszköz, csak 300 évvel később, teljesen más problémára alkalmazva.
Rész 7 — Mire használja ezt az AI, pontosan? (összekötés a 12b és 13. leckével)
Most, hogy érted a deriválás mechanizmusát, nézzük meg pontosan, hogyan használja egy AI-modell tanítás közben.
1. Lépés: a modellnek van egy hibafüggvénye (a 14. lecke nn.Mseloss()-a) — ez egy szám, ami megmondja, mennyire téved a modell a jelenlegi paramétereivel.
2. Lépés: ezt a hibát tekinthetjük egy függvénynek, aminek a "bemenete" nem x, hanem a modell paraméterei (a súlyok, "w" értékek) — tehát: hiba(w) = mennyire téved a modell, ha a súlya éppen "w".
3. Lépés: ha kiszámoljuk a hiba(w) deriváltját (a hiba "meredekségét" a w tengely mentén, pontosan úgy, ahogy a rész 4-ben f(x)=x²-nél csináltuk), megtudjuk: "ha a w-t icipicit növelném, a hiba nőne vagy csökkenne?"
4. Lépés: ha a derivált pozitív (a hiba nőne, ha w nő), akkor a modell a w-t csökkenti. Ha a derivált negatív (a hiba csökkenne, ha w nő), a modell a w-t növeli. Ez pontosan a 12b lecke "hőmérő-hasonlata": "próbáljunk egy kicsit más beállítást, nézzük meg jobb-e, ha igen, menjünk arra tovább" — csak most már tudod, hogy ez a "nézzük meg jobb-e" lépés matematikailag a derivált előjelének (pozitív/negatív) kiszámolása, nem pedig találgatás.
5. Lépés: a 14. lecke optimalizalo.step() sora ezt a lépést hajtja végre — a derivált (gradiens) alapján, a "tanulási ráta" (lr) mértékében, módosítja a paramétert.
Miért hívják 'gradiensnek', nem egyszerűen 'deriváltnak', ha egyszer ugyanaz? Mert egy neurális hálónak nem csak egy paramétere van (mint a fenti f(x)=x² egyszerű példában), hanem sok ezer, sok millió paramétere egyszerre (minden nn.Linear réteg minden súlya). A "gradiens" azt jelenti: kiszámoljuk a deriváltat minden egyes paraméterre külön-külön, egyszerre, és ez a "sok derivált együtt" alkotja a gradienst — ami megmondja, melyik irányban (a sok-dimenziós paramétertérben) kell lépni ahhoz, hogy a hiba leggyorsabban csökkenjen. Ez pontosan az, amit a 13. leckében láttál: a=torch.tensor(...), b=torch.tensor(...) példában a.grad és b.grad egyszerre, külön-külön számolódott ki — ez a "gradiens" a két paraméterre.
1. Számold ki kézzel (papíron, a rész 4 hatványszabálya alapján) az f(x) = x³ deriváltját. Ellenőrizd a derivalt_kozelites() függvénnyel, x=5-nél (emlékezz: a 13. lecke gyakorlata szerint x³ deriváltja x=5-nél 75 kell legyen — most megértve, miért).
2. Számold ki kézzel az f(x) = 4x² + 2x + 7 deriváltját (használd az összeadás, konstans szorzó, és konstans szabályokat együtt). Ellenőrizd a derivalt_kozelites() függvénnyel egy általad választott x értéknél.
3. Új gyakorlat — kösd össze a 12b leckével: a josolj_megbizhatosaggal() függvényben nem volt szükség deriválásra, mert az egy már betanított modellt használt. De a model.fit(X, y) sor, ami a háttérben lefutott, pontosan a rész 7-ben leírt lépéseket hajtotta végre, csak a scikit-learn ezt automatikusan, láthatatlanul csinálta. Gondolkodj el rajta: te magad, ha most a papíron levezetett hatványszabállyal ellenőriznéd egy egyszerű (2 pontos) lineáris modell hibafüggvényének deriváltját, hogyan kezdenél neki? (Nem kell megoldanod — csak vázold fel a gondolatmenetet.)