15. lecke
Az első saját projekted: weboldal-látogatottság elemzése és előrejelzése
A nullától a betanított modellig
Itt végigviszel egy teljes, önálló AI-projektet az elejétől a végéig. Egy webáruház napi látogatottsági adataiból megjósolod a várható vásárlások számát: előállítod és megtisztítod az adatokat, PyTorch-tenzorrá alakítod őket, felépíted és betanítod a modellt, majd kiértékeled és megbízhatósági ellenőrzésnek veted alá. Minden lépésnél látod, melyik korábbi leckére épül.
- Az adatok előállítása (itt: magunk generáljuk, de egy valós projektben ez egy…
- Adattisztítás és ellenőrzés (11. lecke elvei alapján)
- Az adatok átalakítása PyTorch tenzorrá (10. és 13. lecke elvei alapján)
- A modell felépítése (14. lecke elvei alapján)
- A modell tanítása (12b, 13, 14. lecke elvei alapján)
- Értékelés: mennyire jó a modellünk? (12. lecke .score() elve, de itt kézzel…
- Megbízhatósági ellenőrzés (12b lecke elve alapján)
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 8 rész · 22 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Ez a lecke összerakja mindazt, amit az 1–14c. leckékben külön-külön tanultál — ez az első alkalom, hogy egy teljes, önálló AI-projektet végigviszel, elejétől a végéig, egyetlen fájlban.
A téma (szándékosan egy hétköznapi üzleti példa): van egy CSV-fájlod egy webáruház napi látogatottsági adataival (ami nagyon hasonló ahhoz, amit egy Google Analytics export adna), és a cél: megjósolni, egy adott napi látogatószám mellett, várhatóan hány vásárlás (konverzió) történik — ez egy valós, hasznos kérdés, amit bármelyik webáruház-tulajdonos feltesz.
Mert a cél nem az, hogy lenyűgözőbbnek tűnjön, hanem hogy valódi, végigvihető tapasztalatot szerezz a teljes munkafolyamatról (adat -> tisztítás -> modell -> tanítás -> értékelés -> felhasználás) — és ez a fajta "bemenetből várható eredményt jósolni" feladat számtalan hétköznapi üzleti helyzetben előkerülhet: mennyi bevétel várható X marketingköltségnél, mennyi szervizidő várható X típusú hibánál, stb. A módszertan ugyanaz marad, csak az adatok cserélődnek.
import pandas as pd
import torch
import torch.nn as nn
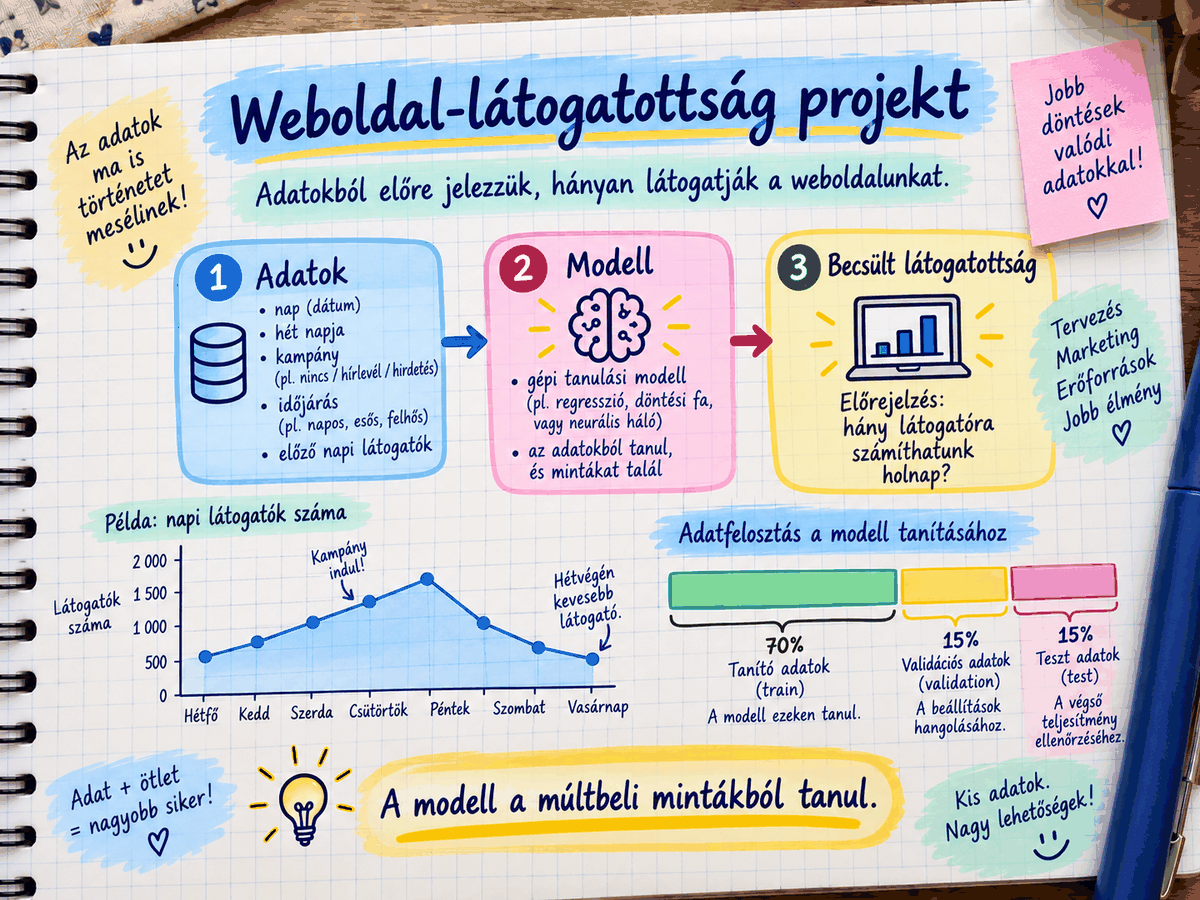
Lépés 1 — Az adatok előállítása (itt: magunk generáljuk, de egy valós projektben ez egy .CSV fájl lenne — lásd 8. és 11. lecke)
Miért nem egy valós CSV-fájlt töltünk be, ha egyszer a 8. és 11. leckében pont ezt tanultuk? Mert neked, a gyakorlás kedvéért, hasznosabb, ha pontosan tudod, honnan jönnek a számok (itt: mi magunk írjuk le őket) — így látható a kapcsolat a bemenet (látogatók) és kimenet (vásárlások) között, és utólag ellenőrizheted, hogy a modell tényleg megtanulta-e ezt a kapcsolatot. Az alján, a gyakorlás részben megtalálod, pontosan hogyan cserélnéd ezt valós, pd.read_csv()-vel betöltött adatra — a kód többi része egy betűt sem változna.
adatok = pd.DataFrame({
    "latogatok": [120, 250, 340, 410, 480, 90, 610, 730, 800, 150,
                  270, 390, 550, 640, 720, 200, 310, 460, 590, 680],
    "vasarlasok": [3, 7, 9, 12, 14, 2, 18, 21, 23, 4,
                   8, 11, 16, 19, 21, 5, 9, 13, 17, 20]
})Szándékosan úgy állítottuk össze az adatokat, hogy legyen bennük egy felismerhető, de nem tökéletesen egyenes mintázat (minél több a látogató, annál több a vásárlás — de nem pontosan arányosan, mert a valóságban is van egy kis "zaj", ingadozás), hogy a modellnek legyen mit tanulnia, és hogy lásd: a valós adatok soha nem tökéletesen "szép" egyenesek.
print("ELSŐ 5 SOR AZ ADATAINKBÓL:")
print(adatok.head())
print(f"\nÖsszesen {len(adatok)} nap adata áll rendelkezésre.\n")
Lépés 2 — Adattisztítás és ellenőrzés (11. lecke elvei alapján)
Ez itt most 'felesleges', hiszen tudjuk, hogy az adatunk tiszta (mi magunk írtuk le) — miért csináljuk mégis? Mert egy valós projektben ez sosem garantált — és rossz szokás lenne, ha "megúsznád" ezt a lépést csak azért, mert itt éppen nem szükséges. Az AI-fejlesztői fegyelem része, hogy mindig ellenőrzöd az adatot, mielőtt egy percet is a modellezésre fordítanál — emlékezz a 11. lecke NaN-problémájára: egyetlen hiányzó érték észrevétlenül tönkreteheti a teljes tanítást.
hianyzo_ertekek = adatok.isnull().sum().sum()
print(f"Hiányzó értékek száma az adatokban: {hianyzo_ertekek}")if hianyzo_ertekek > 0:
print("FIGYELEM: hiányzó adat található — tisztításra van szükség!")
adatok = adatok.dropna()
else:
print("Az adat tiszta, nincs hiányzó érték — mehetünk tovább.\n")Lépés 3 — Az adatok átalakítása PyTorch tenzorrá (10. és 13. lecke elvei alapján)
Miért kell a Pandas DataFrame-et 'lefordítani' PyTorch tenzorra, miért nem elég a DataFrame önmagában? Emlékezz: a Pandas (11. lecke) a human-barát adatkezelésre való (könnyű szűrni, rendezni, megérteni) — de a PyTorch (13-14. lecke) nem Pandas-szal, hanem tenzorokkal dolgozik, mert azok vannak felkészítve a GPU-gyorsításra és az automatikus deriválásra (autograd). Ez olyan, mint amikor egy Excel-táblát (Pandas) "exportálsz" egy programnak, ami csak egy speciális formátumot (tenzor) ért — a két eszköz más-más lépésben a leghasznosabb.
X = torch.tensor(adatok[["latogatok"]].values, dtype=torch.float32)
y = torch.tensor(adatok[["vasarlasok"]].values, dtype=torch.float32)
Mi az a .values, és miért kell a dtype=torch.float32? A .values "kicsomagolja" a Pandas DataFrame-ből a nyers NumPy tömböt (emlékezz a 10. lecke NumPy-Pandas kapcsolatára — a Pandas épp erre a NumPy-ra épül), amit a torch.tensor() már tud fogadni. A dtype=torch.float32 pedig a 13. leckéből ismert "szigorú típusosság" miatt kell: a Pandas alapból egész számokat (int) tárolt, de a PyTorch tanításhoz tizedestört (float) formátum szükséges a pontos deriváláshoz.
print(f"X (bemenet) alakja: {X.shape}")
print(f"y (kimenet) alakja: {y.shape}\n")
Lépés 4 — A modell felépítése (14. lecke elvei alapján)
class LatogatottsagModell(nn.Module):
    def __init__(self):
        super().__init__()
        self.reteg1 = nn.Linear(1, 16)   # 1 bemenet (látogatók) -> 16 rejtett érték
        self.aktivacio = nn.ReLU()       # nemlineáris "kapcsoló" (14. lecke)
self.reteg2 = nn.Linear(16, 1) # 16 rejtett érték -> 1 kimenet (vásárlások) def forward(self, x):
x = self.reteg1(x)
x = self.aktivacio(x)
x = self.reteg2(x)
return xMiért 16-ot választottunk a 14. lecke 8-as számával szemben? Emlékezz a 14. lecke 3. gyakorlófeladatára, ahol arra kérdeztünk rá: "a nagyobb szám mindig jobb modellt eredményez?" — a válasz: nem feltétlenül, de egy kicsit nagyobb "kapacitás" (itt: 16 a 8 helyett) néha segít összetettebb mintázatokat felismerni. Ez a te saját projektedhez tartozó döntés volt — ilyen "csavarok" hangolása (hiperparaméter-hangolás) a mindennapi AI-fejlesztői munka része, nem egyszeri "beállítás és kész" lépés.
Nincs egyetlen "helyes" szabály erre — a gyakorlatban gyakran egy kis számmal (pl. 8 vagy 16) kezdenek, megnézik, mennyire csökken a hiba, majd szükség szerint növelik vagy csökkentik, és összevetik az eredményt. Ez a fajta kísérletezés (hiperparaméter-keresés) teljesen normális, bevett gyakorlat, nem olyasmi, amit ki kellene találnod fejből.
model = LatogatottsagModell()
Lépés 5 — A modell tanítása (12b, 13, 14. lecke elvei alapján)
hibafuggveny = nn.MSELoss()
optimalizalo = torch.optim.SGD(model.parameters(), lr=0.00001)
print("TANÍTÁS FOLYAMATBAN...")
for korszak in range(2000):
    joslat = model(X)
hiba = hibafuggveny(joslat, y) optimalizalo.zero_grad()
hiba.backward()
optimalizalo.step() if korszak % 200 == 0:
print(f" Korszak {korszak:>4}, hiba: {hiba.item():.4f}")print("TANÍTÁS BEFEJEZVE.\n")Miért lr=0.00001, miért ilyen apró szám, a 14. lecke lr=0.0001-jéhez képest is? Ez pontosan a 14. lecke gyakorlás 2. pontjában felvetett probléma gyakorlati következménye: a mi adatunkban a bemenet (látogatók: akár 800-ig) és a kimenet (vásárlások: akár 23-ig) közötti skála nagyobb, mint a 14. lecke autós példájában — ha túl nagy tanulási rátát választanánk, a modell "túllövi" a célt (emlékezz a hőszabályzó-hasonlatra). Ez egy valós példa arra, hogy a tanulási ráta nem egyetlen "helyes" szám, hanem az adott adathoz kell igazítani — pontosan ez a "kísérletezéssel megtalálni" elv, amiről a 14. lecke széljegyzete beszélt.
Igen — a gyakorlatban gyakran nem a tanulási rátát csökkentik emiatt, hanem az adatokat "normalizálják" (pl. 0 és 1 közé skálázzák) betanítás előtt, hogy a bemenet és a kimenet hasonló nagyságrendű legyen. Ez sokszor stabilabb, gyorsabb tanítást eredményez, mint a nagyon apró tanulási ráta.
Lépés 6 — Értékelés: mennyire jó a modellünk? (12. lecke .score() elve, de itt kézzel kiszámolva)
A 12. leckében volt egy kész .score() metódus — itt miért nem használjuk? Mert a PyTorch (szemben a scikit-learn-nel) nem ad ilyen beépített "egy-gombnyomásos" értékelő függvényt — itt neked kell megírnod, pontosan azért, hogy tudd, mi történik a háttérben (a 12. lecke .score()-ja ugyanezt a fajta számítást végezte el, csak "elrejtve" előled).
with torch.no_grad():
    vegso_joslatok = model(X)
atlagos_elteres = torch.mean(torch.abs(vegso_joslatok - y)).item()print(f"A modell átlagosan {atlagos_elteres:.2f} vásárlással téved")
print("(minél KISEBB ez a szám, annál PONTOSABB a modell).\n")Mi az a torch.no_grad(), amit még nem láttunk? Emlékezz: a 13. leckében a requires_grad=True azt jelentette, hogy a PyTorch "figyeli" a számításokat, hogy később deriválni tudjon. De amikor már csak értékeljük a kész modellt (nem tanítjuk tovább), erre a "figyelésre" nincs szükség — felesleges számítási teherré válna. A "with torch.no_grad():" blokk ideiglenesen kikapcsolja ezt a "figyelést", gyorsabbá és memória-hatékonyabbá téve az értékelést. Ez egy tipikus, a gyakorlatban mindig használt "csomagolás" predikció/értékelés idejére.
Ebben a gyakorló projektben szándékosan ugyanazon a 20 napon értékeljük a modellt, amin tanítottuk — ez egyszerűsítés. Egy valós projektben az adatokat előre szét szokták választani "tanító" és "teszt" részre, és csak a modell által korábban nem látott teszt-adatokon mérik a pontosságot, mert így derül ki igazán, mennyire általánosít jól a modell új esetekre.
Lépés 7 — Megbízhatósági ellenőrzés (12b lecke elve alapján)
def joslas_megbizhatosaggal(uj_latogatoszam):
    """
    Ugyanaz az elv, mint a 12b lecke josolj_megbizhatosaggal()
    függvénye: megjósolja a vásárlások számát, ÉS figyelmeztet,
    ha a kérdezett érték kívül esik az ISMERT tartományon
    (extrapoláció veszélye).
    """
    latogatok_min = adatok["latogatok"].min()
latogatok_max = adatok["latogatok"].max() bemenet = torch.tensor([[float(uj_latogatoszam)]])
with torch.no_grad():
joslat = model(bemenet).item() print(f"Kérdezett látogatószám: {uj_latogatoszam}")
print(f"Becsült vásárlásszám: {joslat:.1f}") if uj_latogatoszam < latogatok_min or uj_latogatoszam > latogatok_max:
print(f"FIGYELEM: {uj_latogatoszam} látogató KÍVÜL esik az ismert")
print(f"tartományon ({latogatok_min}-{latogatok_max}) — a becslés")
print("megbízhatatlan lehet (extrapoláció)!")
else:
print(f"A {uj_latogatoszam} látogató az ismert tartományon")
print(f"({latogatok_min}-{latogatok_max}) belül van — megbízhatóbb becslés.")
print("-" * 55)print("PRÓBAKÉRDEZÉSEK A KÉSZ MODELLTŐL:")
joslas_megbizhatosaggal(350) # ismert tartományon belül
joslas_megbizhatosaggal(5000) # extrém extrapolációÖsszefoglalás — mit csináltunk, és melyik leckéből jött?
| Lépés | Melyik leckéből tanultad |
|---|---|
| Adat előállítása/betöltése | 6. lecke (dict), 8. és 11. lecke (CSV/pandas) |
| Adattisztítás, ellenőrzés | 11. lecke (NaN kezelés) |
| Tenzorrá alakítás | 10. lecke (NumPy), 13. lecke (tenzor) |
| Modell felépítése | 14. lecke (nn.Module, nn.Linear, ReLU) |
| Tanítás (a ciklus) | 12b lecke (elv), 13. lecke (autograd), 14c lecke (a matek mögötte), 14. lecke (kód) |
| Értékelés | 12. lecke (.score() elve, kézzel megírva) |
| Megbízhatósági ellenőrzés | 12b lecke (extrapoláció-védelem) |
Ez a táblázat az összes eddig tanult lecke "térképe" — ha érted, miért van itt minden lépés, és hogyan kapcsolódnak egymáshoz, akkor már nem csak "kódot másolsz", hanem érted egy teljes AI-projekt felépítését.
1. Futtasd le a teljes kódot, és nézd meg: az átlagos eltérés (lépés 6) hány vásárlás? Ha sokallod, próbáld meg növelni a korszakok számát (range(2000) helyett range(5000)) — javul-e?
2. Cseréld le a lépés 1 adatait a saját, valós CSV-fájlodra (pl. ha van Google Analytics vagy más statisztikai exportod) — ehhez csak ennyit kell módosítanod:
adatok = pd.read_csv("sajat_adataim.csv")
(Fontos: a CSV oszlopneveinek egyezniük kell a "latogatok"/"vasarlasok" nevekkel, vagy írd át a kód megfelelő részét az új oszlopnevekre — emlékezz a 11. leckére, ahol pontosan ezt gyakoroltad!)
3. Új, önálló projekt-ötlet — válassz egyet, és építsd fel ugyanezzel a 7 lépéses váz segítségével: a) Szerviz: bemenet = a hiba típusának "súlyossága" (egy általad kitalált 1-10 skálán), kimenet = várható javítási idő (órában) b) webáruház: bemenet = napi hirdetési költség (ezer Ft), kimenet = aznapi rendelések száma c) saját ötlet — bármi, amihez van (vagy kitalálható) egy "bemenet -> kimenet" számpáros adatsorod. Ez lesz a "saját projekted" — nincs "jó" vagy "rossz" választás, a lényeg, hogy végigvidd a teljes folyamatot.