16. lecke
Hogyan tanulnak a valós, éles AI-rendszerek?
Gyártósorok, ipari robotok, önvezető autók, hajók — a gyakorlatban
Eddig kis, kézzel épített modellekkel dolgoztunk. Ez a lecke áttekintő szinten megmutatja, hogyan működnek a valós, éles AI-rendszerek: a gyártósori minőségellenőrzés, az ipari robotkarok, az önvezető autók, valamint a hajók és drónok autonóm navigációja. Kiderül, hogy mindegyik ugyanarra a közös vázra épül, és miért nem egyetlen „nagy AI" irányít mindent, hanem sok, együttműködő modell.
- A közös váz: minden ipari AI-rendszer ugyanazt a 4 lépést követi (amit te már…
- Gyártósori minőségellenőrzés (CNN A gyakorlatban)
- Ipari robotkarok (megerősítéses tanulás a gyakorlatban)
- Önvezető autók (több modell együttműködése)
- Hajók és drónok autonóm navigációja
- A közös tanulság: miért nem "egy nagy AI" csinál mindent?
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 6 rész · 0 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Eddig egyetlen, egyszerű, kézzel épített modellel dolgoztunk (autó-ár, weboldal-látogatottság). Ez a lecke elvi, áttekintő szinten megmutatja: ugyanaz a 3-4 alapelv (amit már ismersz: adat -> mintázat -> tanítás -> döntés), hogyan skálázódik fel valódi, éles, sok millió forintos ipari rendszerekké.
Mert ha látod, hogy egy önvezető autó és a 15. lecke látogatottsági modellje ugyanazokból az elemekből épül fel (csak sokkal több adat, sokkal több réteg, sokkal komolyabb tesztelés), akkor megszűnik a "ez varázslat, amit csak nagy cégek értenek" érzés. Ez a fajta rendszerszintű látásmód az, ami egy kezdőből AI-tudatos szakembert csinál — még akkor is, ha te magad kisebb projekteken dolgozol.
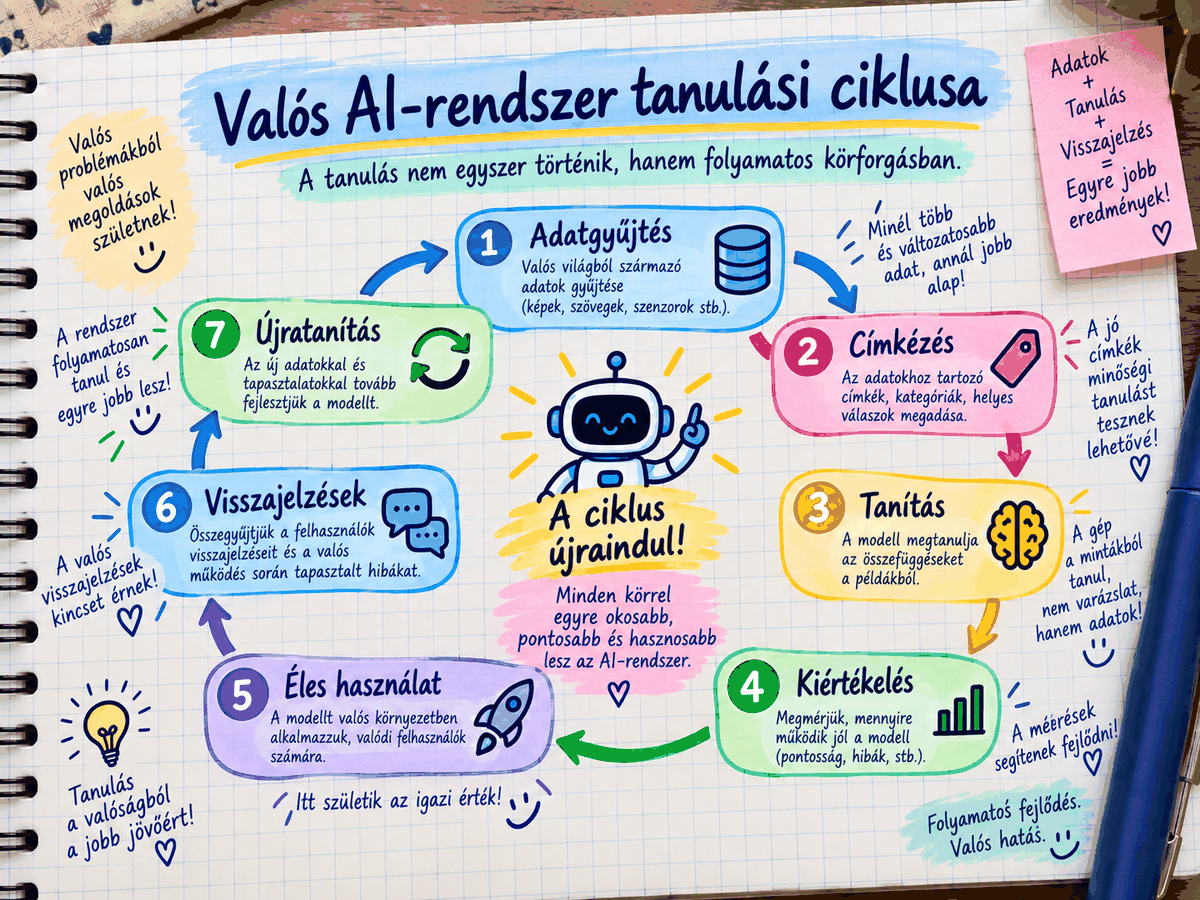
Rész 1 — A közös váz: minden ipari AI-rendszer ugyanazt a 4 lépést követi (amit te már ismersz)
Mielőtt a konkrét példákba mennénk, rögzítsük: a 15. leckében épített 7 lépéses váz (adat -> tisztítás -> modell -> tanítás -> értékelés -> megbízhatóság -> felhasználás) nem változik alapvetően, akármilyen nagy a rendszer. Csak egy-egy lépés válik sokkal bonyolultabbá:
1. Érzékelés (a te "adatod" — de itt élő, valós idejű): kamera, szenzor, mikrofon, radar, lézer (lidar) folyamatosan "önti" az adatot a rendszerbe.
2. Feldolgozás/értelmezés (a te "modelled" — de itt gyakran több modell együtt dolgozik): "mit látok/érzékelek pontosan?"
3. Döntés (a te "predikciód" — de itt a döntésnek azonnali, valós következménye van): "mit tegyek most, ebben a pillanatban?"
4. Beavatkozás (a te programodnál ez csak egy print() volt — itt egy motor, kar, kormány, fék ténylegesen mozog).
Ez a négy lépés ("érzékelés -> értelmezés -> döntés -> beavatkozás") a robotikában és önvezetésben "sense-think-act" ciklusnak hívott, alapvető minta — és ez szó szerint a te forward() függvényed (14. lecke) "kinagyítva" a valós világra.
Rész 2 — Gyártósori minőségellenőrzés (CNN A gyakorlatban)
A probléma: egy gyártósoron (pl. autóalkatrész-gyártásnál) emberi szemmel ellenőrizni minden egyes darabot lassú, drága, és az ember idővel fárad, hibázik. A cél: egy kamera + AI-rendszer másodpercek alatt eldöntse, "jó" vagy "selejtes" a termék.
Hogyan tanítják be: 1. Adatgyűjtés: hónapokon, éveken át gyűjtött fényképek mindkét kategóriából (jó termék / hibás termék) — minél több, minél változatosabb kép kell (különböző fényviszony, szög, hibatípus), hogy a modell általánosítani tudjon, ne csak "bemagolja" a konkrét képeket (ez a "túltanulás"/ overfitting fogalma — egy későbbi leckében részletezzük).
2. Modell: a 14b leckében megismert CNN (Konvolúciós háló) — pontosan azért, mert a "hiba" (egy karcolás, egy horpadás) a kép bármely részén felbukkanhat, és a CNN "mindenhol ugyanazt a mintázatot keresi" tulajdonsága (14b, rész 3.7) itt kulcsfontosságú.
3. Tanítás: pontosan ugyanaz az elv, mint a 14. leckében (predikció -> hiba -> backward -> step) — csak itt a "hiba" azt méri: "eltalálta-e a modell, hogy jó vagy selejtes a termék", milliónyi képen, órákig/napokig tartó számítógépes tanítással (gyakran több, drága GPU-n egyszerre, párhuzamosan — ez a "GPU-gyorsítás", amiről a 18. lecke Széljegyzete beszél majd).
4. Éles üzem: a betanított modell a gyártósoron minden áthaladó termékről fényképet készít, és milliszekundumok alatt dönt — ha "selejtes"-nek ítéli, egy mechanikus kar kiemeli a sorból (ez a rész 1 "beavatkozás" lépése).
Előnyök: 0-24 órás, fáradhatatlan, konzisztens ellenőrzés; emberi hibáknál (figyelemkiesés) megbízhatóbb lehet. Hátrányok/korlátok: ha a modell olyan hibatípust lát, amit a tanító adatok között soha nem látott (extrapoláció — emlékezz a 12b leckére!), átengedhet egy hibás terméket, vagy fordítva: egy jó terméket téveszthet selejtesnek (ez a "hamis pozitív", ami felesleges selejtezést, költséget okoz).
A valóságban a hibás termékek szinte mindig sokkal ritkábbak, mint a jók — ez az „osztályegyensúly-hiány” (class imbalance) problémája. Ha a tanító adatok 99%-a jó termék, a modell akkor is 99%-os „pontosságot” érhetne el úgy, hogy mindig csak azt mondja: „jó” — ezért a valódi rendszereknél külön figyelnek arra, hogy elég hibás példa is bekerüljön a tanításba.
Rész 3 — Ipari robotkarok (megerősítéses tanulás a gyakorlatban)
A probléma: egy robotkarnak meg kell tanulnia, hogyan fogjon meg, emeljen fel, és rakjon le tárgyakat — ez nem egy egyszerű "bemenet -> kimenet" feladat, mert a robotnak sorozatos döntéseket kell hoznia (hova mozgassa az ízületeit, milyen sorrendben), és a "jó mozgás" nem egyetlen lépésen, hanem a teljes mozgássorozaton múlik.
Ezért itt nem a felügyelt tanulás (12b, 14. lecke módszere) a fő eszköz, hanem a 14b lecke rész 1-ben megemlített megerősítéses tanulás (Reinforcement Learning):
1. A robot (a szakmában "ágens"-nek hívják) egy szimulált (számítógépes, virtuális) környezetben "próbálkozik" — sokkal biztonságosabb és olcsóbb, mint ha rögtön valós robottal, valós tárgyakkal próbálgatna (egy rossz mozdulat a valóságban eltörhet valamit, vagy kárt tehet).
2. Minden próbálkozás után a rendszer egy jutalom-számot kap: pl. "+10 pont, ha sikeresen felemelte a tárgyat", "-5 pont, ha leejtette", "-1 pont minden feleslegesen megtett mozdulatért" (hogy a hatékonyságra is ösztönözze).
3. A tanítás alapelve ugyanaz, mint amit a 12b/14c leckében tanultál: a rendszer "megnézi", melyik mozdulat-változtatás vezetett nagyobb jutalomhoz, és abba az irányba módosítja a "stratégiáját" — csak itt ez nem egyetlen, hanem hosszú, egymásra épülő döntéssorozatokra vonatkozik.
4. Milliónyi (néha milliárdnyi) szimulált próbálkozás után a megtanult stratégiát átviszik a valós robotra — ez a lépés ("sim-to-real transfer") az egyik legnehezebb rész, mert a valós világ soha nem egyezik tökéletesen a szimulációval (súrlódás, fényviszonyok, anyaghibák — apró eltérések, amik a valóságban problémát okozhatnak).
Az egyik legelterjedtebb módszer a „domain randomization”: a szimulációban szándékosan véletlenszerűen változtatják a fényviszonyokat, színeket, súrlódást és más apró paramétereket, amíg a robot meg nem tanulja, hogy ezekre ne legyen érzékeny. Így amikor a valós világ egy kicsit másképp „viselkedik”, mint a szimuláció, a modell már fel van rá készülve.
Előnyök: komplex, többlépéses feladatokat is meg tud tanulni, amiket nem lehetne egyszerű szabályokkal (if/else) leprogramozni. Hátrányok/korlátok: rengeteg szimulációs próbálkozás kell (drága számítási kapacitás); a "sim-to-real" szakadék miatt a valós teljesítmény gyakran rosszabb, mint a szimulációban mért; nehéz előre garantálni, hogy a robot minden helyzetben biztonságos marad (ezért ipari robotoknál továbbra is vannak kemény, szabályalapú biztonsági határok, amiket a tanult modell nem léphet át — pontosan úgy, ahogy a 12b lecke rész 6-ban a nyelvi modelleknél is szükség van külső, felülírhatatlan szabályokra).
Rész 4 — Önvezető autók (több modell együttműködése)
A probléma: egy önvezető autónak egyszerre kell: látni az utat, felismerni a jelzőtáblákat/gyalogosokat/más autókat, megjósolni, mit fognak tenni a környező autók/gyalogosok, és ennek alapján dönteni a kormányzásról, gázról, fékről — több tízszer másodpercenként.
Nem — és ez egy fontos tanulság: a gyakorlatban egy önvezető autó nem egyetlen "AI-agy", hanem több, egymással együttműködő, specializált modell "csővezetéke" (pipeline)
1. Érzékelés-fúzió: kamera + radar + lidar (lézeres távolságmérés) adatait együtt dolgozza fel — mindegyik szenzornak más az erőssége/gyengesége (pl. a kamera jól felismeri a színeket/feliratokat, de rossz látásban gyengébb; a radar ködben/esőben is jól működik, de kevésbé részletes kép ad) — a modellek együtt megbízhatóbbak, mint külön-külön.
2. Objektumfelismerés (CNN-alapú, mint a 14b lecke 3.7-e): "mi van a képen — autó, gyalogos, kerékpáros, tábla?"
3. Mozgás-előrejelzés: "ez a gyalogos valószínűleg át fog menni az úton — merre, mikor?" (ez gyakran a 14b lecke 3.8/3.9 Sorozat-alapú modelljeire épül, mert a mozgás sorrend-függő információ).
4. Útvonaltervezés és döntés: a fenti információk alapján dönt a konkrét kormányzásról/fékezésről — itt gyakran hagyományos, nem tanult, szabályalapú algoritmusok (pl. "sose lépd át ezt a biztonsági távolságot") egészítik ki a tanult modelleket, pontosan a megbízhatóság miatt.
Előnyök: potenciálisan gyorsabb reakcióidő, mint egy fáradt/figyelmetlen emberi vezetőé; konzisztens, nem szórakozik el. Hátrányok/korlátok: szélsőséges, ritka helyzetek ("edge case"-ek — pl. egy szokatlan tárgy az úton, amit a tanító adatok soha nem tartalmaztak) továbbra is problémát jelentenek — ez ugyanaz az extrapolációs probléma, amit a 12b leckében az autó-ár modellnél láttál, csak itt emberi életek a tét, ezért az iparág óriási erőforrást fordít a "hosszú farok" (ritka esetek) tesztelésére.
Sok önvezető-autó fejlesztő úgynevezett „árnyék módban” (shadow mode) is futtatja a rendszert: az AI valós vezetés közben folyamatosan meghozza a saját döntéseit, de nem avatkozik be — utólag csak összevetik, mit tett volna a tényleges emberi vezető döntésével. Így emberi felügyelet mellett, biztonságosan gyűjthető adat a ritka, szokatlan helyzetekről is.
Rész 5 — Hajók és drónok autonóm navigációja
A probléma: hasonló az önvezető autóhoz, de más a környezet — a nyílt tengeren/levegőben nincsenek kijelölt sávok, táblák, de vannak nemzetközi hajózási/repülési szabályok (pl. "melyik hajónak van elsőbbsége adott helyzetben").
Hogyan tér el az előzőektől:
- A "térkép" itt gyakran gps + tengeri/légi térképadatbázis (ismert akadályok, part, más útvonalak) — ez egy stabilabb, előre ismert adatforrás, mint egy városi út változó forgalma.
- A döntéshozatal gyakran hosszabb időtávra (percekre/órákra) tervez (pl. "kerüljük ki ezt a vihart"), nem csak milliszekundumos reakciókra — ez inkább a döntési fa/útvonaltervezés (14b lecke 3.3) és a hosszú-távú tervezési algoritmusok kombinációja, kevésbé a "azonnali reflex".
- A kommunikáció (más hajókkal/légi irányítással) szabályalapú protokollokra épül, amiket a tanult modell nem ír felül.
Előnyök: emberi fáradtság (hosszú tengeri utak) kiiktatása, üzemanyag-optimalizált útvonaltervezés. Hátrányok/korlátok: szélsőséges időjárás, váratlan tárgyak/hajótöröttek érzékelése továbbra is nehéz (megint az extrapolációs/ritka-eset probléma), és a jogi/felelősségi kérdések (ki felel egy autonóm hajó okozta balesetért) még nyitottak sok országban.
Rész 6 — A közös tanulság: miért nem "egy nagy AI" csinál mindent?
A lecke legfontosabb összefoglaló gondolata: Minden fenti példában ugyanaz a mintázat ismétlődik: a valós, éles rendszerek soha nem egyetlen, mindent tudó AI-ra épülnek, hanem több, specializált modell + hagyományos, szabályalapú biztonsági határok együttműködésére. Ez pontosan az az elv, amit a 12b lecke rész 6-ban (keretezés/manipulálhatóság) már megismertél: a tanult modellre önmagában nem lehet 100%-ban rábízni a döntést, ezért mindig kell melléje egy külső, felülírhatatlan védőréteg — legyen szó egy nyelvi modellről vagy egy önvezető autóról.
Ez az, amiért az "AI-fejlesztés" a gyakorlatban sokkal több, mint "modellt építeni és betanítani" — ide tartozik a rendszertervezés (melyik modell miért felelős), a biztonsági határok megtervezése, és a folyamatos tesztelés/monitorozás, amíg a rendszer élesben fut.
1. Válassz egyet a fenti 4 terület közül (gyártósor, robotkar, önvezető autó, hajó/drón), és írd le 3-4 mondatban, melyik a 14b leckében tanult algoritmus-család illene rá a legjobban, és miért (a 14b összefoglaló táblázata segít).
2. Gondolkodj el: egy általad ismert munkahelyen (pl. egy szervizben vagy egy raktárban) van-e olyan ismétlődő, sokszor elvégzett feladat (pl. bizonyos hibák felismerése egy eszközön), amit elvileg egy kamera + CNN rendszer (rész 2 mintájára) támogatni tudna? Nem kell megépítened — csak gondold végig, milyen adatokat kellene először összegyűjteni hozzá.
3. Új gyakorlat: nézd át még egyszer a rész 6 összefoglalóját, és kösd össze saját szavaiddal a 12b lecke rész 6 (keretezés/manipulálhatóság) tanulságával — miért ugyanaz a gyökér-probléma húzódik meg egy önvezető autó és egy nyelvi modell biztonsági kihívásai mögött is?