17. lecke
Hogyan épül fel egy nyelvi modell (mint a ChatGPT vagy a Claude)?
A nullától, lépésről lépésre — előnyök, hátrányok, korlátok
Hogyan lesz egy nyelvi modellből beszélgetni tudó rendszer? Ez a lecke lépésről lépésre végigvezet az úton: tokenizálás, embedding, a Transformer-architektúra és a figyelem (attention) mechanizmusa, az előtanítás és a finomhangolás. A végén azt is megnézzük, mik a nyelvi modellek erősségei, gyengeségei és korlátai.
- A kiindulópont: mi a cél, mielőtt egy sor kód is megszületne?
- Tokenizálás: szöveg -> számok
- Embedding: számokból "jelentés-vektorok"
- A transformer architektúra: attention + rétegek
- Előtanítás (pretraining): A "nyers" modell tanítása
- Finomhangolás (fine-tuning): "beszélgetőpartnerré" alakítás
- Előnyök, hátrányok, korlátok — pro és kontra
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 7 rész · 0 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Ez a lecke egyenes választ ad a kérdésre: "hogyan épül fel egy nyelvi modell, az első kódsortól a kész, beszélgetni tudó rendszerig?" — a 12b, 13, 14, 14b, 14c leckékben tanult minden alapelemet felhasználva, egyetlen, összefüggő történetté összerakva.
Mert a nyelvi modellek körüli leggyakoribb félreértés az, hogy "egyetlen lépésben" jönnek létre. A valóságban ez egy több, egymásra épülő szakaszból álló folyamat, ahol minden szakasz más célt szolgál — és ha érted ezt a sorrendet, meg fogod érteni, miért vannak korlátai, és miért nem "gondolkodik" úgy, ahogy egy ember.
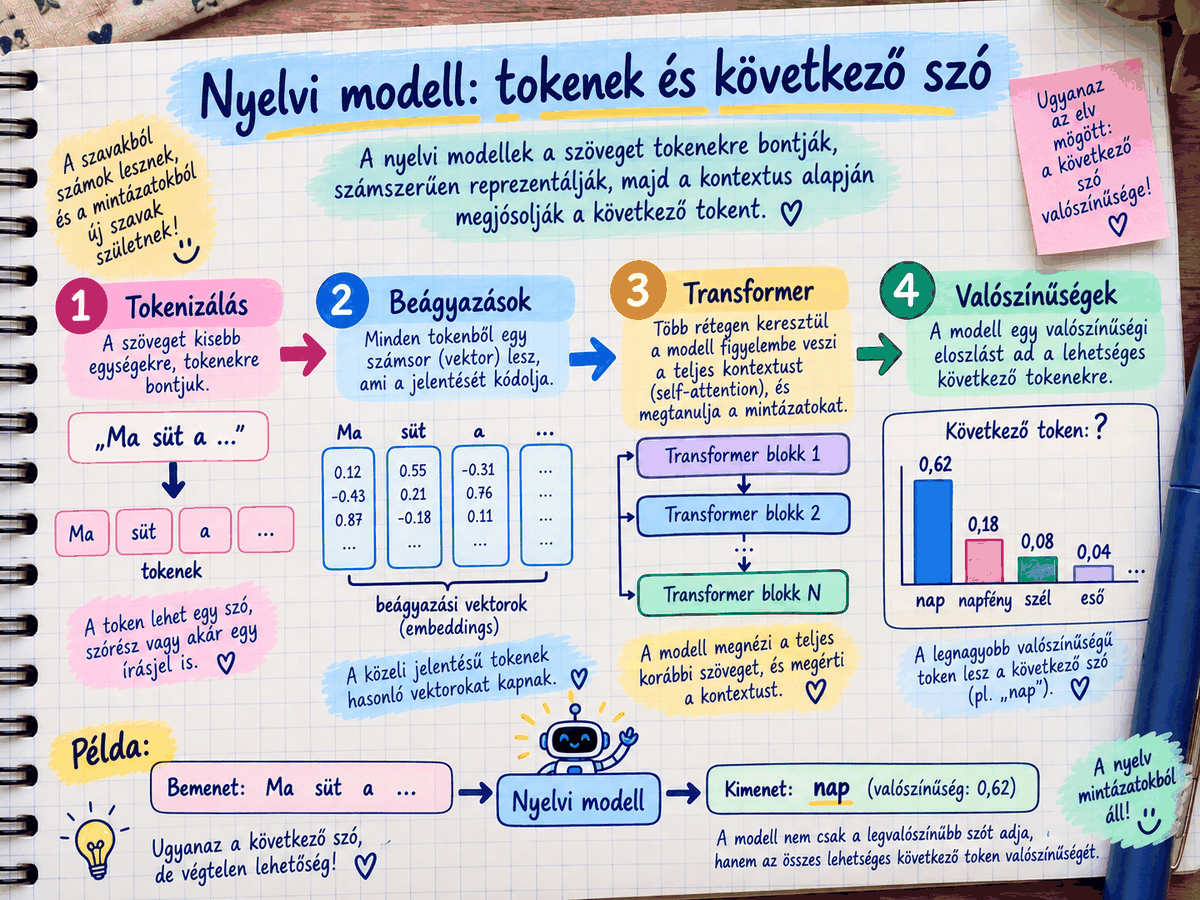
Lépés 0 — A kiindulópont: mi a cél, mielőtt egy sor kód is megszületne?
A cél: építeni egy rendszert, ami emberi szöveget kap bemenetként, és értelmes, hasznos emberi szöveget ad vissza kimenetként.
Ez ugyanaz a feladat, mint a 15. lecke weboldal-modellje, csak más bemenettel/kimenettel? Elvben igen — a 15. lecke modellje "szám -> szám" volt (látogatók -> vásárlások), egy nyelvi modell "szöveg -> szöveg" — de a probléma: a számítógép, a motorháztető alatt, csak számokkal tud dolgozni (emlékezz a 10-13. leckére: tenzorok, mátrixok — minden szám). Tehát az első, legalapvetőbb kérdés: "hogyan alakítunk szöveget számmá, úgy, hogy a jelentés ne vesszen el?" — ez az 1. Lépés témája.
Lépés 1 — Tokenizálás: szöveg -> számok
A nyers szöveget ("Szia, hogy vagy?") először apró darabkákra ("tokenekre") vágjuk — ezek nem mindig teljes szavak, gyakran szórészletek ("token"-ek lehetnek: "Szi", "a", ",", " hogy", " vagy", "?" — a pontos vágás a nyelvtől és a konkrét tokenizáló algoritmustól függ).
Miért nem egyszerűen szavanként vágjuk szét? Mert így a modellnek minden lehetséges szót külön kellene "ismernie" (egy nyelvben sok százezer szó van, és állandóan újak is keletkeznek), ez kezelhetetlenül sok lenne. A szórészletekre bontás (pl. "subword tokenization") azt jelenti, hogy a modell egy viszonylag kis készletből (párezer-pár tízezer tokenből) össze tudja rakni gyakorlatilag bármilyen szót — még az olyan szavakat is, amiket soha nem látott egyben, ha a darabjait már ismeri.
Minden egyes tokenhez egy szám (azonosító) tartozik — ez olyan, mint a 6. leckében tanult dictionary: "Szi" -> 4021, " hogy" -> 812, stb. Ez a "szótár" (vocabulary) a modell tanítása előtt elkészül, és a teljes tanítás/használat során változatlan marad.
Mivel a modell nem betűket, hanem tokeneket lát, gyakran nehezen old meg olyan feladatokat, mint egy szó betűinek megszámolása vagy egy szó pontos visszafelé leírása — hiszen a „szótár” tokenjei ritkán felelnek meg egy-egy betűnek. Ez az egyik oka annak, hogy a nyelvi modellek ilyen, embernek triviálisnak tűnő feladatokban időnként meglepően hibáznak.
Lépés 2 — Embedding: számokból "jelentés-vektorok"
Az 1. lépés számai (token-azonosítók) önmagukban nem hordoznak jelentést — a "4021"-es szám nem "közelebb" a "4022"-höz jelentésben, mint a "9981"-hez, ez csupán egy címke.
Az embedding lépés minden egyes tokent egy hosszú számsorozattá ("vektorrá") alakít — pl. egy 768 vagy 4096 elemű tenzorrá (emlékezz a 10-13. leckére: ez pontosan egy többdimenziós tömb).
Mi értelme van 768 számmal leírni egy szót? Ez a legfontosabb "trükk", amit érdemes megértened: a tanítás során (lásd lépés 4) a modell megtanulja úgy beállítani ezeket a számokat, hogy a hasonló jelentésű szavak vektorai egymáshoz közel kerüljenek ebben a "768-dimenziós térben" — pl. a "kutya" és a "macska" vektorai közelebb lesznek egymáshoz, mint a "kutya" és az "autó" vektorai, mert a modell a szövegkörnyezetből (milyen szavak mellett szoktak előfordulni) megtanulja ezt a hasonlóságot — ez ugyanaz a "tanulás próbálgatással" elv, amit a 12b leckében megismertél, csak itt a "paraméterek", amiket hangol, maguk a szó-vektorok.
Lépés 3 — A transformer architektúra: attention + rétegek
Emlékeztető a 14b leckéből (rész 3.9): a Transformer az "attention" (figyelem) mechanizmussal egyszerre, párhuzamosan nézi egy mondat minden szavát, és kiszámolja, melyik szó mennyire fontos a többi szó megértéséhez.
Ez itt, a nyelvi modell építésében, konkrétan így néz ki:
1. A lépés 2-ből kapott vektorok belépnek egy "Transformer blokkba" — ez strukturálisan hasonlít a 14. lecke EgyszeruHalo-jához (nn.Linear rétegek + aktivációs függvények), csak közéjük van ékelve az attention-számítás.
2. Az attention-számítás minden szóhoz "megkérdezi": "a mondat többi szava közül melyik segít a legtöbbet megérteni engem, ebben a konkrét szövegkörnyezetben?" — és ez alapján egy "súlyozott átlagot" készít a többi szó információjából.
3. Ezt a "Transformer blokkot" nem egyszer, hanem sokszor (a modell méretétől függően, akár 96-szor vagy többször) egymás után, rétegről rétegre ismétlik — minden réteg egyre elvontabb, összetettebb "megértést" épít fel az előző réteg eredményéből (hasonlóan ahhoz, ahogy a 14. lecke 2 rétege — reteg1 -> aktivacio -> reteg2 — egymásra épült, csak itt sokkal több rétegről van szó).
A gyakorlatban az attention-számítást nem egyszer, hanem több, párhuzamos „fejjel” (head) végzik egyszerre — mindegyik fej más típusú összefüggésre specializálódhat (pl. az egyik a nyelvtani kapcsolatokra, a másik a témára figyel). A rétegek végén ezeket a nézeteket összegzik, mielőtt a következő rétegbe kerülnének.
Nem "értés" a szó emberi értelmében — hanem egyre pontosabb statisztikai reprezentáció arról, "melyik szó mennyire függ össze melyikkel, ebben a konkrét szövegben." Ez a 12b lecke rész 3-ban (a "nagyon jó papagáj" hasonlat) már tisztázott különbségtétel — itt csak konkrétabban látod, mi történik a "papagáj fejében."
Lépés 4 — Előtanítás (pretraining): A "nyers" modell tanítása
Ez a leghosszabb, legdrágább szakasz. A feladat meglepően egyszerűnek hangzik: "az eddigi szöveg alapján, találd ki a következő tokent" (ezt hívják "next-token prediction"-nek).
Példa: a modell bemenetként kapja: "A macska leugrott a" — és a feladata: kitalálni, mi a legvalószínűbb következő token (pl. "kanapéról", "asztalról", stb.)
Ez pontosan az a tanítási ciklus, amit a 14. leckében megírtunk? Igen, szó szerint ugyanaz az 5 lépés (predikció -> hiba -> zero_grad -> backward -> step), csak: - a "predikció" itt nem egy szám, hanem egy valószínűségi eloszlás a szótár összes tokenjén (pl. "kanapéról": 40% valószínű, "asztalról": 25%, "Holdra": 0.0001% stb.) - a "hiba" azt méri, mennyire tért el ez az eloszlás a valós, ténylegesen következő tokentől (ez a "Cross-Entropy loss", amit a 14b lecke rész 2-ben említettünk, mint az osztályozáshoz illő hibafüggvényt — és ez pontosan az, hiszen "melyik a következő token" egy osztályozási feladat a szótár méretű kategóriaszámmal!) - a backward()/step() ugyanúgy a láncszabály (14c lecke) alapján, rétegről rétegre visszafelé frissíti a paramétereket — csak itt nem pár száz, hanem több milliárd, esetleg több száz milliárd paraméter egyszerre.
Ezt a folyamatot a modell elvégzi gyakorlatilag az internet jelentős részén (könyvek, weboldalak, cikkek — több billiónyi tokenen), sok ezer, speciális AI-chipen (GPU/tpu), gyakran hónapokig tartó, óriási energia- és pénzköltséggel.
Az eredmény ezen a ponton: egy "nyers" ("base") modell, ami nagyon jó abban, hogy statisztikailag folytassa a szöveget — de még nem "beszélgetőpartner": ha megkérdezed "Mi Franciaország fővárosa?", képes lenne akár egy további kérdéssel folytatni (mert a tanító adatok között sok ilyen kérdéslistát is látott), nem pedig feltétlenül válaszolni — mert arra még nem tanították kifejezetten.
A nyílt súlyú modelleknél gyakori, hogy a fejlesztők a nyers, előtanított („base”) modellt is elérhetővé teszik a finomhangolt („instruct” vagy „chat”) verzió mellett — kutatóknak és fejlesztőknek, akik saját maguk szeretnék testre szabni a finomhangolási lépést. Egy „base” modell tehát nem hibás vagy hiányos termék, hanem egy szándékosan korábbi, más célra szánt állapot.
Lépés 5 — Finomhangolás (fine-tuning): "beszélgetőpartnerré" alakítás
A lépés 4 "nyers" modellje most egy további, rövidebb, de célzottabb tanítási szakaszon megy át — ez alakítja át "szövegfolytatóból" hasznos asszisztenssé.
Ez több al-lépésből áll (a pontos módszer cégenként/modellenként eltér, de az alapelv hasonló):
1. Felügyelt finomhangolás (Supervised Fine-Tuning, sft): emberek írnak példa-párokat ("kérdés -> jó válasz"), és a modellt ezeken tovább tanítják, ugyanazzal az 5-lépéses ciklussal, mint a lépés 4-ben — csak sokkal kevesebb, de gondosabban válogatott adaton.
2. Visszajelzés-alapú finomhangolás (pl. "rlhf" — Reinforcement Learning from Human Feedback, vagy hasonló, újabb módszerek): emberek összehasonlítanak több modell-választ ("melyik a jobb válasz, A vagy B?"), és ez a visszajelzés egy további tanítási jelként szolgál — ez a 16. lecke rész 3-ban (megerősítéses tanulás) tanult elv alkalmazása, csak itt az "ágens" a nyelvi modell, a "jutalom" pedig az emberi preferencia.
3. Biztonsági tanítás: külön figyelmet fordítanak arra, hogy a modell felismerje és visszautasítsa a káros kéréseket — ez pontosan az a téma, amit a 12b lecke rész 6-ban (keretezés/manipulálhatóság) érintettünk: mivel a nyers modell önmagában nem megbízható ebben, ezt a viselkedést kifejezetten, külön tanítják be, és emellett külső, szabályalapú védelmi rétegeket is építenek a rendszer köré.
Ezután a modell kész arra, hogy élesben, felhasználók számára elérhető legyen — de a tanítás/fejlesztés a gyakorlatban soha nem áll meg teljesen (folyamatos mérés, hibajavítás, új verziók).
Rész 6 — Előnyök, hátrányok, korlátok — pro és kontra
Előnyök: + képes széles körű, általános tudást "megtanulni" egyetlen, egységes rendszerben (nem kell külön modellt írni minden egyes témára). + természetes nyelven kommunikál — nem kell programozási nyelvet vagy szigorú formátumot ismerni a használatához. + gyors: másodpercek alatt ad választ olyan kérdésekre, amik embernek órákig/napokig tartó kutatást igényelnének. + skálázható: egyszerre, párhuzamosan milliók számára tud "beszélgetni", amíg egy emberi szakértő egyszerre csak korlátozott számú emberrel tud foglalkozni.
Hátrányok/korlátok (egyenként visszakötve a korábbi leckékhez):
- Hallucináció (12b lecke, rész 4): nincs beépített "valóság-ellenőrzés" — ha a tanító adatok hiányosak/ pontatlanok egy témában, a modell magabiztosan kitalálhat valamit.
- Keretezés/manipulálhatóság (12b lecke, rész 6): a modell a szöveg logikáját követi, nem feltétlenül a valós tényeket — ez külső védelmi rétegeket tesz szükségessé.
- Rögzített tudás-határ ("knowledge cutoff"): a lépés 4 (előtanítás) egy adott időpontig gyűjtött adatokon történik — a modell önmagában nem tud az azután történt eseményekről (külön, frissített adatforrás — pl. webes keresés — kell a friss információhoz).
- Kontextusablak korlátja: a modell egyszerre csak egy bizonyos mennyiségű szöveget tud "figyelembe venni" (a lépés 3 attention-számítása erőforrás-igényes, ez korlátozza, mennyi szöveget tud egyszerre "átlátni").
- Elfogultság (bias): mivel a tanító adat emberek által írt szöveg, a modell örökölheti az abban jelen lévő társadalmi előítéleteket/egyenlőtlenségeket — ezt a lépés 5 finomhangolás részben csökkenti, de teljesen nem szünteti meg.
- Nem "érti" a világot úgy, mint egy ember: nincs teste, nincs érzékelése, nincs valódi tapasztalata — minden "tudása" szöveges mintázatokból származik (ez a 12b lecke "nagyon jó papagáj" hasonlatának lényege).
- Költséges: a lépés 4 (előtanítás) sok millió dolláros nagyságrendű számítási költséget jelenthet a legnagyobb modelleknél — ez az egyik oka, hogy csak néhány nagy cég tudja építeni a legnagyobb modelleket nulláról (bár egyre több kisebb, nyílt modell is elérhető).
Van ebben valami titkos varázslat? A lecke záró gondolata: ha végiggondolod ezt az 5 lépést (tokenizálás -> embedding -> Transformer -> előtanítás -> finomhangolás), látni fogod, hogy egyetlen lépésben sincs titkos varázslat — minden lépés az 1-14c leckében már megismert alapelvek (mintázatkeresés, gradiens ereszkedés, láncszabály, rétegek egymásra építése) használata, csak sokkal nagyobb léptékben, több szakaszban, gondosan megtervezve. Ez a "nagyságrend-váltás" (a 15. lecke 20 sorából a valós nyelvi modellek több billió tokenjéig) az, ami lenyűgözővé, de ugyanakkor megérthetővé teszi a folyamatot.
1. Rajzold fel (papíron vagy egy egyszerű szövegdiagramban) az 5 lépést (tokenizálás, embedding, Transformer, előtanítás, finomhangolás), és mindegyik mellé írj oda egy korábbi leckét, ami a mechanizmus megértéséhez a legjobban kapcsolódik (pl. "előtanítás -> 14. lecke tanítási ciklusa").
2. Gondolkodj el: a lépés 5 "visszajelzés-alapú finomhangolás" részében emberek döntik el, "melyik válasz jobb" — mi történne, ha ezek az emberek mind ugyanazt a szempontot ("ez tetszik nekem") preferálnák, akkor is, ha az nem a legpontosabb/leghasznosabb válasz? Milyen kockázatot látsz ebben (kösd össze a 12b lecke rész 6 gondolatával)?
3. Új gyakorlat: sorold fel, a hátrányok/korlátok listájából, melyik 3 az, ami szerinted a legnagyobb kockázatot jelenti, ha egy AI-rendszert a te szakmai területeden (pl. ügyfélkommunikáció, oktatás, adminisztráció) használnál — és milyen védekezést (emberi ellenőrzés, tartomány-ellenőrzés, stb.) alkalmaznál ellenük, a 12b lecke rész 5 mintájára.