18. lecke
Adatközpontok: hogyan működnek, mennyi energia kell, és mik a feltételei?
A nyelvi modellek tanítása és futtatása óriási számítási kapacitást igényel — ez fizikailag adatközpontokban történik. A lecke bemutatja, mi az adatközpont, miért kell ennyi energia (számokkal), miért kell sok gép együttműködése a tanításhoz, miért olyan nehéz a hűtés, és milyen feltételek kellenek ahhoz, hogy valahol adatközpont épülhessen.
- Mi az az adatközpont (data center)? — az alapfogalom
- Miért kell annyi energia? Számokkal
- Miért kell "sok gép együtt" a tanításhoz? (párhuzamosítás)
- A hűtés problémája: miért ilyen nagy kihívás?
- További feltételek: hol építhető egy adatközpont?
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 6 rész · 0 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Amikor a 17. leckében arról volt szó, hogy egy nyelvi modell „hónapokig, sok ezer GPU-n" tanul — ez a lecke pontosan megmutatja, mit jelent ez a gyakorlatban: hol fut ez a számítás, milyen épületben, mennyi árammal, milyen feltételekkel.
Mert az AI nem "A felhőben" létezik valami elvont értelemben — minden egyes kérdésedre adott válasz (akár a ChatGPT-től, akár a Claude-tól) mögött egy konkrét, fizikai épületben, konkrét számítógépeken, konkrét áramfogyasztással futó számítás áll. Ha ezt nem érted, az AI "mágikusnak" tűnik — pedig egy mérnöki, fizikai infrastruktúra, aminek megvannak a saját korlátai, költségei, és feltételei, pontosan úgy, ahogy egy weboldalnak is kell egy szerver, amin fut — csak itt mindezt ezerszeresére kell nagyítani.
Rész 1 — Mi az az adatközpont (data center)? — az alapfogalom
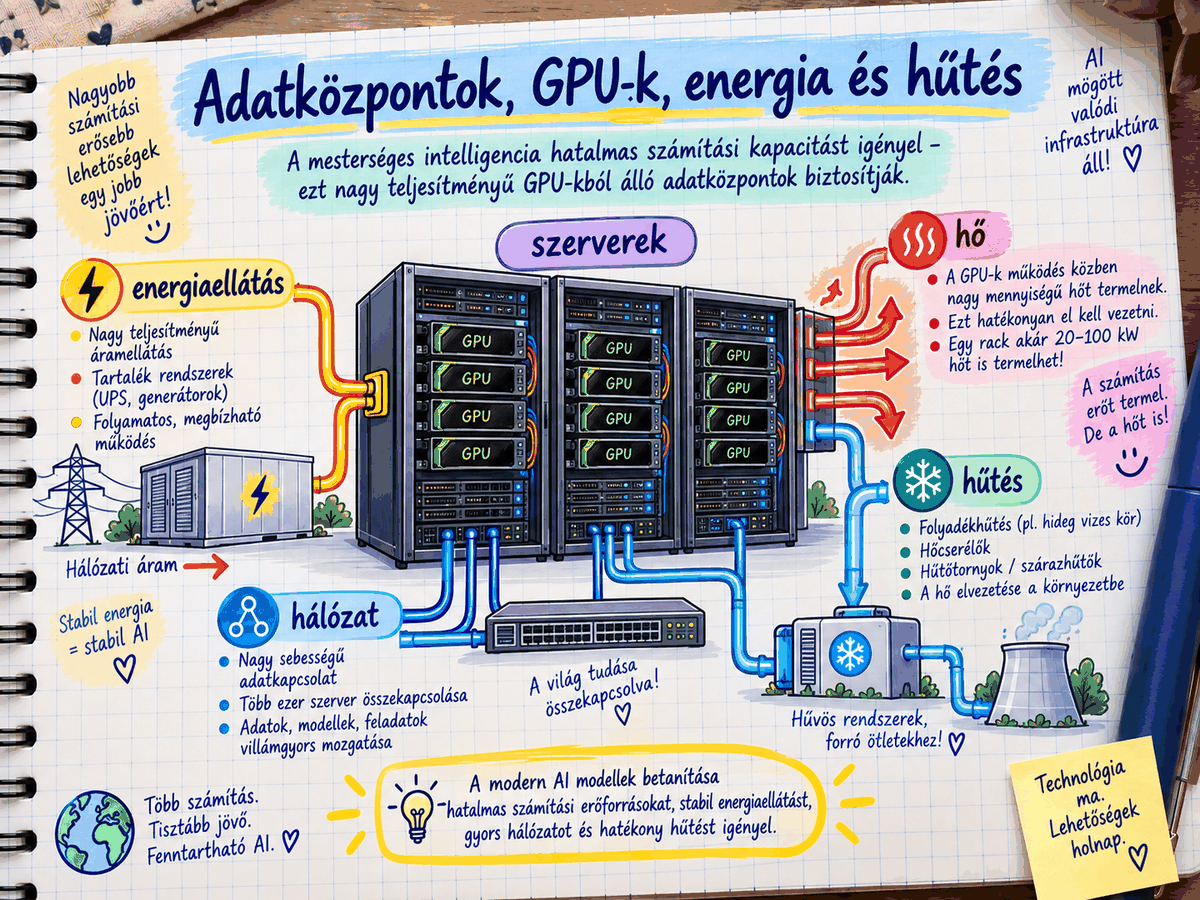
Egy adatközpont egy épület (vagy épületegyüttes), aminek egyetlen célja: nagy mennyiségű számítógépet (szervert) egy helyen, megbízhatóan, folyamatosan üzemeltetni.
Ez olyan, mint amikor egy weboldal egy tárhelyen fut — csak sokkal nagyobb? Pontosan ez — amikor egy weboldal egy tárhelyszolgáltatónál (pl. egy magyar tárhelycégnél) fut, annak szerverei is egy adatközpontban állnak. A különbség: egy weboldal viszonylag kis számítási igényű program, de egy AI-modell tanítása/futtatása ezerszer-milliószor nagyobb számítási teljesítményt igényel — ezért az AI-cégek (OpenAI, Anthropic, Google) nem "megosztott tárhelyet" bérelnek, hanem teljes adatközpontokat (vagy azok jelentős részét) építik/ bérlik kifejezetten erre a célra.
Egy adatközpont fő összetevői:
- Számítási egységek: a tényleges szerverek — AI-nál elsősorban GPU-k (Graphics Processing Unit — eredetileg számítógépes grafikához, játékokhoz fejlesztették, de kiderült: párhuzamos számításra — ami pont az, amit egy neurális háló igényel — sokkal jobbak, mint a hagyományos CPU-k) vagy specializált AI-chipek (pl. Google tpu — Tensor Processing Unit, kifejezetten AI-számításra tervezve).
- Hálózat: a sok ezer GPU-nak egymással folyamatosan, nagyon gyorsan kell kommunikálnia (egy nagy modell tanítása sok gép együttműködésével zajlik — lásd rész 3).
- Áramellátás: nagyfeszültségű bevezetés, áramfejlesztők tartalékként (áramkimaradás esetére), és belső elosztórendszer.
- Hűtés: a sok ezer, folyamatosan dolgozó gép rengeteg hőt termel — hűtés nélkül a chipek percek alatt túlmelegednének és tönkremennének (lásd rész 4).
- Fizikai biztonság: beléptetőrendszerek, kamerák, őrzés — mert egyetlen adatközpontban gyakran több millió dollár értékű berendezés, és érzékeny adatok vannak.
Rész 2 — Miért kell annyi energia? Számokkal
Elvben hasonló technológia, de az AI-tréningre használt GPU-k (pl. az nvidia H100 típusú, ipari kategóriájú chipek) sokkal több energiát használnak, és nem egyesével, hanem ezrével/tízezrével dolgoznak együtt.
Konkrét nagyságrendek (közelítő, tájékoztató értékek, hogy érzékeld a méretet — a pontos számok gyorsan változnak, ezért érdemes friss forrásból utánanézned, ha pontos adatra van szükséged):
- Egy modern, AI-tréningre használt GPU energiafogyasztása: kb. 700-1000 Watt darabonként (összehasonlítva: egy átlagos háztartási hajszárító kb. 1500-2000 Watt, tehát egy GPU nagyjából fél hajszárítónyi energiát használ, folyamatosan, nem csak pár percig).
- Egy nagy nyelvi modell betanítása (pl. egy gpt-szerű modell) több ezer, akár tízezernyi GPU-t használ egyszerre, heteken- hónapokon át — ez összesítve több megawattnyi (1 megawatt = 1 millió watt) folyamatos teljesítményt jelent, ami összemérhető egy kisebb város áramfogyasztásával.
- Egy modern, nagy adatközpont teljes teljesítményigénye elérheti a több száz megawattot — egyes, legújabb, kifejezetten AI-célra épülő komplexumok tervezett kapacitása már gigawatt (1000 megawatt) nagyságrendben mozog — ez egy atomerőmű teljes kimenetével összemérhető.
Ez azt jelenti, hogy minden egyes kérdésem, amit feltehetek egy AI-nak, ennyi energiát használ? Fontos megkülönböztetés: a fenti, óriási számok a tanításra (lépés 4 a 17. leckéből) vonatkoznak, ami egyszeri (vagy ritkán ismétlődő) esemény. Amikor te használod a már kész modellt (ezt hívják "inference"-nek — "következtetés" — vagyis a már betanított modell futtatása egy új kérdésre), ez sokkal kevesebb energiát igényel egyetlen válaszhoz — bár összesítve, milliónyi felhasználó egyidejű használatával, ez is jelentős, folyamatos energiaigényt jelent az adatközpontok számára.
Nem feltétlenül — több gyártó kifejezetten inference-re optimalizált chip-változatokat is kínál a tanításra szánt, csúcsteljesítményű verziók mellett, amelyek kisebbek, olcsóbbak és energiatakarékosabbak. Ez azért éri meg, mert egyetlen válasz kiszámítása sokkal kevesebb számítást igényel, mint a modell teljes betanítása.
Rész 3 — Miért kell "sok gép együtt" a tanításhoz? (párhuzamosítás)
Emlékeztető a 14. leckéből: a tanítási ciklus (predikció -> hiba -> backward -> step) egyetlen gépen, a te saját gépeden lefutott a 6 autós példán — de egy nagy nyelvi modell esetén a "predikció -> hiba" számítás több milliárd paraméteren, több billió tokenen történik — ez egyetlen gépen, akár évekig is tartana.
A megoldás: a munkát szétosztják sok gép között, párhuzamosan — ez olyan, mintha a 14. lecke for korszak ciklusának minden egyes lépését nem egyetlen számítógép, hanem ezer számítógép végezné el, egyidejűleg, majd összesítenék az eredményeket.
Ehhez viszont az kell, hogy ez az ezer gép gyorsan, folyamatosan tudjon kommunikálni egymással (a hálózati összeköttetés sebessége itt éppen olyan kritikus, mint maga a számítási teljesítmény) — ezért az AI-adatközpontok speciális, ultragyors belső hálózati technológiákat használnak, amik lényegesen gyorsabbak, mint egy átlagos, általános célú webszerver-központ hálózata.
Az ilyen ultragyors belső hálózatok elnevezése a gyakorlatban gyakran InfiniBand vagy NVIDIA NVLink — ezek lényegesen nagyobb sávszélességet és kisebb késleltetést biztosítanak, mint egy szokásos internetes hálózati kártya. Enélkül a sok ezer GPU jelentős időt „egymásra várva” töltene, ahelyett hogy ténylegesen számolna.
Rész 4 — A hűtés problémája: miért ilyen nagy kihívás?
Minden elektromos áram, ami egy GPU-n átfolyik, végül gyakorlatilag teljes egészében hővé alakul (ez egy alapvető fizikai törvény) — tehát ha egy adatközpont több száz megawattnyi áramot használ, ez a teljes mennyiség, gyakorlatilag, hővé alakul, amit valahogy el kell vezetni, különben a berendezés tönkremegy.
Hűtési módszerek (a legelterjedtebbtől a legújabb felé):
1. Léghűtés: ventilátorok + légkondicionáló rendszerek — a hagyományos, régebbi megoldás, de a mai, nagyon sűrűn elhelyezett, nagy teljesítményű AI-GPU-klasztereknél egyre kevésbé elégséges önmagában.
2. Folyadékhűtés: a chipekhez közvetlenül vezetett hűtőfolyadék (víz vagy speciális hűtőközeg) — sokkal hatékonyabban vezeti el a hőt, mint a levegő, ezért az újabb, nagy teljesítményű AI-adatközpontok egyre inkább erre állnak át.
3. Merüléses hűtés (immersion cooling): a teljes szerver egy speciális, nem vezető folyadékba van merítve — ez a legújabb, leghatékonyabb (de legdrágább, legbonyolultabb) megoldások egyike.
Igen — és ez egyre több vita témája: egyes adatközpontok napi szinten jelentős mennyiségű vizet használnak (hűtésre, párolgás útján), ami olyan területeken, ahol a vízkészlet amúgy is korlátozott, környezeti/társadalmi aggályokat vet fel — ez egy olyan reális, gyakorlati költség/következmény, amiről az AI körüli beszélgetésekben egyre többet hallani.
Rész 5 — További feltételek: hol építhető egy adatközpont?
Egy adatközpont helyszínének kiválasztásakor (a szakmában "site selection") ezeket a szempontokat veszik figyelembe:
- Megbízható, nagy kapacitású áramhálózat elérhetősége — gyakran közvetlenül egy erőmű vagy nagyfeszültségű alállomás közelében építik.
- Hűvös éghajlat (ha léghűtést is használnak) — ezért sok adatközpont északi, hűvösebb területeken (pl. Skandinávia) épül, ahol a környezeti hőmérséklet természetesen segíti a hűtést.
- Vízhez való hozzáférés (folyadékhűtéshez).
- Stabil, alacsony természeti katasztrófa-kockázat (földrengés, árvíz, stb. — mert az adatvesztés/leállás óriási költséget jelenthet).
- Gyors, megbízható internetes összeköttetés (nagy sebességű "gerinchálózati" kapcsolat).
- Kedvező szabályozási/adózási környezet, és helyi engedélyek.
- Egyre inkább szempont: megújuló energiaforrások (napenergia, szélenergia) elérhetősége — a nagy AI-cégek egyre többet kommunikálnak arról, hogy a növekvő energiaigényüket megújuló forrásokból szeretnék fedezni — ez részben környezetvédelmi, részben gazdasági (hosszú távon olcsóbb) megfontolás.
Ez azt jelenti, hogy egy AI-adatközpont felépítése évekig tart? Igen — egy nagy, kifejezetten AI-célra épülő adatközpont tervezése, engedélyeztetése, építése, majd a szükséges áramhálózati bővítés (ami gyakran a leghosszabb, legnehezebb rész, mert egy ország/régió áramhálózatát nem lehet "egyik napról a másikra" jelentősen bővíteni) több évet vehet igénybe — ez egyik oka annak, hogy az AI-fejlesztés sebességét ma már gyakran nem csak a szoftveres/matematikai tudás, hanem a fizikai infrastruktúra (áram, épület, chip-gyártási kapacitás) korlátozza.
Mivel a meglévő áramhálózat jelentős bővítése gyakran évekig tart, néhány nagy AI-cég úgy próbálja meg felgyorsítani a folyamatot, hogy saját, dedikált energiatermelő kapacitást (pl. napelemparkot, vagy egy erőmű kapacitásának lekötését) finanszíroz az adatközpontja mellé. Ez jól mutatja, hogy az AI-fejlesztés ma már legalább annyira energiaipari, mint szoftveres kérdés.
Összefoglaló táblázat — mi kell egy AI-adatközponthoz?
| Összetevő | szerepe | fő kihívás |
|---|---|---|
| GPU/AI-chip klaszter (tanítás/inference) | a tényleges számítás | ár, elérhetőség, gyártási kapacitás |
| Nagysebességű hálózat | GPU-k összekötése | sebesség, késleltetés |
| Áramellátás | a teljes rendszer üzemeltetése | kapacitás, megbízhatóság |
| Hűtés (lég/folyadék) | a termelt hő elvezetése | hatékonyság, vízhasználat |
| Épület/telephely | fizikai elhelyezés | helyszín, engedélyek, katasztrófakockázat |
| Redundancia (kiesés esetén is) | folyamatos üzem | tartalék áram/hálózat, plusz költség |
1. Nézz utána (webes keresés), melyik országok/régiók a legnépszerűbb helyszínek ma az új, nagy AI-adatközpontok építésére, és próbáld meg a rész 5 szempontjai alapján megindokolni, miért pont azokat választották.
2. Gondolkodj el: egy kisebb weboldalnál mekkora a különbség a szükséges "infrastruktúra" (egy megosztott vagy vps tárhely) és egy AI-adatközpont között? Mi az, ami ugyanaz marad elvben (pl. "kell egy megbízható szerver, ami fut"), és mi az, ami nagyságrendekkel más?
3. Új gyakorlat: a rész 2 "inference vs. tanítás" energiaigény különbsége alapján, gondold végig: ha egy meglévő, már betanított AI-modellt használsz (pl. egy API-n keresztül egy saját alkalmazásodban), te magad résztvevője vagy-e a "tanítási" vagy az "inference" szakasznak? Miért fontos ez a különbségtétel, ha pl. a költségeidet szeretnéd becsülni egy ilyen projektnél?
Források és további olvasnivaló
A lecke témájának hivatalos dokumentációi és alapvető cikkei:
• IEA: Energy and AI (2025) — iea.org