19. lecke
Az AI teljes története: a kezdetektől a mai nagy nyelvi modellekig
Nevek, évszámok, kísérletek, bukások és áttörések
Hogyan jutottunk el egy 1943-as elméleti ötlettől a mai nagy nyelvi modellekig? Ez a lecke végigjárja a mesterséges intelligencia történetét: az elméleti alapokat, a szakértői rendszereket és az „AI-teleket", a neurális hálózatok újjáéledését, a mély tanulás forradalmát és a Transformer korszakát. Látni fogod, hogy a mai rendszerek ugyanazokra az alapfogalmakra épülnek, amelyeket a kurzusban már megismertél.
- Az elméleti alapok (1943-1957): "lehet-e egy gép 'gondolkodni'?"
- Szakértői rendszerek és az első "AI tél" (1958-1984)
- A neurális hálózatok újjáéledése (1986-1997)
- A mély tanulás forradalma (2006-2016)
- A transformer-forradalom és a nagy nyelvi modellek kora (2017-napjainkig)
- Olvasási idő: kb. 15 perc (a kódok kipróbálásával több)
- 6 rész · 0 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Ez a lecke egy nagy, összefüggő történet — hogyan jutott el az emberiség egy 1943-as elméleti ötlettől a mai, több milliárd paraméteres nyelvi modellekig. Minden egyes állomás ugyanazokra az alapfogalmakra épül, amiket az 1-14c leckékben már megismertél (neuron-modell, tanulás próbálgatással, rétegek, deriválás/backpropagation) — ez a lecke megmutatja, hogyan fejlődtek ki ezek a fogalmak, évtizedeken át, gyakran bukásokon, elakadásokon keresztül.
Forrás: a leckében szereplő nevek/évszámok/tények az ibm hivatalos "History of Artificial Intelligence" áttekintése (ibm.com/think/topics/history-of-artificial-intelligence) alapján kerültek összeállításra — ez egy megbízható, ipari forrás, de mint minden történelmi áttekintésnél, érdemes tudnod: egyes részletkérdésekben (pl. "ki volt pontosan az első") a történészek/szakemberek között lehetnek eltérő vélemények — ez a lecke a legszélesebb körben elfogadott, főbb állomásokat mutatja be.
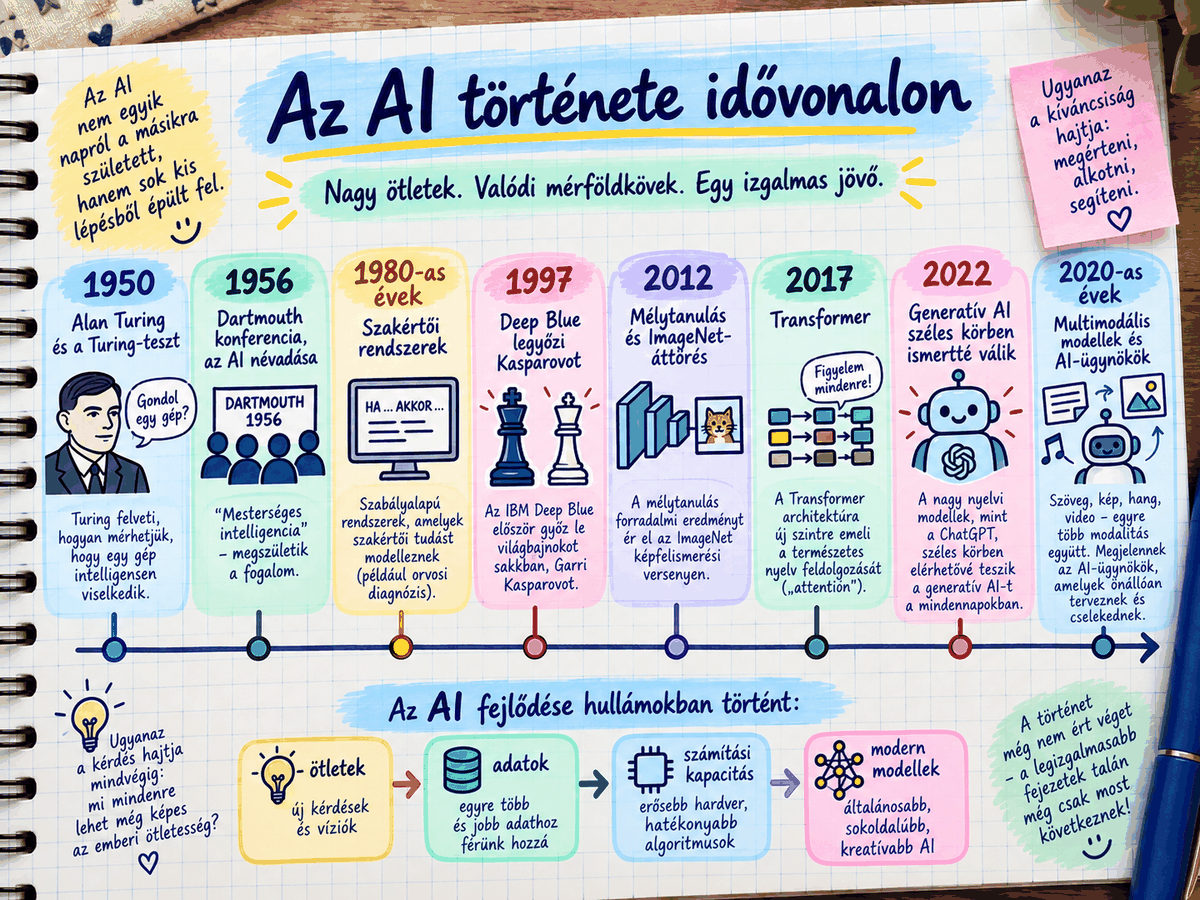
Rész 1 — Az elméleti alapok (1943-1957): "lehet-e egy gép 'gondolkodni'?"
1943 — McCulloch és Pitts: "A logical calculus of the ideas immanent in nervous activity" Warren McCulloch (idegtudós) és Walter Pitts (matematikus) egy tudományos cikket publikáltak, amiben először javasoltak egy matematikai modellt arra, hogyan működhet egy biológiai idegsejt (neuron) — ez volt a mesterséges neurális hálózat fogalmának születése.
Ez pontosan az a 'neuron', amiről a 14. leckében volt szó? Ez az elméleti őse annak — de fontos pontosítás: McCulloch és Pitts modellje még nagyon egyszerű volt (egy "igen/nem" kapcsolóhoz hasonlított, tanulás nélkül) — a 14. lecke nn.Linear+ReLU rétege ennek a gondolatnak a sokkal későbbi, matematikailag sokkal kifinomultabb leszármazottja.
1950 — Alan Turing: "computing machinery and intelligence" A brit matematikus (aki a második világháborúban a német enigma-kód feltörésében is kulcsszerepet játszott) publikálta ezt a tanulmányt, amiben feltette a kérdést: "Can machines think?" ("Tudnak-e a gépek gondolkodni?") — és javasolt egy gyakorlati tesztet (ma "turing-teszt" néven ismert): ha egy ember egy szöveges beszélgetés során nem tudja megkülönböztetni, hogy emberrel vagy géppel beszélget, a gép "átment" a teszten.
Ez ma is vitatott kérdés a szakmában — de a 12b lecke "nagyon jó papagáj" hasonlatára emlékezve: a turing-teszt azt méri, hogy a gép kimenete "meggyőző-e" — nem azt, hogy a gép valóban "ért"-e bármit is emberi értelemben. Ez a különbségtétel ma is a legfontosabb vitapontok egyike az AI körül.
1951 — Minsky és Edmonds: SNARC Marvin Minsky és Dean Edmonds megépítették a SNARC-ot, amit "az első mesterséges neurális hálózatnak" tartanak — ez egy fizikai gép volt (nem szoftver, mert akkor még nem voltak elterjedt számítógépek), ami megerősítéses tanulás elveit használta (emlékezz a 14b/16. leckére: ez az az elv, amit ma is "megerősítéses tanulásnak" hívunk!).
1955-1956 — A Dartmouth konferencia: az "AI" kifejezés születése John McCarthy, Marvin Minsky, Nathaniel Rochester és Claude Shannon egy nyári kutatótábort szerveztek a Dartmouth Egyetemen — ezen a találkozón született meg hivatalosan a "mesterséges intelligencia" (Artificial Intelligence) mint önálló tudományterület elnevezése és fogalma.
1957 — Rosenblatt: A perceptron Frank Rosenblatt megépítette a perceptront — egy egyrétegű tanuló hálózatot, ami képes volt egyszerű mintázatokat felismerni (pl. egyszerű képeket osztályozni).
Ez pontosan a 14. lecke EgyszeruHalo-jának az 'őse'? Igen, és ez egy kiváló példa arra, hogyan épülnek egymásra az ötletek: a perceptron az első gyakorlati megvalósítása volt annak, amit a 14. leckében nn.Linear rétegként ismertél meg — csak még sokkal egyszerűbb formában, és még nem a ma használt, kifinomult tanítási módszerrel (a backpropagation módszerét csak évtizedekkel később, 1986-ban publikálták széles körben használható formában — lásd rész 3).
Marvin Minsky és Seymour Papert 1969-ben megjelent „Perceptrons” című könyve matematikailag bebizonyította, hogy egy egyrétegű perceptron nem képes megoldani bizonyos egyszerű feladatokat (pl. a „kizáró vagy”, XOR logikai műveletet). Ez a kritika sok kutatót és finanszírozót elbizonytalanított, és jelentősen hozzájárult ahhoz, hogy a neurális hálózatok kutatása évtizedekre háttérbe szoruljon — egészen az 1986-os backpropagation-áttörésig.
Rész 2 — Szakértői rendszerek és az első "AI tél" (1958-1984)
1958 — McCarthy: A Lisp programozási nyelv John McCarthy megalkotta a Lisp nyelvet, ami évtizedekig az AI-kutatás egyik legnépszerűbb programozási nyelve maradt (emlékeztető a 9. leckéből: neked, mai tanulónak, a Python a megfelelő eszköz — de érdemes tudnod, hogy a terület történetében más nyelvek is fontos szerepet játszottak).
1959 — Arthur Samuel: gépi tanulás dámajáték-programmal Samuel egy dámajátékot (checkers) játszó programot írt, ami képes volt "tapasztalatból tanulni" — ő alkotta meg a "machine learning" (gépi tanulás) kifejezést, ami ma is a terület egyik leggyakrabban használt neve.
1965 — Dreyfus kritikája Hubert Dreyfus filozófus publikálta az "Alchemy and Artificial Intelligence" ("Alkímia és mesterséges intelligencia") című írását, amiben megkérdőjelezte az AI-kutatás akkori alapfeltevéseit — ez a fajta kritikus, szakmai vita ma is létezik (gondolj a 17. lecke "előnyök/hátrányok" részére).
1966-ban Joseph Weizenbaum megalkotta az ELIZA nevű programot, ami egyszerű mintaillesztéssel utánozott egy pszichoterapeutát — sok felhasználó meglepően érzelmesen kötődött hozzá, pedig a program semmit nem „értett” abból, amit mondtak neki. Ezt a jelenséget — hogy hajlamosak vagyunk értelmet és érzelmet tulajdonítani egy egyszerű mintakövető rendszernek — ma is „ELIZA-hatásnak” hívják.
1973 — A Lighthill-jelentés és az első "AI tél" Sir James Lighthill egy jelentést készített a brit kormány számára, amiben kritizálta az AI-kutatás eddigi eredményeit (arra a következtetésre jutva, hogy a kutatás nem váltotta be a hozzá fűzött reményeket) — ennek eredményeként az AI-kutatás finanszírozása jelentősen csökkent az Egyesült Királyságban. Ezt a korszakot (amikor az érdeklődés és a pénzügyi támogatás visszaesett) hívja a szakma "AI télnek" (AI winter).
Mert ez egy fontos tanulsággal szolgál: az AI fejlődése soha nem volt egyenes vonalú — voltak lelkes, túlzott ígéretek, majd csalódások, majd új áttörések. Ha ma valaki azt állítja, hogy "most végre minden megoldódik" — érdemes óvatosnak lenni, mert a történelem már többször megmutatta: a valóság gyakran lassabban, bonyolultabban halad, mint a leglelkesebb előrejelzések.
1984 — Wabot-2 egy japán fejlesztésű humanoid robot, ami képes volt egy elektronikus orgonán játszani, és éneklőket kísérni — ez a korszak "szakértői rendszerek" (expert systems) nevű megközelítésének egyik példája: itt még nem a mai értelemben vett "tanulás" állt a középpontban, hanem emberek által kézzel beírt, rögzített szabályok összessége (ez rokon a 14b lecke "döntési fa" fogalmával, csak még kezdetlegesebb formában, gépi tanulás nélkül).
Rész 3 — A neurális hálózatok újjáéledése (1986-1997)
1986 — Rumelhart, Hinton és Williams: A backpropagation áttörése David Rumelhart, Geoffrey Hinton és Ronald Williams publikáltak egy tanulmányt a Nature folyóiratban, amiben bemutatták, hogyan lehet a backpropagation (hiba visszaterjesztés) módszerét hatékonyan használni többrétegű neurális hálózatok tanítására.
Ez pontosan az a 'backward()' hívás, amit a 13-14. leckében használtunk? Igen — és ez egy kulcsfontosságú pillanat a történetben: A perceptron (1957) önmagában nem tudott hatékonyan tanulni többrétegű hálózatokban (ez egy komoly, évtizedekig fennálló matematikai akadály volt) — a backpropagation módszere (ami a 14c leckében tanult láncszabályra épül) oldotta meg ezt a problémát, lehetővé téve, hogy több réteget ("mély" hálózatokat) taníthassanak hatékonyan — ez az ötlet, 1986-ban, volt az alapja annak, amit ma "mély tanulásnak" (deep learning) hívunk.
1988 — Pearl: bayesi hálózatok Judea Pearl publikálta a "Probabilistic Reasoning in Intelligent Systems" című munkáját, amiben bevezette a bayesi hálózatok fogalmát — egy matematikai eszközt a bizonytalanság (valószínűség) kezelésére az AI-rendszerekben.
1989 — LeCun: kézírásfelismerés backpropagation-nel Yann LeCun csapata a backpropagation módszerét alkalmazta kézzel írt postai irányítószámok felismerésére — ez volt az egyik első gyakorlati, valós problémára alkalmazott bizonyítéka annak, hogy a mély tanulás tényleg működik a gyakorlatban, nem csak elméletben.
1997 — LSTM és a Deep Blue-Kaszparov meccs Sepp Hochreiter és Jürgen Schmidhuber bevezették az LSTM (Long Short-Term Memory) hálózatokat (a 14b lecke rész 3.8-ban Említett "emlékező" hálózat-típus) — ugyanebben az évben az IBM Deep Blue nevű számítógépe legyőzte Garri Kaszparovot, a regnáló sakkvilágbajnokot — ez volt az első alkalom, hogy egy gép legyőzött egy világbajnokot sakkban (bár ez a rendszer még nem "tanult" a mai értelemben, inkább hatalmas számítási teljesítménnyel, előre megírt stratégiákkal dolgozott).
Rész 4 — A mély tanulás forradalma (2006-2016)
2006 — Hinton: "learning multiple layers of representation" Geoffrey Hinton (aki 1986-ban már a backpropagation egyik szerzője volt) egy új tanulmányban lefektette a modern "mély tanulás" (deep learning) elméleti alapjait.
2007 — Fei-Fei Li: az ImageNet projekt elindítása Fei-Fei Li (Princeton, majd Stanford egyetem kutatója) elindította az ImageNet projektet — egy hatalmas, több millió képből álló, gondosan címkézett adatbázist (emlékeztető a 14b leckéből: egy CNN-nek pontosan ilyen, nagy mennyiségű, címkézett képadatra van szüksége a tanításhoz).
Miért volt ekkora jelentősége 'csak' egy adatbázisnak? Mert a 12b lecke alapelvére emlékezve: egy modell csak annyit tud "megtanulni", amennyi jó minőségű adat rendelkezésre áll. Az ImageNet előtt nem volt elég nagy, szabványosított adathalmaz ahhoz, hogy a kutatók összehasonlíthassák a különböző modellek teljesítményét — ez a hiányzó "üzemanyag" volt az egyik legnagyobb akadály a fejlődés útjában.
2009 — GPU-k felfedezése a mély tanuláshoz Rajat Raina, Anand Madhavan és Andrew Ng (Stanford) bemutatták, hogy a GPU-k (eredetileg számítógépes grafikára tervezett chipek) sokkal jobban teljesítenek a mély tanulási számításokban, mint a hagyományos CPU-k — ez volt az elméleti alapja annak a gyakorlatnak, amit a 18. leckében már megismertél (GPU-klaszterek az adatközpontokban).
2012 — Az AlexNet áttörése: A "mély tanulási forradalom" kezdete Geoffrey Hinton csapata (köztük Alex Krizhevsky és Ilya Sutskever — aki később az OpenAI egyik alapító kutatója lett) megnyerte az ImageNet versenyt az "AlexNet" nevű CNN-modelljükkel — a hibaarányuk mindössze 15,3% volt, szemben a korábbi legjobb, 26,2%-os eredménnyel. Ez a különbség olyan látványos volt, hogy ezt a pillanatot tartják a modern mély tanulási korszak kezdetének.
Mi tette lehetővé ezt az áttörést pontosan 2012-ben, és nem korábban, ha a matematikai alapok (backprop) már 1986 óta léteztek? Ez a lecke egyik legfontosabb tanulsága: három dolognak egyszerre kellett rendelkezésre állnia — (1) elég nagy, jó minőségű adathalmaz (ImageNet, 2007), (2) elég erős, megfizethető számítási teljesítmény (GPU-k felfedezése, 2009), és (3) a matematikai módszer (backpropagation, 1986). A matematika maga már évtizedekkel korábban kész volt — de csak akkor "robbant be" a terület, amikor mindhárom feltétel egyszerre teljesült. Ez pontosan az a három elem, amit a 18. leckében (adatközpontok) és a 15. leckében (adat+modell+tanítás) már külön-külön megismertél.
2016 — AlphaGo legyőzi Lee Sedolt A Google DeepMind csapata által fejlesztett AlphaGo legyőzte Lee Sedolt, a világ egyik legjobb Go-játékosát — ez sokkal nagyobb jelentőségű volt, mint a Deep Blue-Kaszparov meccs (1997), mert a Go játéktér sokkal nagyobb és összetettebb, mint a sakké — ezt a feladatot nem lehetett "tiszta számítási erővel" megoldani, hanem valódi, mély tanuláson alapuló megerősítéses tanulásra (16. lecke, rész 3) volt szükség.
Rész 5 — A transformer-forradalom és a nagy nyelvi modellek kora (2017-napjainkig)
2017 — "Attention is all you need": A transformer születése egy Google-kutatócsoport (Ashish Vaswani és társai) publikálta ezt a tanulmányt, amiben bemutatták a transformer architektúrát (a 14b lecke 3.9-ben, és a 17. leckében már részletesen megismerted) — ez a cikk címe maga is egy üzenet volt: azt állította, hogy az "attention" (figyelem) mechanizmus önmagában, a korábban használt RNN/LSTM hálózatok (14b, rész 3.8) nélkül is elég a kiváló eredményhez — és a következő évek bebizonyították, hogy ez az állítás helyes volt.
2020 — GPT-3: A nagy nyelvi modellek "robbanása" Az OpenAI kiadta a GPT-3 modellt, 175 milliárd paraméterrel (emlékeztető a 17. leckéből: ez a "paraméter" ugyanaz a fogalom, mint a 14. lecke nn.Linear rétegeinek súlyai (w, b), csak itt 175 milliárdnyi ilyen szám van, nem pár tucat) — a gpt-3 bemutatta a "few-shot learning" képességét: képes volt új feladatokat megoldani, ha csak néhány példát mutattak neki a kérdésben, anélkül, hogy külön újratanították volna.
2021 — DALL·E és az önvezetés fejlődése Az OpenAI kiadta a DALL·E-t (szövegből képet generáló modell — egy további példa arra, hogyan terjedt ki a transformer-elv a nyelvi feladatokon túlra), miközben a Tesla bővítette a full self-driving (16. lecke, rész 4: önvezető autók) béta programját.
A legtöbb mai szöveg-alapú képgenerátor (DALL·E, Midjourney, Stable Diffusion) úgynevezett „diffúziós modell”: a tanítás során fokozatosan zajt adnak egy képhez, majd a modell megtanulja ezt a folyamatot lépésről lépésre visszafordítani. Generáláskor a modell egy véletlenszerű zajból indul, és lépésről lépésre „kitisztítja” azt, amíg egy, a szövegleírásnak megfelelő kép nem áll elő.
2022 November — A ChatGPT nyilvános indulása Az OpenAI elindította a ChatGPT-t, kezdetben "ingyenes kutatási előzetes"-ként — ez volt az a pillanat, amikor a nagy nyelvi modellek kiléptek a szakértői körökből a széles közönség számára is elérhetővé, használhatóvá váltak — és ez volt az a pont, ahonnan a legtöbb ember (valószínűleg te is) először találkozott személyesen egy nagy nyelvi modellel.
2023 — GPT-4 és a verseny kiszélesedése Az OpenAI kiadta a GPT-4-et (márciusban), ami már nem csak szöveget, hanem képeket is tudott értelmezni bemenetként, és a Google elindította saját nyelvi modelljét (Bard) — ettől az évtől kezdve a nagy nyelvi modellek fejlesztése több nagy technológiai cég (köztük az Anthropic, a Claude modellcsalád fejlesztője) közötti, gyorsan fejlődő versennyé vált.
2024 — További modellek, szabályozás, elismerés megjelent a Gemini (Google), a sora (OpenAI, videógenerálás), az Európai Unió elfogadta az AI Act-et (az egyik első átfogó AI-szabályozást — emlékeztető a 12b lecke rész 6-ra: a biztonsági/szabályozási kérdések egyre fontosabbak lettek), a Meta kiadta a Llama 3.1-et nyílt súlyozású (open-weight) modellként (vagyis bárki számára letölthető, használható formában), és a Nobel-díj bizottság elismerte a neurális hálózatok és a fehérjeszerkezet-előrejelzés területén elért eredményeket (Hinton — akivel ebben a leckében 1986 és 2012 kapcsán is találkoztál — 2024-ben fizikai Nobel-díjat kapott).
2025-2026 — AI-ügynökök (agents) és a "gondolkodó" modellek kora a fejlesztés fókusza egyre inkább az "AI-ügynökök" (agents — olyan rendszerek, amik nem csak válaszolnak, hanem önállóan, több lépésben tudnak feladatokat végrehajtani, eszközöket használni) és a "gondolkodó" (reasoning) modellek felé tolódott, miközben a biztonsági és szabályozási kérdések (12b lecke, rész 6) egyre hangsúlyosabbá váltak.
Rész 6 — Összefoglaló idővonal — A legfontosabb állomások
| Év | esemény | ki/mi |
|---|---|---|
| 1943 | Mesterséges neuron matematikai modellje | McCulloch & Pitts |
| 1950 | Turing-teszt | Alan Turing |
| 1951 | SNARC — első neurális hálózat | Minsky & Edmonds |
| 1955-1956 | "Mesterséges intelligencia" névadás | Dartmouth Konferencia |
| 1957 | Perceptron | Frank Rosenblatt |
| 1958 | Lisp programozási nyelv | John McCarthy |
| 1959 | "Gépi tanulás" fogalma | Arthur Samuel |
| 1973 | Első "AI tél" kezdete | Lighthill-jelentés |
| 1986 | Backpropagation áttörés | Rumelhart, Hinton, Williams |
| 1997 | Deep Blue legyőzi Kaszparovot | IBM |
| 2007 | ImageNet adatbázis | Fei-Fei Li |
| 2009 | GPU-k a mély tanulásban | Raina, Madhavan, Ng |
| 2012 | AlexNet — a mély tanulás áttörése | Hinton, Krizhevsky, Sutskever |
| 2016 | AlphaGo legyőzi Lee Sedolt | Google DeepMind |
| 2017 | Transformer — "Attention Is All You Need" | Vaswani és mtsai (Google) |
| 2020 | GPT-3, 175 milliárd paraméter | OpenAI |
| 2022 | ChatGPT nyilvános indulása | OpenAI |
| 2023 | GPT-4, a verseny kiszélesedése | OpenAI, Google, Anthropic |
| 2024 | Nobel-díj a neurális hálózatokért | Geoffrey Hinton |
A lecke záró, legfontosabb tanulsága: nézd végig ezt a táblázatot még egyszer, és vedd észre: 1943-tól 2012-ig (közel 70 éven át) a terület lassan, gyakran csalódásokkal tarkítva fejlődött — de 2012-től (AlexNet) a mai napig, alig 14 év alatt, a fejlődés üteme drasztikusan felgyorsult. Ez nem véletlen: ez pontosan az a pillanat, amikor a rész 4-ben leírt három feltétel (adat, számítási teljesítmény, matematikai módszer) végre együtt állt rendelkezésre — és mivel ezek a feltételek azóta csak tovább javultak (egyre több adat, egyre erősebb GPU-k — lásd 18. lecke), a terület fejlődési üteme továbbra is nagyon gyors marad.
1. Válassz ki a táblázatból három eseményt, és mindegyikhez írd le 1-2 mondatban, melyik korábbi lecke (1-18) fogalmait segít megértened jobban, ha tudod a történeti hátterét.
2. Gondolkodj el a rész 2 "AI tél" történetén: szerinted lehetséges-e, hogy a mai, nagyon gyors AI-fejlődés szintén "lelassulhat" egyszer, hasonló okokból (túlzott várakozások, elért technikai határok)? Milyen érveket tudnál felhozni mindkét oldalra (igen/nem)?
3. Új gyakorlat: nézz utána (webes keresés), mi történt az AI területén 2025-2026-ban (a lecke írásakor ez még "élő, folyamatban lévő történelem" volt) — találsz-e olyan új fejleményt, ami szerinted egyszer bekerülhet egy hasonló összefoglaló táblázatba, mint a rész 6-ban látott?
Források és további olvasnivaló
A lecke témájának hivatalos dokumentációi és alapvető cikkei:
• IBM: The History of Artificial Intelligence — ibm.com
• Rumelhart, Hinton, Williams: a visszaterjesztés (Nature, 1986) — nature.com
• Vaswani és mtsai.: Attention Is All You Need (2017) — arxiv.org