20. lecke
Túltanulás, alultanulás, és hogyan védekezünk ellenük
Train/Validation/Test split, Cross-Validation, Regularizáció
Egy modell akkor jó, ha új, sosem látott adatokon is jól teljesít — nem elég, ha a tanító adatokat „bemagolja". Ez a lecke elmagyarázza a túltanulás és az alultanulás fogalmát, megmutatja, miért kell az adatot tanító, validációs és teszthalmazra bontani, hogyan ismerd fel a túltanulást a hibagörbékből, mi a keresztvalidáció, és milyen módszerekkel (dropout, L1/L2 regularizáció, korai leállítás) védekezhetsz ellene.
- A probléma: mi a különbség "megtanulni" és "bemagolni" között?
- A megoldás: miért kell szétválasztani az adatot?
- Hogyan "látod meg" a túltanulást? A két hibagörbe összehasonlítása
- Keresztvalidáció (cross-validation): ha kevés az adat
- Regularizáció: hogyan akadályozzuk meg a "bemagolást"?
- Dropout — "véletlenszerű kikapcsolás" neurális hálókban
- L1/L2 regularizáció — "büntetés" a túl nagy súlyokért
- Korai leállítás (early stopping)
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 9 rész · 11 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Eddig minden modellünket (12, 14, 15. lecke) ugyanazon az adathalmazon tanítottuk, majd ugyanazon az adathalmazon értékeltük — ez egy tudatos egyszerűsítés volt, hogy a tanítás mechanizmusára koncentrálhass. Ez a lecke megmutatja, miért problémás ez a gyakorlatban, és hogyan kell helyesen csinálni.
Mert az 1-19. leckékben a cél az volt, hogy megértsd, hogyan tanul egy modell egyáltalán — ha akkor bevezettük volna a train/test split fogalmát is, az elterelte volna a figyelmet a lényegről. Most, hogy már érted a tanítás mechanizmusát, itt az ideje, hogy megértsd: egy modell "jó eredménye" a tanító adaton nem ugyanaz, mint "jó eredmény az életben" — ez a különbség a gyakorlati AI-fejlesztés egyik legfontosabb, leggyakrabban elrontott pontja.
import numpy as np
import pandas as pd
Rész 1 — A probléma: mi a különbség "megtanulni" és "bemagolni" között?
Hasonlat: képzeld el, hogy egy diák egy vizsgára úgy készül, hogy megtanulja kívülről a tavalyi vizsga pontos kérdéseit és válaszait — de nem érti meg az alapelveket. Ha az idei vizsgán ugyanazok a kérdések jönnek, kiválóan teljesít. De ha az idei vizsga más, új kérdéseket tartalmaz (ugyanarról a témáról, csak másként megfogalmazva), megbukik — mert ő nem a témát tanulta meg, hanem a konkrét válaszokat "bemagolta."
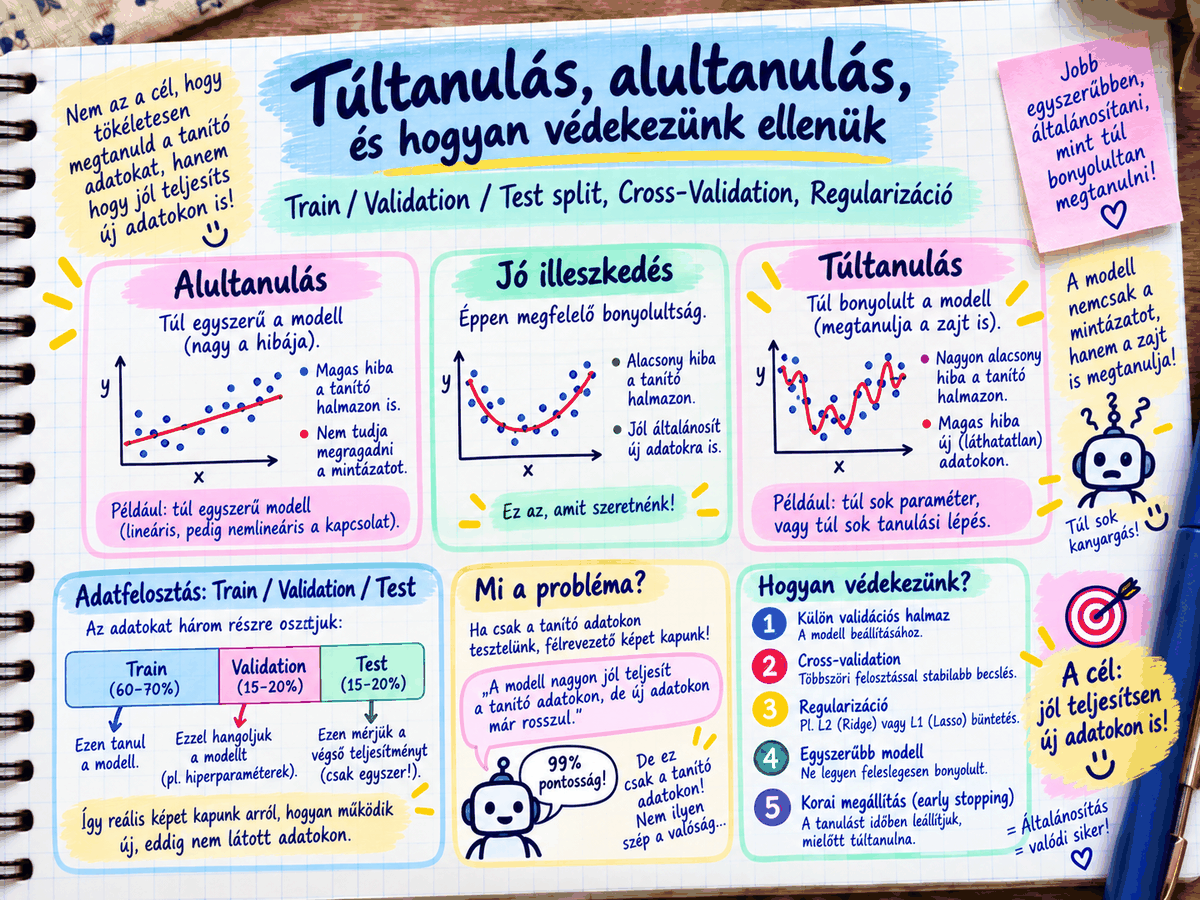
Ez pontosan az, ami egy AI-modellnél is történhet — ezt hívjuk túltanulásnak (overfitting): a modell "bemagolja" a konkrét tanító adatpontokat (beleértve azok véletlenszerű "zaját" is), ahelyett, hogy az általános, mögöttes mintázatot tanulná meg.
Hogyan lehetséges, hogy egy matematikai képlet 'bemagoljon' valamit — ez nem csak emberekre jellemző hiba? Emlékezz a 14. lecke neurális hálójára: ha a hálónak nagyon sok paramétere (súlya) van, elvileg képes lehet egy olyan, rendkívül bonyolult, "görbülő" függvényt illeszteni, ami pontosan átmegy minden egyes tanító adatponton (beleértve azok véletlen ingadozását, "zaját" is) — ez matematikailag "tökéletes" illeszkedést ad a tanító adatra, de ez a "tökéletesség" hamis: a modell nem az általános mintázatot, hanem a konkrét, egyedi adatpontok elhelyezkedését (beleértve a véletlen zajt) tanulta meg.
Az ellenkező probléma az alultanulás (underfitting): a modell túl egyszerű (pl. túl kevés paraméter, túl kevés tanítás) ahhoz, hogy még az alapvető mintázatot is megtanulja — ez olyan, mintha a diák meg sem próbálta volna megérteni az anyagot, és találgatna.
Igen — ezt „torzítás-szórás egyensúlynak” (bias-variance tradeoff) hívják: az alultanulás a magas „torzítás” (bias) jele — a modell túl leegyszerűsítve látja a világot —, a túltanulás pedig a magas „szórás” (variance) jele — a modell túl érzékeny a tanító adat véletlen ingadozásaira. A jó modell valahol a kettő között találja meg az egyensúlyt.
Rész 2 — A megoldás: miért kell szétválasztani az adatot?
Ha a diák-hasonlatnál maradunk: hogyan derülne ki, hogy a diák "bemagolt", nem "megértett"? Úgy, hogy egy olyan vizsgát adsz neki, amit még soha nem látott — ha arra is jól válaszol, akkor tényleg érti az anyagot.
Ezért a gyakorlatban soha nem a teljes adathalmazt használjuk tanításra — hanem szétválasztjuk három (vagy legalább kettő) részre:
1. Tanító halmaz (training set) — általában a teljes adat kb. 60-80%-a — ezen az adaton tanul a modell (ez a rész "látja" a model.fit()/optimalizalo.step() hívásokban).
2. Validációs halmaz (validation set) — kb. 10-20% — ezt az adatot a modell nem látja a tanítás során, de a fejlesztő (te) rendszeresen ellenőrzi rajta a modell teljesítményét — ez segít eldönteni, mikor állj le a tanítással, és melyik beállítások (pl. hány réteg, milyen lr) válnak be jobban.
3. Teszt halmaz (test set) — kb. 10-20% — ezt az adatot szigorúan "félretesszük", és csak a legvégén, egyetlen alkalommal használjuk, hogy megtudjuk: hogyan teljesít a kész modell valóban új, soha nem látott adaton.
Miért kell három külön rész — nem elég kettő (tanító + teszt)? Mert ha a validációs halmazt használod arra, hogy ismételten finomhangold a modell beállításait (pl. "próbáljuk meg lr=0.001-gyel... most lr=0.0001-gyel... melyik jobb a validációs adaton?"), akkor észrevétlenül a validációs halmaz információja is "beszivárog" a modellbe (hiszen te, a fejlesztő, ezek alapján hozol döntéseket) — ezért kell egy harmadik, teljesen érintetlen halmaz (a teszt halmaz) az igazán végső, elfogulatlan értékeléshez.
print("PÉLDA: 20 ADATPONT SZÉTVÁLASZTÁSA 60/20/20 ARÁNYBAN")
print("=" * 55)np.random.seed(42) # a véletlenszám-generátor "lerögzítése" — így a példa MINDIG UGYANAZT az eredményt adja
adatok = pd.DataFrame({
    "km_futott": [10000, 15000, 22000, 30000, 38000, 45000, 52000,
                   60000, 68000, 75000, 82000, 90000, 98000, 105000,
                   112000, 120000, 130000, 140000, 150000, 160000],
    "ar_ezer_ft": [8500, 8200, 7900, 7200, 6800, 6300, 5900,
                    5800, 5400, 5000, 4700, 4500, 4100, 3800,
                    3500, 3200, 2900, 2500, 2100, 1800]
})
Miért kell 'összekeverni' (shuffle) az adatot szétválasztás előtt? Mert a fenti táblázat sorba rendezett (km szerint növekvő) — ha egyszerűen az első 60%-ot vennéd tanító halmaznak, csak alacsony km-értékeket látna a modell tanításkor, és a validációs/teszt halmaz csak magas km-értékeket tartalmazna — ez extrapolációs problémát (12b lecke) okozna már a kiértékelés során is! Ezért először összekeverjük, majd úgy választjuk szét.
adatok_kevert = adatok.sample(frac=1, random_state=42).reset_index(drop=True)
n = len(adatok_kevert)
tanito_meret = int(n * 0.6)
validacios_meret = int(n * 0.2)
tanito = adatok_kevert.iloc[:tanito_meret]
validacios = adatok_kevert.iloc[tanito_meret:tanito_meret + validacios_meret]
teszt = adatok_kevert.iloc[tanito_meret + validacios_meret:]
print(f"Tanító halmaz mérete:    {len(tanito)} adatpont")
print(f"Validációs halmaz mérete: {len(validacios)} adatpont")
print(f"Teszt halmaz mérete:      {len(teszt)} adatpont")
print()
Rész 3 — Hogyan "látod meg" a túltanulást? A két hibagörbe összehasonlítása
A gyakorlatban a túltanulás felismerésének leggyakoribb módja: a tanítás során mindig mérjük a hibát mind a tanító, mind a validációs halmazon, és összehasonlítjuk a két görbét.
Három tipikus mintázat:
A) jól tanuló modell: mind a tanító, mind a validációs hiba folyamatosan csökken, és nagyjából együtt mozognak.
B) alultanuló modell: mind a két hiba magas marad, alig csökken — a modell "túl egyszerű" a feladathoz.
C) túltanuló modell: a tanító hiba tovább csökken (akár nulla közelébe), de a validációs hiba egy ponton megáll, majd újra nőni kezd — ez a "riasztó jel": a modell már nem általános mintázatot tanul, hanem a tanító adat egyedi részleteit (zaját) kezdi "bemagolni."
Pontosan — csak ott csak egy hibaértéket (a tanító halmazét) néztünk, mert nem volt külön validációs halmazunk. A gyakorlatban a helyes módszer: mindig két görbét (tanító és validációs hiba) együtt figyelni, és ha a kettő elkezd "szétválni" (a validációs hiba nőni kezd, miközben a tanító hiba tovább csökken) — leállítani a tanítást ("early stopping").
Rész 4 — Keresztvalidáció (cross-validation): ha kevés az adat
Ez egy nagyon gyakorlati probléma (pl. egy kisvállalkozás saját adatainál is gyakran előfordul: nem áll rendelkezésre ezer meg ezer adatsor). Erre a helyzetre való a keresztvalidáció (k-fold cross-validation)
- Az adatot K darab (pl. 5) egyenlő részre ("fold"-ra) osztjuk.
- K különböző körben, mindig más 1 részt használunk validációra, a maradék K-1 részt tanításra.
- A K különböző kör eredményét átlagoljuk — ez sokkal megbízhatóbb képet ad a modell valódi teljesítményéről, mintha csak egyetlen, véletlenszerűen kiválasztott validációs részletre támaszkodnánk — mert minden egyes adatpont pontosan egyszer szerepel validációs szerepben.
Ez a módszer többszöri tanítást igényel (k-szor kell lefuttatni a tanítási ciklust) — tehát lassabb, de megbízhatóbb, kis adathalmazoknál.
Igen, ezt „rétegzett” (stratified) K-fold-nak hívják: ilyenkor minden „fold” ugyanolyan arányban tartalmazza az egyes osztályokat (kategóriákat), mint a teljes adathalmaz. Ez különösen fontos, ha az osztályok eloszlása egyenetlen (pl. egy spamszűrőnél sokkal kevesebb a spam, mint a nem-spam levél) — enélkül egy-egy fold véletlenül szinte kizárólag csak az egyik osztályból állhatna.
from sklearn.model_selection import KFold
print("KERESZTVALIDÁCIÓ PÉLDA (5 RÉSZRE OSZTVA):")
kf = KFold(n_splits=5, shuffle=True, random_state=42)for fold_szam, (tanito_index, validacios_index) in enumerate(kf.split(adatok), start=1):
print(f" {fold_szam}. kör: {len(tanito_index)} tanító adat, "
f"{len(validacios_index)} validációs adat")
print()Rész 5 — Regularizáció: hogyan akadályozzuk meg a "bemagolást"?
A regularizáció olyan technikák gyűjtőneve, amik kifejezetten arra valók, hogy a modellt "visszafogják" a túlzott bonyolultságtól — vagyis elősegítik, hogy az általános mintázatot tanulja meg, ne a zajt.
5.1 Dropout — "véletlenszerű kikapcsolás" neurális hálókban
Emlékeztető a 14. leckéből: a nn.Linear rétegek sok "rejtett" értéket számolnak ki (pl. 8 vagy 16 darabot). A dropout módszer a tanítás során, minden egyes körben, véletlenszerűen "kikapcsol" (nullára állít) egy bizonyos százalékát ezeknek az értékeknek.
Ez nem csak rontja a modellt, ha véletlenszerűen 'kikapcsolunk' részeket? Első hallásra furcsának tűnik, de pont ez a lényeg: ha a modell nem támaszkodhat megbízhatóan egyetlen konkrét "útvonalra" a hálózaton belül (mert az bármikor "kieshet"), kénytelen többféle, redundáns módon is megtanulni felismerni a mintázatot — ez megakadályozza, hogy a háló túlzottan "ráspecializálódjon" a tanító adat egyedi részleteire. (példa kódban: nn.Dropout(0.2) egy PyTorch réteg, ami a neuronok 20%-át véletlenszerűen kikapcsolja minden tanítási lépésben.)
5.2 L1/L2 regularizáció — "büntetés" a túl nagy súlyokért
Emlékeztető a 14c leckéből: a tanítás a hibafüggvény minimalizálásáról szól. Az L1/L2 regularizáció egy további tagot ad hozzá ehhez a hibafüggvényhez, ami "bünteti" a modellt, ha a súlyai (paraméterei) túl nagyra nőnek:
L2 regularizációval kiegészített hiba = eredeti_hiba + lambda * (súlyok négyzetösszege)
Miért segít, ha 'büntetjük' a nagy súlyokat? Mert a túltanuló modellek gyakran nagyon nagy, szélsőséges súlyértékeket "tanulnak meg" annak érdekében, hogy pontosan átmenjenek minden egyes (zajos) tanító adatponton — a regularizáció arra "kényszeríti" a modellt, hogy csak akkor növeljen egy súlyt nagyra, ha az valóban, jelentősen javítja az általános illeszkedést — ez simább, általánosabb függvényeket eredményez.
Az L2 (amit ebben a leckében láttál) simán, fokozatosan zsugorítja a súlyokat nulla felé, de ritkán állítja pontosan nullára őket. Az L1 regularizáció ezzel szemben hajlamos egyes súlyokat teljesen nullára állítani — így a modell „automatikusan” kiválaszthatja, mely bemeneti jellemzők (feature-ök) a fontosak, ezért gyakran használják jellemző-kiválasztásra is.
5.3 Korai leállítás (early stopping)
A Rész 3-ban leírt "C) túltanuló modell" mintázatra épülő, egyszerű, de hatékony módszer: folyamatosan figyeljük a validációs hibát, és amint az elkezd nőni (miközben a tanító hiba tovább csökken), leállítjuk a tanítást — még mielőtt a modell "túltanulna."
Összefoglaló táblázat
| Jelenség | miről ismered fel | megoldás |
|---|---|---|
| Alultanulás | mindkét hiba (tanító+validációs) magas marad | Nagyobb/összetettebb modell, több tanítás |
| Túltanulás | Tanító hiba csökken, validációs hiba nő/megáll | Regularizáció (dropout, L1/L2), early stopping, több tanító adat |
| Kevés adat | Egyetlen validáció megbízhatatlan | Keresztvalidáció (K-fold) |
1. Futtasd le a fenti kódot, és nézd meg a kiírt tanító/ validációs/teszt méreteket — ha a teljes adathalmazod (a 15. lecke weboldal-projektjéből) 20 sorból állt, miért gondolod, hogy ez már "kevés" ahhoz, hogy megbízható validációt végezz rajta egyszerű szétválasztással (szemben a keresztvalidációval)?
2. Módosítsd a 15. lecke projektjét: válaszd szét az adatot tanító és teszt részre (ez a lecke rész 2 kódja alapján), tanítsd a modellt csak a tanító részen, majd értékeld ki a teszt részen — mennyire tér el az eredmény a korábbi (teljes adaton mért) eredménytől?
3. Új gyakorlat: a 14. lecke EgyszeruHalo modelljébe illessz be egy nn.Dropout(0.2) réteget a reteg1 és az aktivacio közé — nézd meg (a PyTorch dokumentációjában vagy webes kereséssel), pontosan hova kell írnod a forward() függvényben, és gondolkodj el: egy ilyen kis, 20 adatpontos problémánál valójában szükség van-e dropout-ra, vagy ez inkább csak nagyon nagy, sok paraméteres hálóknál számít igazán?
Források és további olvasnivaló
A lecke témájának hivatalos dokumentációi és alapvető cikkei:
• scikit-learn — keresztvalidáció — scikit-learn.org
• Srivastava és mtsai.: Dropout (JMLR, 2014) — jmlr.org