21. lecke
Osztályozás a gyakorlatban: építsünk egy spam-szűrőt
nn.CrossEntropyLoss, softmax, és a regresszió->osztályozás váltás
Eddig a modelljeink számot jósoltak (árat, vásárlásszámot). Most egy másik alapfeladat jön: az osztályozás, amikor a modell kategóriát választ. Egy egyszerű spamszűrőt építesz: megnézzük, mi változik a modellben és a hibafüggvényben, hogyan lesz a softmax segítségével a nyers kimenetből valószínűség, hogyan tanítsd és értékeld a modellt, és hogyan osztályozz vele egy új e-mailt.
- Mi változik, ha "osztályozunk" "szám jóslás" helyett?
- Az adatok: egyszerűsített "szöveg -> szám" átalakítás
- A modell és a hibafüggvény
- A softmax: hogyan lesz "logit"-ból valószínűség?
- A tanítási ciklus (ugyanaz az 5 lépés, mint a 14. leckében!)
- Kiértékelés: mennyire jó a modellünk?
- Új email osztályozása, emberi szemmel olvasható formában
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 8 rész · 20 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Eddig minden modellünk (12, 14, 15. lecke) regressziós volt — egy számot jósoltak (ár, vásárlásszám). Ez a lecke a 14b lecke rész 2 különbségtételét ("regresszió vs. osztályozás") viszi át a gyakorlatba: egy valódi osztályozó modellt építünk, ami eldönti, "spam" vagy "nem spam" egy email.
Mert most már tudod, hogyan válasszuk szét az adatot (train/ validation/test — 20. lecke) — ez egy valódi, teljes projekt lesz, ami minden, eddig tanult elemet (14b algoritmus-térkép, 15. lecke 7 lépéses váz, 20. lecke adatszétválasztás) egyetlen, új típusú (osztályozási) feladatba gyúr össze.
import torch
import torch.nn as nn
import pandas as pd
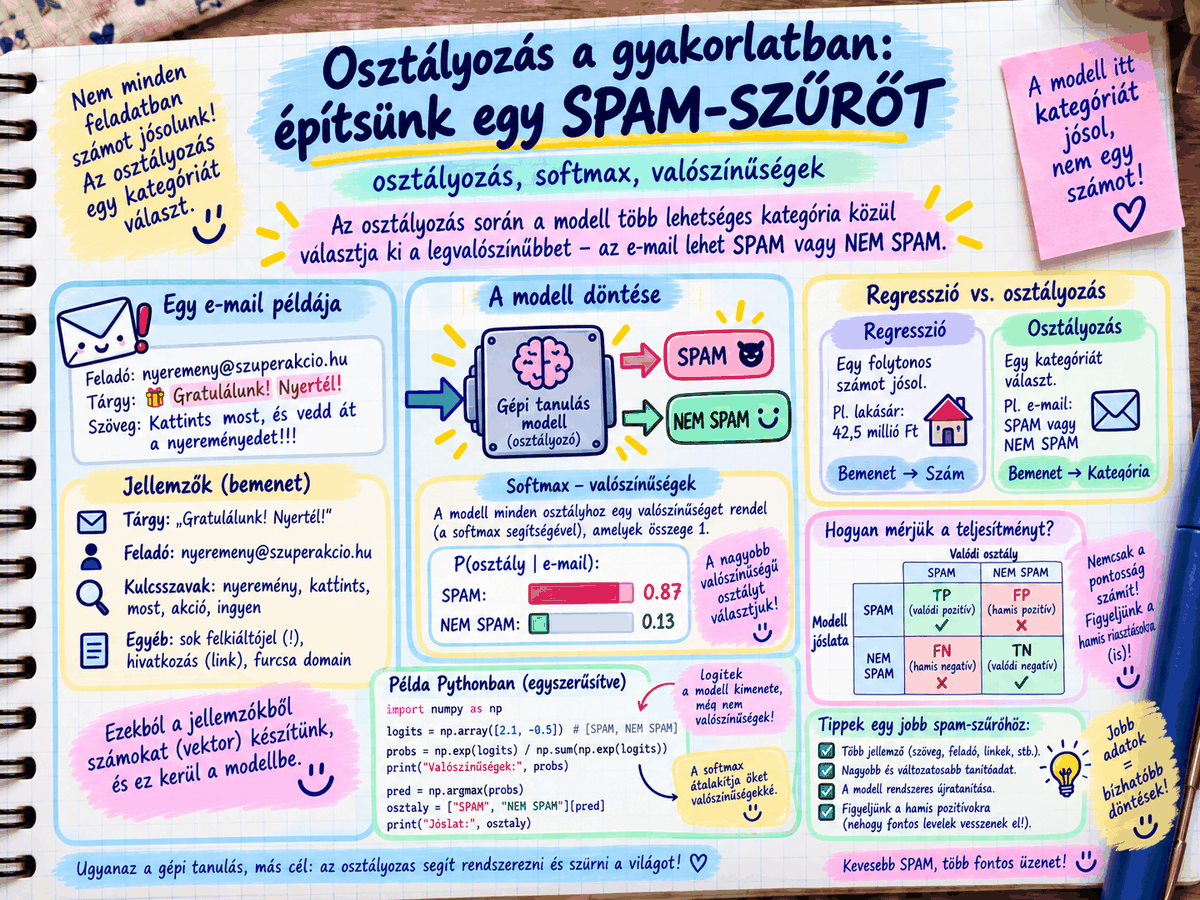
Rész 1 — Mi változik, ha "osztályozunk" "szám jóslás" helyett?
Emlékeztető a 14b leckéből (rész 2): regressziónál a kimenet egy folytonos szám (pl. 3450 ezer Ft) — osztályozásnál a kimenet egy véges kategória-halmazból választott címke (pl. "spam" vagy "nem spam").
Ez három dolgot változtat meg a 14/15. lecke kódjához képest:
1. a modell utolsó rétegének mérete: regressziónál 1 kimeneti érték volt elég (pl. "az ár") — osztályozásnál annyi kimeneti érték kell, ahány kategória van (itt: 2 — "spam" és "nem spam").
2. a hibafüggvény: regressziónál nn.MSELoss()-t használtunk (14. lecke) — osztályozásnál nn.CrossEntropyLoss()-t használunk (lásd rész 3).
3. az eredmény értelmezése: regressziónál a kimeneti szám maga a válasz volt — osztályozásnál a kimenetet át kell alakítani valószínűséggé, majd ki kell választani a legvalószínűbb kategóriát (lásd rész 4).
Rész 2 — Az adatok: egyszerűsített "szöveg -> szám" átalakítás
Egy valódi spam-szűrő szöveget olvas — hogyan lesz ebből szám, amit a modell feldolgozhat? Emlékeztető a 17. leckéből (tokenizálás/embedding): egy valódi nyelvi modell bonyolult módszerekkel alakítja szöveggé a számokat. Ebben a leckében, a tanulás kedvéért, egy sokkal egyszerűbb megközelítést használunk: minden emailt néhány egyszerű, számszerűsíthető tulajdonsággal ("feature"-rel) írunk le (pl. "hány 'gyanús' szó van benne", "hány felkiáltójel van benne", "tartalmaz-e linket") — ez a "feature engineering" (jellemző-kinyerés) nevű technika egyszerűsített változata, ami a gépi tanulás egyik alapvető, régebbi (a mély tanulás előtti) módszere volt.
A címke: 0 = "nem spam", 1 = "spam"
adatok = pd.DataFrame({
    "gyanus_szavak_szama": [0, 1, 5, 0, 6, 1, 0, 7, 2, 0,
                              8, 0, 1, 6, 0, 9, 1, 0, 5, 0],
    "felkialtojel_szama": [0, 0, 4, 1, 5, 0, 0, 6, 1, 0,
                             7, 0, 0, 3, 1, 8, 0, 0, 4, 1],
    "van_link": [0, 0, 1, 0, 1, 0, 0, 1, 0, 0,
                  1, 0, 0, 1, 0, 1, 0, 0, 1, 0],
    "spam": [0, 0, 1, 0, 1, 0, 0, 1, 0, 0,
              1, 0, 0, 1, 0, 1, 0, 0, 1, 0]
})print("AZ ADATOK ELSŐ SORAI:")
print(adatok.head())
print()Miért 0/1, nem 'spam'/'nem spam' szövegként a címke? Emlékeztető a 13. leckéből: a PyTorch (és minden gépi tanulási könyvtár) csak számokkal tud dolgozni. Ezért a kategóriákat mindig számkóddá alakítjuk át ("label encoding") — a 0 és 1 itt nem mennyiséget jelent (nem "1 spam = kétszer annyi, mint 0 spam"), hanem csupán két különböző kategória "címkéje."
A 2000-es évek elejétől a spamszűrők klasszikus eszköze a „naiv Bayes” osztályozó volt: megszámolta, mely szavak fordulnak elő gyakrabban spam, mint normál levelekben, és ezekből a gyakoriságokból számolt valószínűséget. Ez a mély tanulás előtti korszak egyik legsikeresebb, legelterjedtebb gépi tanulási módszere volt — sok levelezőrendszer még ma is használ hasonló, egyszerűbb statisztikai módszereket az AI-alapú szűrés mellett.
Rész 3 — A modell és a hibafüggvény
X = torch.tensor(
    adatok[["gyanus_szavak_szama", "felkialtojel_szama", "van_link"]].values,
    dtype=torch.float32
)A nn.CrossEntropyLoss kifejezetten egész szám (integer) típusú címkét vár, ami az osztály indexét jelöli (0. osztály, 1. osztály, stb.) — ez más, mint a regressziós float típus, mert itt nem "mennyiséget", hanem "kategória-azonosítót" tárolunk.
y = torch.tensor(adatok["spam"].values, dtype=torch.long)
print(f"X (bemenet) alakja: {X.shape}")
print(f"y (címkék) alakja: {y.shape}")
print(f"y első néhány értéke: {y[:5]}\n")class SpamSzuroModell(nn.Module):
def __init__(self):
super().__init__()
self.reteg1 = nn.Linear(3, 8) # 3 bemeneti jellemző -> 8 rejtett érték
self.aktivacio = nn.ReLU()
self.reteg2 = nn.Linear(8, 2) # 8 rejtett érték -> 2 KIMENET (2 osztály!) def forward(self, x):
x = self.reteg1(x)
x = self.aktivacio(x)
x = self.reteg2(x)
return xMiért 2 a reteg2 kimeneti mérete, ha csak egy választ (spam vagy nem spam) akarunk? Ez a leggyakoribb kezdő félreértés osztályozásnál! A modell nem egyetlen "0 vagy 1" értéket ad ki, hanem minden egyes lehetséges osztályhoz egy "pontszámot" ("logit"): "mennyire valószínűnek tartom, hogy ez a 0. osztály" és "mennyire valószínűnek tartom, hogy ez az 1. osztály" — ez a két szám együtt alkotja a kimenetet, és ezekből számoljuk ki (rész 4) a végső döntést.
model = SpamSzuroModell()
hibafuggveny = nn.CrossEntropyLoss()
optimalizalo = torch.optim.SGD(model.parameters(), lr=0.01)
Mi az a CrossEntropyLoss pontosan, mit csinál másként, mint az MSELoss? Emlékeztető a 14. leckéből: az MSELoss a jósolt és valós szám közötti négyzetes eltérést méri — ez osztályozásnál nem értelmes (mi lenne a "négyzetes eltérés" "spam" és "nem spam" között?). A CrossEntropyLoss ehelyett: (1) a modell "logit" kimeneteit először egy "softmax" nevű művelettel valószínűségi eloszlássá alakítja (lásd rész 4), majd (2) megnézi: "mennyi valószínűséget adott a modell a helyes osztálynak?" — ha a modell a helyes osztálynak magas valószínűséget adott, a hiba kicsi; ha alacsonyat (vagy rosszul tippelt), a hiba nagy — ez a 14b lecke rész 2-ben már említett, osztályozáshoz illő hibafüggvény.
A valóságban a legtöbb levél nem spam — ha például csak 5% a spam aránya, egy modell, ami MINDIG „nem spam”-et jósol, már 95%-os pontosságot mutatna, miközben egyetlen spam levelet sem szűrne ki. Emiatt kell a 24. leckében tanult precision/recall-féle mérőszám: ezek megmutatják, hogy a modell a ritkább osztályon (itt: a spamen) is ténylegesen jól teljesít-e.
Rész 4 — A softmax: hogyan lesz "logit"-ból valószínűség?
A softmax függvény minden egyes "logit" (nyers pontszám) értéket átalakít egy 0 és 1 közötti számmá, úgy, hogy az összes osztályra kapott valószínűség összege pontosan 1 (100%) legyen — ez teszi lehetővé, hogy "valószínűségként" értelmezzük az eredményt.
Képlet (2 osztályra egyszerűsítve, de általánosan is igaz több osztályra):
valoszinuseg(i. osztály) = e^(logit_i) / (e^(logit_1) + e^(logit_2) + ...)
(az "e" itt a természetes logaritmus alapszáma, kb. 2.718 — ez a kiválasztás biztosítja, hogy minden érték pozitív legyen, és hogy a nagyobb logit arányaiban is nagyobb valószínűséget kapjon.)
Nem — a nn.CrossEntropyLoss belsejében már tartalmazza a softmax számítást (ezért nem kell külön nn.Softmax réteget hozzáadnod a modellhez tanításkor) — de ha a kész, betanított modelltől emberi szemmel olvasható valószínűségeket akarsz látni (pl. "82% eséllyel spam"), akkor manuálisan használod a torch.softmax() függvényt (lásd rész 6).
Rész 5 — A tanítási ciklus (ugyanaz az 5 lépés, mint a 14. leckében!)
print("TANÍTÁS FOLYAMATBAN...")
for korszak in range(500):
    joslat = model(X)                     # itt MOST 2 LOGIT-ot ad vissza MINDEN sorra
hiba = hibafuggveny(joslat, y) optimalizalo.zero_grad()
hiba.backward()
optimalizalo.step() if korszak % 50 == 0:
print(f" Korszak {korszak:>3}, hiba: {hiba.item():.4f}")print("TANÍTÁS BEFEJEZVE.\n")Ez szó szerint ugyanaz az 5 sor, mint a 14. leckében — semmi nem változott? Pontosan ez a lecke egyik legfontosabb tanulsága: a tanítási ciklus (predikció -> hiba -> zero_grad -> backward -> step) teljesen független attól, hogy regressziós vagy osztályozási feladatot oldasz meg — csak a modell utolsó rétege és a hibafüggvény változik. Ez mutatja, mennyire általános, újrafelhasználható elv a gradiens ereszkedés (12b, 14C lecke).
Rész 6 — Kiértékelés: mennyire jó a modellünk?
with torch.no_grad():
    logitek = model(X)
    valoszinusegek = torch.softmax(logitek, dim=1)
    joslatok = torch.argmax(valoszinusegek, dim=1)
Mi az az argmax? Az argmax függvény megmondja, melyik osztály kapta a legnagyobb valószínűséget — ha az 1. osztályra ("spam") 82%, a 0. osztályra ("nem spam") 18% valószínűséget számolt a modell, az argmax "1"-et ad vissza (a nagyobb valószínűségű osztály indexét) — ez a végső, "kerek" döntés.
Az 50%-os küszöb csak egy kényelmes alapbeállítás — a gyakorlatban ezt gyakran állítják. Egy spamszűrőnél például sokszor szigorúbb (pl. 80-90%-os) küszöböt választanak, mert egy tévesen spamnek jelölt fontos levél (hamis pozitív) sokkal kellemetlenebb következménnyel jár, mint néhány spam levél átengedése.
pontossag = (joslatok == y).float().mean().item()
print(f"A modell pontossága a TELJES adathalmazon: {pontossag*100:.1f}%")
print("(FIGYELEM: ez a TELJES adathalmazon mért érték — a 20.")
print(" LECKÉBŐL TUDOD, hogy ez ÖNMAGÁBAN NEM elég a VALÓDI")
print(" teljesítmény MEGÍTÉLÉSÉHEZ — a 24. LECKÉBEN TOVÁBB")
print(" MÉLYÍTJÜK EZT a TÉMÁT precision/recall/F1 mérőszámokkal!)\n")
Rész 7 — Új email osztályozása, emberi szemmel olvasható formában
def email_osztalyozasa(gyanus_szavak, felkialtojelek, van_link_e):
    """
    Egy ÚJ, EDDIG NEM LÁTOTT emailt osztályoz, és EMBERI SZEMMEL
    OLVASHATÓ VALÓSZÍNŰSÉGGEL EGYÜTT adja vissza az eredményt —
    hasonlóan a 12b lecke josolj_megbizhatosaggal() függvényéhez,
    csak itt OSZTÁLYOZÁSI kontextusban.
    """
    bemenet = torch.tensor([[float(gyanus_szavak), float(felkialtojelek), float(van_link_e)]])
    with torch.no_grad():
        logit = model(bemenet)
valoszinuseg = torch.softmax(logit, dim=1)[0] nem_spam_valoszinuseg = valoszinuseg[0].item() * 100
spam_valoszinuseg = valoszinuseg[1].item() * 100 print(f"Bemenet: {gyanus_szavak} gyanús szó, {felkialtojelek} felkiáltójel, "
f"link: {'igen' if van_link_e else 'nem'}")
print(f" Nem spam valószínűség: {nem_spam_valoszinuseg:.1f}%")
print(f" Spam valószínűség: {spam_valoszinuseg:.1f}%") if spam_valoszinuseg > 50:
print(" -> DÖNTÉS: SPAM")
else:
print(" -> DÖNTÉS: NEM SPAM")
print("-" * 50)print("PRÓBAKÉRDEZÉSEK ÚJ EMAILEKRE:")
email_osztalyozasa(gyanus_szavak=0, felkialtojelek=0, van_link_e=0) # valószínűleg nem spam
email_osztalyozasa(gyanus_szavak=7, felkialtojelek=6, van_link_e=1) # valószínűleg spam
email_osztalyozasa(gyanus_szavak=3, felkialtojelek=2, van_link_e=0) # bizonytalan esetÖsszefoglaló: regresszió vs. osztályozás, egymás mellett
| Szempont | regresszió (15. lecke) | osztályozás (ez a lecke) |
|---|---|---|
| Kimenet típusa | 1 folytonos szám | N logit (N = osztályszám) |
| Utolsó réteg mérete | nn.Linear(..., 1) | nn.Linear(..., N) |
| Hibafüggvény | nn.MSELoss() | nn.CrossEntropyLoss() |
| Címke típusa (y) | float | long (egész szám, osztály-index) |
| Eredmény értelmezése | a szám maga a válasz | softmax -> argmax |
1. Futtasd le a kódot — nézd meg a "bizonytalan eset" (3 gyanús szó, 2 felkiáltójel, nincs link) valószínűségeit — mennyire közel vannak 50-50%-hoz? Mit gondolsz, miért bizonytalan a modell ebben az esetben (nézd meg az adatok táblázatát — van-e hasonló, "közepes" eset a tanító adatok között)?
2. Bővítsd a modellt egy harmadik osztállyal: "gyanús, de bizonytalan" (pl. amikor 3-4 gyanús szó van) — mi változna a kódban (gondold végig: a reteg2 mérete, az y címkék)?
3. Új gyakorlat: a 20. leckében tanult train/test szétválasztás alkalmazásával módosítsd ezt a kódot: válaszd szét az adatot tanító (80%) és teszt (20%) részre, tanítsd a modellt csak a tanító részen, majd számold ki a pontosságot külön a teszt részen — egyezik-e a két pontosságérték (teljes vs. csak teszt)?
Források és további olvasnivaló
A lecke témájának hivatalos dokumentációi és alapvető cikkei:
• PyTorch — CrossEntropyLoss — pytorch.org