22. lecke
Adat-előkészítés mélyebben: skálázás, encoding, adatbővítés
Miért kellett a 15. leckében olyan apró tanulási rátát (lr) választani? Itt a válasz — és az is, hogyan kerüld el ezt a problémát a jövőben.
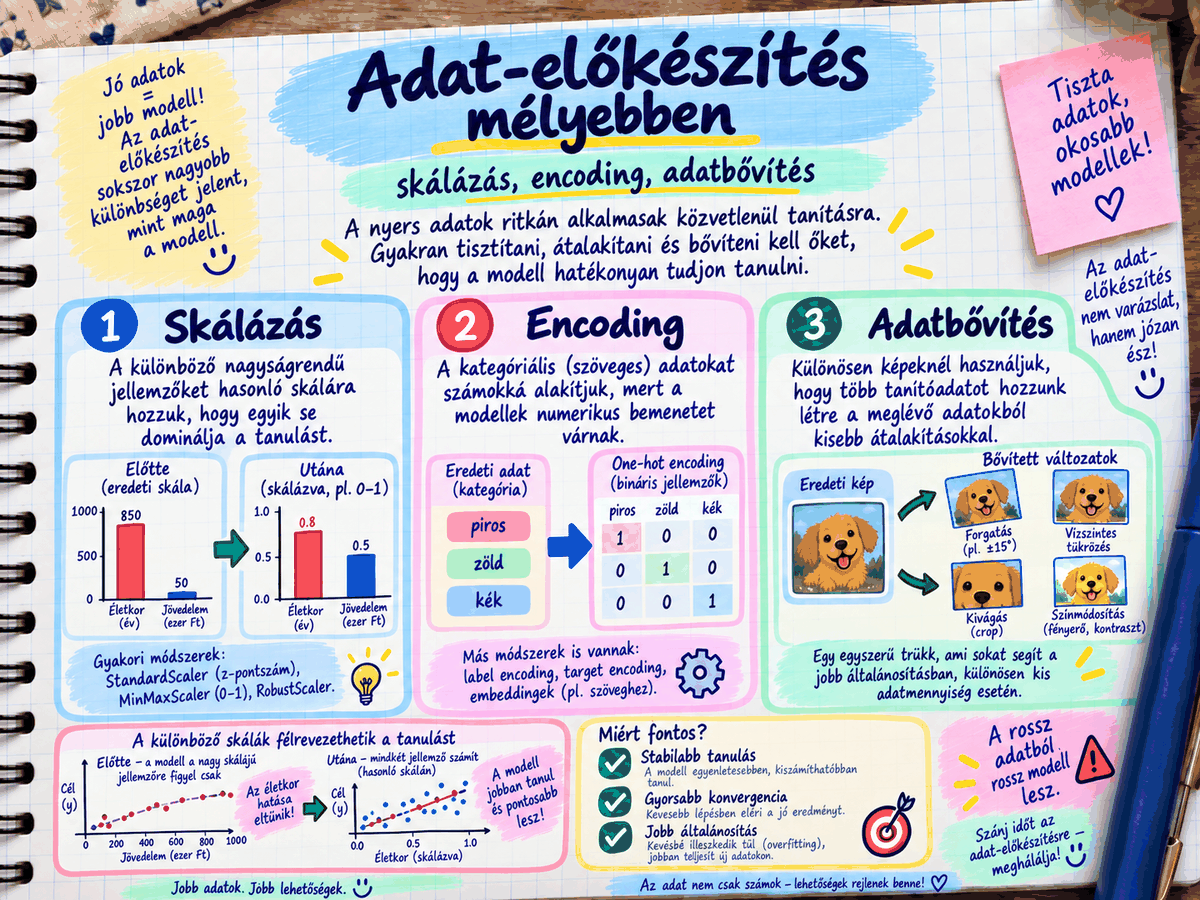
A 15. leckében furcsán apró tanulási rátát kellett választani, hogy a modell működjön. Ez a lecke megmutatja, miért — és hogyan oldják meg ezt a gyakorlatban. Megtanulod az adatok skálázását (normalizálás, sztenderdizálás), újratanítod a 15. lecke modelljét skálázott adatokkal, megismered a one-hot encodingot a kategorikus adatokhoz, és az adatbővítést, amellyel kevés adatból is több tanítópélda lesz.
- A probléma: miért kellett a 15. leckében olyan apró lr?
- Normalizálás (min-max scaling)
- Sztenderdizálás (standardization / z-score)
- A 15. lecke újratanítása, skálázott adatokkal
- One-hot encoding: kategorikus adatok számmá alakítása
- Adatbővítés (data augmentation): több adat "varázslása"
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 7 rész · 13 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Szándékosan most, mert a 15. leckében saját bőrödön tapasztaltad a problémát (az lr=0.00001 Furcsán apró szám volt) — most, hogy már érted a tanítási ciklus mechanizmusát, készen állsz megérteni, miért volt erre szükség, és hogyan oldják ezt meg a gyakorlatban, profi módon.
import numpy as np
import pandas as pd
import torch
Rész 1 — A probléma: miért kellett a 15. leckében olyan apró lr?
Emlékeztető a 15. leckéből: a "látogatók" értékei 90-800 között mozogtak, a "vásárlások" értékei 2-23 között — ez a két skála nagyon különböző méretű (kb. 35-Szörös különbség).
Miért probléma, ha a bemenet és a kimenet különböző skálán van? Emlékeztető a 14c. leckéből: a tanítás során a gradiens (derivált) megmondja, "merre és mennyit" módosítsunk egy paramétert. Ha a bemeneti értékek nagyok (pl. 800), már egy apró súly-változás is hatalmas kimeneti változást okoz (mert az eredmény = súly * 800, tehát a súly bármilyen kicsi változása 800-szorozódik) — ezért kellett olyan "apró" lr-t (0.00001) használni, hogy a modell ne "túllöje" a célt minden egyes lépésben.
Ha viszont a bemeneti értékek kicsik, vagy különböző jellemzők (feature-ök) nagyon különböző skálán vannak (pl. "km_futott": 10000-150000, "évjárat": 2010-2024 — a kettő között ezerszeres a különbség), a modellnek sokkal nehezebb egyszerre jól beállítani mindkét paramétert — az egyik túlreagál, a másik alig mozdul, ugyanazzal a tanulási rátával.
A Megoldás: a bemeneti adatokat már a tanítás előtt "átszámoljuk" egy közös, kis skálára — ezt hívjuk skálázásnak (feature scaling).
Rész 2 — Normalizálás (min-max scaling)
A Normalizálás minden értéket egy 0 és 1 közötti tartományba alakít át, a következő képlettel:
normalizalt_ertek = (eredeti_ertek - minimum) / (maximum - minimum)
Hogyan működik ez a képlet pontosan? Ha az eredeti érték a minimum, a képlet (min - min) / (max - min) = 0-t ad. Ha az eredeti érték a maximum, a képlet (max - min) / (max - min) = 1-et ad. Minden köztes érték arányosan esik 0 és 1 közé — ez pontosan az az "arányosítás", amit a 12b lecke "tartomány-ellenőrzés" függvényében már használtunk (min/max értékek), csak most nem ellenőrzésre, hanem átalakításra használjuk.
print("PÉLDA: NORMALIZÁLÁS KÉZZEL")
print("=" * 50)latogatok = np.array([90, 200, 400, 610, 800])
print(f"Eredeti értékek: {latogatok}")minimum = latogatok.min()
maximum = latogatok.max()
normalizalt = (latogatok - minimum) / (maximum - minimum)
print(f"Normalizált értékek (0-1 között): {normalizalt.round(3)}")
print()Rész 3 — Sztenderdizálás (standardization / z-score)
Egy másik, gyakran jobban működő módszer a sztenderdizálás, ami nem 0-1 közé szorítja az értékeket, hanem úgy alakítja át őket, hogy az átlaguk 0, a szórásuk (a "szétszóródás" mértéke) pedig 1 legyen:
sztenderdizalt_ertek = (eredeti_ertek - atlag) / szoras
Miért kellene egy másik módszer, ha a normalizálás már működik? A normalizálás érzékeny a szélsőséges értékekre ("outlier"-ekre) — ha egyetlen adatpontban valami hiba miatt egy irreálisan nagy érték szerepel (pl. "800" helyett "8000000" egy elgépelés miatt), az egész skála "összenyomódik" a többi, normális érték körül — a sztenderdizálás (ami az átlagra és szórásra épül, nem a min/max értékekre) kevésbé érzékeny erre a problémára, ezért a gyakorlatban gyakran ezt részesítik előnyben.
print("PÉLDA: SZTENDERDIZÁLÁS KÉZZEL")
print("=" * 50)atlag = latogatok.mean()
szoras = latogatok.std()
sztenderdizalt = (latogatok - atlag) / szoras
print(f"Eredeti értékek: {latogatok}")
print(f"Átlag: {atlag:.1f}, Szórás: {szoras:.1f}")
print(f"Sztenderdizált értékek: {sztenderdizalt.round(3)}")A negatív sztenderdizált értékek az átlag alatti, a pozitívak pedig az átlag feletti eredeti értékeknek felelnek meg.
Melyiket használjam: normalizálás vagy sztenderdizálás? Általános ökölszabály: ha tudod, hogy az adataid nagyjából "normális eloszlásúak" (a legtöbb érték az átlag körül csoportosul), a sztenderdizálás általában jobb választás. Ha tudod a pontos min/max határokat, és nincsenek szélsőséges kiugró értékek, a normalizálás is jól működik. A gyakorlatban gyakran egyszerűen mindkettőt kipróbálják, és a 20. leckében tanult validációs halmazon mérik, melyik ad jobb eredményt.
Rész 4 — A 15. lecke újratanítása, skálázott adatokkal
Nézzük meg konkrétan, hogyan változik a 15. lecke projektje, ha először skálázzuk az adatot.
adatok = pd.DataFrame({
    "latogatok": [120, 250, 340, 410, 480, 90, 610, 730, 800, 150,
                  270, 390, 550, 640, 720, 200, 310, 460, 590, 680],
    "vasarlasok": [3, 7, 9, 12, 14, 2, 18, 21, 23, 4,
                   8, 11, 16, 19, 21, 5, 9, 13, 17, 20]
})
Sztenderdizálás mindkét oszlopra
latogatok_atlag = adatok["latogatok"].mean()
latogatok_szoras = adatok["latogatok"].std()
vasarlasok_atlag = adatok["vasarlasok"].mean()
vasarlasok_szoras = adatok["vasarlasok"].std()
adatok["latogatok_skalazott"] = (adatok["latogatok"] - latogatok_atlag) / latogatok_szoras
adatok["vasarlasok_skalazott"] = (adatok["vasarlasok"] - vasarlasok_atlag) / vasarlasok_szoras
print("SKÁLÁZOTT ADATOK ELSŐ 5 SORA:")
print(adatok[["latogatok", "latogatok_skalazott", "vasarlasok", "vasarlasok_skalazott"]].head())
print()Mivel most mindkét oszlop nagyjából -2 és +2 között mozog (ez a sztenderdizálás természetes következménye), a tanulási ráta már nem kell, hogy olyan extrém apró legyen — egy "normálisabb" érték, pl. lr=0.01 Vagy lr=0.001 Már jól működne, és a tanítás is gyorsabban, stabilabban konvergálna (érne célba).
Fontos gyakorlati megjegyzés: ha skálázott adaton tanítasz, a modell kimenete is a skálázott tartományban lesz — ezért az előrejelzés után "vissza kell alakítanod" (de-standardizálni) az eredeti skálára:
eredeti_ertek = sztenderdizalt_ertek * szoras + atlag
Ez a "visszaalakítás" lépés könnyen elfelejthető, de nélkülözhetetlen — különben a végső válaszod (pl. "0.34 vásárlás" helyett "14.2 vásárlás") értelmezhetetlen lenne a felhasználó számára.
print("PÉLDA: VISSZAALAKÍTÁS (DE-STANDARDIZÁLÁS)")
egy_skalazott_ertek = 0.85  # ez egy PÉLDA "modell kimenet" lenne
visszaalakitott = egy_skalazott_ertek * vasarlasok_szoras + vasarlasok_atlag
print(f"Skálázott érték: {egy_skalazott_ertek} -> Eredeti skálán: {visszaalakitott:.1f} vásárlás\n")
Rész 5 — One-hot encoding: kategorikus adatok számmá alakítása
Emlékeztető a 21. leckéből: ott a címkét (spam/nem spam) egyszerű 0/1 számmá alakítottuk — ez működik, ha csak két kategória van, és a kettő között nincs "sorrend" (nem "jobb" a spam=1, mint a nem_spam=0).
De mi van, ha három vagy több, egymástól független kategória van (pl. "piros", "kék", "fekete")? Ha egyszerűen 0, 1, 2-nek kódolnánk őket, a modell tévesen azt "hihetné", hogy "fekete" (2) kétszer "több" vagy "nagyobb", mint "kék" (1) — holott ezek csak különböző, egymással össze nem hasonlítható kategóriák.
A Megoldás: one-hot encoding — minden kategóriához egy külön, 0/1 értékű oszlopot hozunk létre ("csak egy lehet 1, a többi 0" — innen a "one-hot" [egy-forró] név).
szinek = pd.DataFrame({"szin": ["piros", "kék", "fekete", "piros", "kék"]})
print("EREDETI KATEGORIKUS ADAT:")
print(szinek)
print()szinek_one_hot = pd.get_dummies(szinek["szin"], dtype=int)
print("ONE-HOT ENCODING UTÁN:")
print(szinek_one_hot)
print()Miért nem 'drága' ez a módszer, ha sok kategória van (pl. 1000-Féle terméktípus)? Ez valóban egy gyakorlati korlát — ha nagyon sok (százas, ezres nagyságrendű) kategória van, a one-hot encoding nagyon sok új oszlopot hoz létre, ami megnöveli a modell méretét és a számítási igényt — ilyen esetekben más technikákat (pl. az embedding-et, amit a 17. leckében már megismertél szavakra alkalmazva) használnak, ami sokkal tömörebb módon kódolja a kategóriákat.
Rész 6 — Adatbővítés (data augmentation): több adat "varázslása"
Igen — ez az adatbővítés (data augmentation) szerepe: a meglévő adatokból, kis, kontrollált módosításokkal, új, mesterséges tanító példákat hozunk létre.
Ez leggyakrabban képeknél használt módszer (emlékeztető a 14b lecke CNN-részére): egy meglévő tanító képből létre lehet hozni további, új változatokat:
- Elforgatás (pl. 5-10 fokkal jobbra/balra)
- Tükrözés (vízszintesen vagy függőlegesen)
- Zoom/kivágás (a kép egy részletének kinagyítása)
- Fényesség/kontraszt módosítása
- Zaj hozzáadása (apró, véletlenszerű pixel-változtatások)
Miért nem 'csalás' ez — hiszen technikailag nem új, valós adatot adunk a modellhez? Mert a cél nem az, hogy "többnek tűnjön" az adat — hanem, hogy a modell megtanulja: "egy macska akkor is macska, ha kicsit el van forgatva, vagy ha a kép kicsit sötétebb" — ez pontosan az az általánosítási képesség, amit a 20. leckében a túltanulás ellen való védekezésként már megismertél (a regularizáció egy másik formája, csak itt nem a modellt, hanem magát az adatot "változatosabbá" tesszük).
Szöveges adatoknál (a 17. lecke kontextusában) is léteznek hasonló technikák (pl. Szinonimák cseréje, mondatok átfogalmazása), de ez óvatosabb bánásmódot igényel, mert a nyelvi jelentés könnyebben "eltorzulhat", mint egy kép.
Összefoglaló táblázat
| Technika | Mire való? | Mikor használd? |
|---|---|---|
| Normalizálás (min-max) | Számok 0–1 közé alakítása | Ismert min/max, kevés kiugró érték |
| Sztenderdizálás (z-score) | Számok átlag = 0, szórás = 1 formára alakítása | Normális eloszlású adat; kiugró értékek esetén is stabilabb |
| One-hot encoding | Kategorikus adat számmá alakítása | Kevés (néhány tucat) kategóriánál |
| Adatbővítés | Mesterséges új tanító példák létrehozása | Kevés valós adat; képeknél különösen gyakori |
1. Futtasd le a rész 4 kódját, majd módosítsd a 15. lecke teljes projektjét: használd a "latogatok_skalazott" és "vasarlasok_skalazott" oszlopokat a "latogatok"/"vasarlasok" helyett a tanításhoz, és próbálj ki egy nagyobb (pl. lr=0.01) tanulási rátát — gyorsabban csökken-e a hiba, mint az eredeti, lr=0.00001-es verzióban?
2. Ne felejtsd el a visszaalakítást (rész 4 vége) — ha a modelled skálázott adaton tanult, a joslas_megbizhatosaggal() függvény (15. lecke) eredményét is vissza kell alakítanod az eredeti "vásárlásszám" skálára, mielőtt kiíratnád.
3. Új gyakorlat: a 21. lecke spam-szűrő projektjéhez adj hozzá egy negyedik, kategorikus jellemzőt (pl. "feladó típusa": "ismert", "ismeretlen", "korábban_letiltott") — alakítsd át one-hot encoding-gal, és gondold végig: hogyan változna a modell reteg1 = nn.Linear(3, 8) sora, ha most már több bemeneti oszlopod van?
Források és további olvasnivaló
A lecke témájának hivatalos dokumentációi és alapvető cikkei:
• scikit-learn — adat-előfeldolgozás — scikit-learn.org