23. lecke
Előtanított modellek, Transfer Learning, Fine-Tuning
A valós AI-munka nagy része: nem nulláról építeni, hanem már kész, óriási modellt igazítani a saját feladatodra
A valós AI-munkában ritkán építenek nulláról modellt: sokkal gyakoribb, hogy egy már kész, hatalmas adaton előtanított modellt igazítanak a saját feladathoz. Ez a lecke elmagyarázza az átviteli tanulás (transfer learning) és a finomhangolás lényegét, azt, hogy miért működik (a rétegek „szakosodása"), bemutat egy konkrét példát, kitér a nyelvi modellekre, és segít eldönteni, mikor érdemes mégis saját modellt építeni.
- Mi az a transfer learning (átviteli tanulás)? — az alapötlet
- Miért működik ez? A rétegek "szakosodása"
- Konkrét példa: egy előtanított modell használata (torchvision, képfelismeréshez)
- Nyelvi modelleknél: hogyan néz ki ez ott?
- Mikor érdemes saját modellt nulláról építeni, és mikor transfer learning-et…
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 5 rész · 7 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Eddig minden modellünket (12-21. lecke) nulláról, a saját, kis adathalmazunkon tanítottuk — ez tökéletes volt a tanuláshoz, de a valós, ipari gyakorlatban ez ritkán a helyes megközelítés. Ez a lecke megmutatja, miért, és hogyan csinálják a profik.
Mert a te 20 adatpontos weboldal-példád (15. lecke) egy tanulási gyakorlat volt — de egy valódi, profi képfelismerő modellhez (pl. "ismerd fel, elromlott-e egy alkatrész") milliónyi, gondosan címkézett kép kellene (emlékeztető a 19. leckéből: az ImageNet projekt is évekig tartó munka volt) — a legtöbb kisvállalkozás soha nem fog ennyi adatot összegyűjteni. A transfer learning pontosan erre a problémára a válasz.
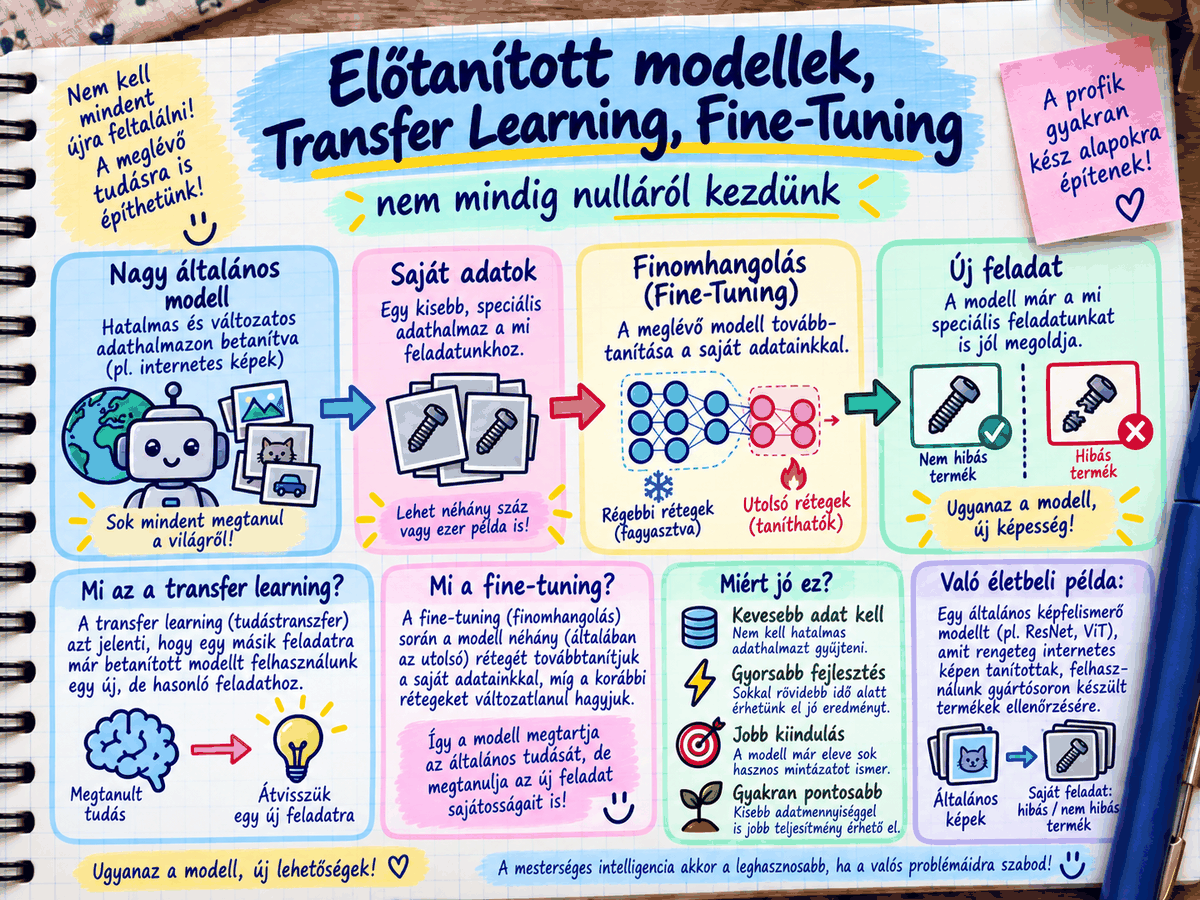
Rész 1 — Mi az a transfer learning (átviteli tanulás)? — az alapötlet
Hasonlat: képzeld el, hogy egy tapasztalt zongoristának orgonán kell megtanulnia játszani. Nem a nulláról kezdi — már tudja a kottát, a ritmust, az ujjrendet —, csak az új hangszer sajátosságait (pedálok, regiszterek) kell megtanulnia. Ez sokkal gyorsabb, mint ha valaki, aki soha nem játszott hangszeren, próbálná megtanulni ugyanazt.
Ez pontosan a transfer learning (átviteli tanulás) elve: egy már meglévő, hatalmas adathalmazon betanított modell már "tud" általános, alapvető mintázatokat (pl. egy képfelismerő modell már tudja, mi az az "él", "sarok", "textúra", "szín" — emlékeztető a 14b lecke CNN-részére) — és ezt a meglévő tudást "átvisszük", és csak egy kis, záró részét tanítjuk tovább a saját, specifikus feladatodra.
Pontosan ez ugyanaz az elv, csak általánosabban megfogalmazva! A 17. lecke "előtanítása" (a modell megtanulja az általános nyelvi mintázatokat hatalmas szövegen) és "finomhangolása" (a modell egy kisebb, célzott adathalmazon tovább tanul) egy konkrét példája a transfer learning általános elvének — ami nem csak nyelvi modellekre, hanem képfelismerésre, hangra, és számos más területre is alkalmazható.
Rész 2 — Miért működik ez? A rétegek "szakosodása"
Emlékeztető a 14b lecke CNN részére (3.7): egy képfelismerő háló több rétegből áll, és a rétegek egyre elvontabb mintázatokat ismernek fel:
- a Legelső rétegek: nagyon egyszerű, általános mintázatok (élek, sarokpontok, színátmenetek) — ezek gyakorlatilag minden képfelismerési feladatnál ugyanazok, legyen szó macskáról, autóról, vagy egy szervizbe behozott alkatrészről.
- a középső rétegek: összetettebb mintázatok (textúrák, formák, minták részletei) — ezek már kicsit specifikusabbak, de még mindig sok feladat között átvihetők.
- az utolsó rétegek: nagyon specifikus, a konkrét feladatra jellemző mintázatok (pl. "ez pontosan egy adott márkájú alkatrész jellegzetes repedése") — ezek már nem általánosak, ezeket kell újratanítani a saját feladatodra.
A Transfer learning stratégiája ezért általában:
- Veszel egy már betanított modellt (pl. egy, ami milliónyi általános képen tanult).
- "Befagyasztod" (frozen — vagyis nem engeded tovább módosítani) az első, általános rétegeket — ezeket nem kell újratanítani, már jók.
- Lecseréled (vagy tovább tanítod) csak az utolsó, pár réteget a saját, kis adathalmazodon.
Miért előnyös 'befagyasztani' a rétegeket, miért nem tanítjuk újra az egészet a saját adatunkon? Két ok: (1) sokkal kevesebb számítási erőforrás kell, ha csak az utolsó néhány réteget tanítod (emlékeztető a 18. leckére: egy teljes modell újratanítása óriási energia/költség lenne). (2) ha a saját adathalmazod kicsi (mint a te 20 soros weboldal- példád), és mégis engednéd, hogy a teljes, hatalmas modell újratanuljon rajta, a modell valószínűleg túltanulna (20. lecke!) — a "befagyasztás" egyfajta védelem ez ellen is.
Rész 3 — Konkrét példa: egy előtanított modell használata (torchvision, képfelismeréshez)
A következő kód bemutatja, hogyan néz ki ez a gyakorlatban — a torchvision könyvtár (a PyTorch "testvér-könyvtára", kifejezetten képfeldolgozáshoz) tartalmaz már betanított modelleket, amiket egyetlen sorban betölthetsz.
Fontos: ez a kód bemutató jellegű (illusztráció, hogyan nézne ki valós használatban) — a torchvision könyvtár telepítése (pip install torchvision) és az előtanított modell letöltése (ami néhány száz megabyte lehet) szükséges a tényleges futtatáshoz.
import torch
import torch.nn as nn
from torchvision import models
1. Lépés: betöltjük a már betanított modellt (ez a ResNet18, egy népszerű, ImageNet-en betanított képfelismerő háló — emlékeztető a 19. leckére: az ImageNet az a hatalmas adathalmaz, amit Fei-Fei Li hozott létre 2007-ben!)
elotanitott_modell = models.resnet18(weights="IMAGENET1K_V1")
2. Lépés: "befagyasztjuk" az összes meglévő réteget (a rész 2-ben leírt stratégia — megakadályozzuk, hogy ezek a rétegek tovább módosuljanak a saját tanításunk során)
for parameter in elotanitott_modell.parameters():
parameter.requires_grad = FalseEmlékeztető a 13. leckéből — a requires_grad=False azt jelenti, hogy a PyTorch nem számol deriváltat ehhez a paraméterhez, tehát az optimalizalo.step() során nem is módosul.
3. Lépés: lecseréljük az utolsó réteget a saját feladatunkra (pl. ha csak 2 kategóriánk van: "jó alkatrész" / "hibás alkatrész" — emlékeztető a 21. lecke osztályozási elvére!)
elotanitott_modell.fc = nn.Linear(elotanitott_modell.fc.in_features, 2)
Ez az új réteg alapértelmezetten requires_grad=True, tehát ez már tanulni fog a saját adatunkon.
4. Lépés: a tanítás ugyanúgy történik, mint eddig (14, 21. lecke) — csak most sokkal kevesebb paraméter tanul, és sokkal kevesebb saját adatra is elég (akár pár száz kép, nem millió!)
hibafuggveny = nn.CrossEntropyLoss()
optimalizalo = torch.optim.SGD(elotanitott_modell.fc.parameters(), lr=0.001)
Figyeld meg: az optimalizalo csak az elotanitott_modell.fc (az új, utolsó réteg) paramétereit kapja meg — a többi, befagyasztott réteget "nem is látja."
Rész 4 — Nyelvi modelleknél: hogyan néz ki ez ott?
Emlékeztető a 17. leckéből: egy nagy nyelvi modell (mint a GPT vagy a Claude mögöttes modellje) már önmagában a "előtanítás + finomhangolás" elvre épül — de ez a folyamat tovább folytatható: a már kész, nagy nyelvi modellt is lehet tovább finomhangolni egy adott vállalat/terület saját adataira (pl. "tanítsd meg a modellt a mi cégünk szakzsargonjára, termékeire").
Ez a gyakorlatban (a Hugging Face nevű, nyílt platformon, amelyet a 20. lecke gyakorló feladataiban már említettünk) így néz ki (ismét illusztratív, nem futtatandó kód):
from transformers import AutoModelForSequenceClassification, AutoTokenizer
1. Lépés: betöltünk egy már előtanított nyelvi modellt (a Hugging Face egy nyílt "tárház", ahol ezrek osztják meg a saját betanított modelljeiket, ingyen használható formában)
tokenizalo = AutoTokenizer.from_pretrained("bert-base-multilingual-cased")
modell = AutoModelForSequenceClassification.from_pretrained(
    "bert-base-multilingual-cased", num_labels=2
)
Ez a modell már "tud" magyarul (és több száz más nyelven) — emlékeztető a 17. lecke tokenizálás/embedding részére: ez a tudás már "benne van" a modellben, nem kell nulláról tanítanod.
2. Lépés: a saját, kis adathalmazodon (pl. néhány száz ügyfélvisszajelzés, "pozitív"/"negatív" címkével) tovább finomhangolod — ez ugyanaz a tanítási ciklus, mint eddig (predikció -> hiba -> backward -> step), csak a kiinduló pont már nem "véletlen súlyok" (14. lecke), hanem egy már nyelvet "ismerő" modell.
Rész 5 — Mikor érdemes saját modellt nulláról építeni, és mikor transfer learning-et használni?
| Szempont | Nulláról építés (12–21. lecke) | Transfer learning |
|---|---|---|
| Rendelkezésre álló adat | Kevés (10–1000 sor) | Kevés is elég lehet |
| Feladat jellege | Egyedi, specifikus számítás (pl. „km → ár") | Kép / szöveg / hang — általános mintázatok is szerepet játszanak |
| Szükséges számítási erőforrás | Kicsi (saját gépen is elég) | Az előtanított modell letöltése kell, de a továbbtanítás olcsó |
| Tanulási cél | Megérteni az alapelveket (ez a tananyag eddigi része!) | Gyorsan, hatékonyan megoldani egy valós problémát |
Kár volt mindent nulláról felépíteni? A lecke összegző tanulsága: a 12-22. leckékben tanult nulláról építés nem volt "felesleges" munka, még ha a gyakorlatban ritkán is építesz majd mindent nulláról — ellenkezőleg: pontosan azért érted most, hogy a rész 3-4 példakódjában mi történik ("requires_grad = False", "nn.Linear lecserélése", "CrossEntropyLoss"), mert végigcsináltad az alapokat. Egy olyan fejlesztő, aki csak a transfer learning kódját másolja be, de nem érti, mi történik a háttérben, nem tud hatékonyan hibát keresni, ha valami nem működik — te most már tudod.
1. Ha szeretnéd kipróbálni valósan (nem kötelező): telepítsd a torchvision könyvtárat (pip install torchvision), és futtasd a rész 3 kódját (kihagyva a "peldakod_szoveg" változóba csomagolást, vagyis ténylegesen lefuttatva a sorokat) — nézd meg, mennyi ideig tart a modell letöltése, és próbáld ki print(elotanitott_modell)-lel, hogy néz ki a teljes hálózat szerkezete.
2. Gondolkodj el: ha egy szervizben fotóról akarnád felismerni a hibás alkatrészt (ez az ötlet a 18. lecke gyakorlat 2-ben már felmerült), mennyi saját fotóra lenne szükséged, ha transfer learning-et használnál (pár száz), szemben azzal, ha nulláról építenéd fel a modellt (valószínűleg több tízezer)?
3. Új gyakorlat: nézz utána (webes keresés) a "Hugging Face" platformon, keress rá egy magyar nyelven is működő, előtanított szövegosztályozó modellre — írd le 2-3 mondatban, mire használhatnád (pl. vásárlói vélemények automatikus pozitív/negatív osztályozására egy webáruházban).
Források és további olvasnivaló
A lecke témájának hivatalos dokumentációi és alapvető cikkei:
• Hugging Face — előtanított modell finomhangolása — huggingface.co