24. lecke
Modellértékelés komolyan: Precision, Recall, F1, Confusion matrix, ROC-AUC
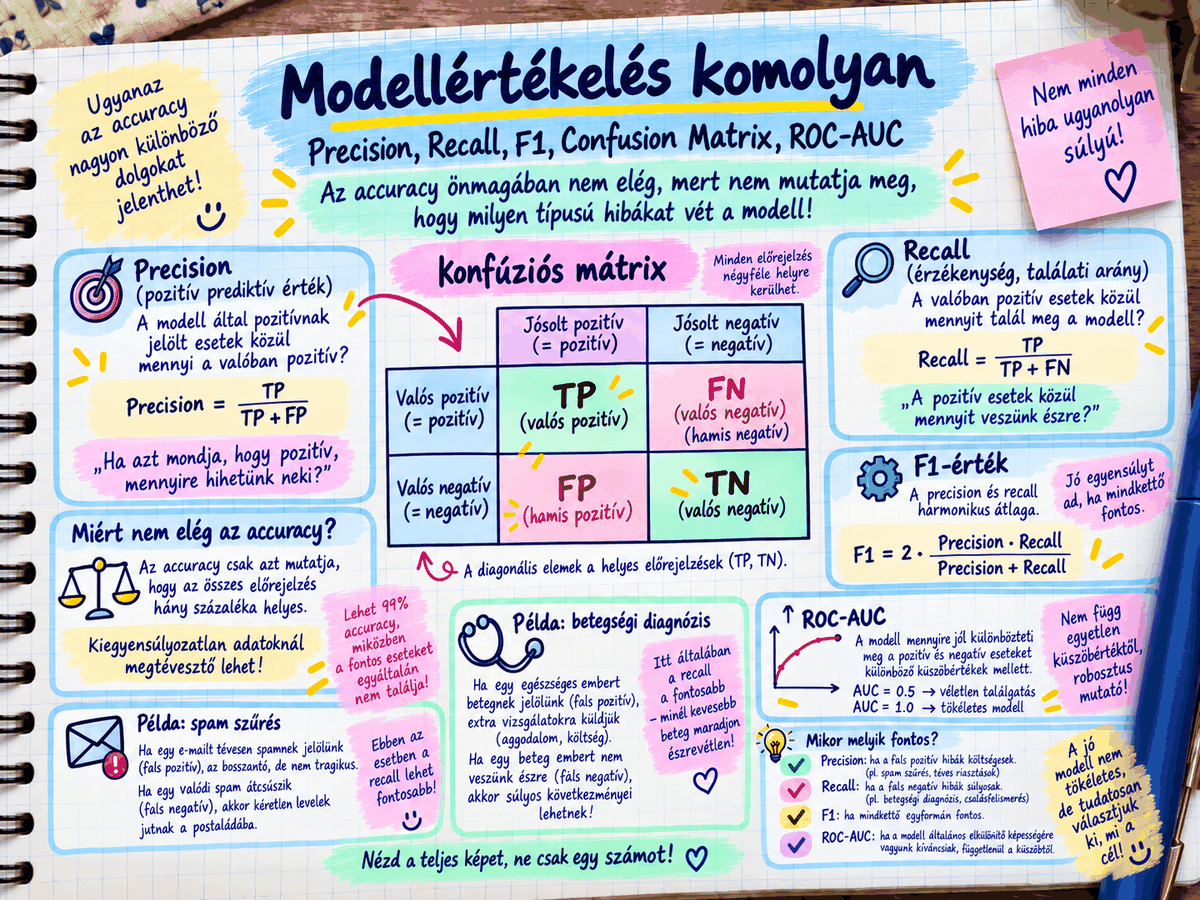
Miért nem elég az egyszerű „pontosság" (accuracy)?
Egy 95%-os pontosságú modell is lehet használhatatlan — ha például a spamek többségét átengedi. Ez a lecke megmutatja, miért kevés önmagában a pontosság (accuracy), és bevezeti a valódi értékelési eszközöket: a konfúziós mátrixot, a precisiont, a recallt, az F1-pontszámot, valamint a ROC-görbét és az AUC-t. A 21. lecke spamszűrőjén mindet ki is próbálod.
- A konfúziós mátrix (confusion matrix): a minden más mérőszám alapja
- Precision (pontosság-specifikusan): "ha a modell spam-et mond, mennyire hihetek…
- Recall (felidézés): "az összes valódi spam közül hányat talált meg a modell?"
- F1-score: egyetlen szám, ami mindkettőt figyelembe veszi
- Gyakorlati példa: a 21. lecke spam-szűrőjének részletes kiértékelése
- ROC-görbe és AUC: a "döntési küszöb" hatásának vizsgálata
- Olvasási idő: kb. 5 perc (a kódok kipróbálásával több)
- 7 rész · 17 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
A 21. leckében a spam-szűrő modellünket egyetlen számmal értékeltük: "pontosság" (hány % esetben találta el a helyes választ). Ez a lecke megmutatja, miért veszélyes ez önmagában, és bevezeti azokat a mélyebb eszközöket, amiket a valós AI-fejlesztők használnak.
Nézzük meg ezt a következő, sokkoló példával: képzeld el, hogy 1000 email közül csak 10 a tényleges spam (990 nem spam). Egy "lusta" modell, ami mindig azt mondja "nem spam" (soha nem ellenőriz semmit!), 990/1000 = 99% pontosságot érne el — mégis teljesen hasznavehetetlen, mert egyetlen spam-et sem szűrt ki. Ez a lecke pontosan ezt a rejtett csapdát leplezi le.
import torch
import torch.nn as nn
import numpy as np
Rész 1 — A konfúziós mátrix (confusion matrix): a minden más mérőszám alapja
Egy osztályozási feladatnál (21. lecke) a modell döntésének négyféle kimenetele lehet (2 osztályra egyszerűsítve — "spam" vs. "nem spam"):
- Igaz pozitív (True Positive, tp): a modell "spam"-et mondott, és valóban spam volt. -> eltalálta.
- Igaz negatív (True Negative, tn): a modell "nem spam"-et mondott, és valóban nem spam volt. -> eltalálta.
- Hamis pozitív (False Positive, fp): a modell "spam"-et mondott, de valójában nem volt az. -> tévedett ("félreverte a harangot").
- Hamis negatív (False Negative, fn): a modell "nem spam"-et mondott, de valójában spam volt. -> tévedett ("átengedte a betolakodót").
Ezt a négy számot egy táblázatba (mátrixba) rendezve kapjuk a konfúziós mátrixot:
| Modell: „nem spam" | Modell: „spam" | |
|---|---|---|
| Valós: nem spam | TN | FP |
| Valós: spam | FN | TP |
Miért nem elég az egyetlen 'pontosság' szám, ha már van ez a négy részletesebb szám? Mert a hamis pozitív és a hamis negatív hiba gyakran nagyon különböző súlyú, valós következménnyel jár! Egy spam-szűrőnél: ha a modell egy fontos ügyfél-emailt tévesen "spam"-nek minősít (hamis pozitív), az ügyfél elveszítheti az üzenetet — ez akár üzleti kárt is okozhat. Ha viszont egy valós spam átcsúszik (hamis negatív), az "csak" kellemetlen, de kevésbé súlyos. Egy orvosi diagnosztikai AI-nál (emlékeztető a 14b lecke döntési fa példájára) ez pont fordítva lehet: egy hamis negatív (a rendszer "egészségesnek" mondja a beteg pácienst) sokkal veszélyesebb lehet, mint egy hamis pozitív (felesleges további vizsgálat). Egy egyetlen "pontosság" szám ezt a különbséget elrejti.
Rész 2 — Precision (pontosság-specifikusan): "ha a modell spam-et mond, mennyire hihetek neki?"
Képlet:
Precision = tp / (tp + fp)
Magyarul mit jelent ez a tört? A nevező (tp + fp) az összes olyan eset, amikor a modell "spam"-et mondott (függetlenül attól, hogy igaza volt-e). a számláló (tp) csak azok az esetek, amikor tényleg igaza is volt. Tehát a precision azt méri: "a modell 'spam' riasztásai közül hány % volt valóban találat?" — ha a precision alacsony, a modell "túlérzékeny", sok valódi, jó emailt is spam-nek bélyegez (sok hamis pozitív).
Rész 3 — Recall (felidézés): "az összes valódi spam közül hányat talált meg a modell?"
Képlet:
Recall = tp / (tp + fn)
A nevező itt más: (tp + fn) az összes tényleges, valós spam (függetlenül attól, hogy a modell felismerte-e). a recall azt méri: "az összes igazi spam közül hány %-ot kapott el a modell?" — ha a recall alacsony, a modell "túl engedékeny", sok valódi spam átcsúszik rajta észrevétlenül (sok hamis negatív).
Ez a kettő (precision és recall) gyakran egymás "ellen" hat — ha a modellt "óvatosabbá" teszed (mindent spam-nek jelöl, hogy biztosan ne csúsztasson át semmit), a recall nő, de a precision romlik (mert sok jó emailt is spam-nek jelöl). Ez a "precision-recall kompromisszum" a gépi tanulás egyik alapvető, gyakorlati döntési kérdése.
Rész 4 — F1-score: egyetlen szám, ami mindkettőt figyelembe veszi
Képlet (a precision és recall "harmonikus átlaga"):
F1 = 2 * (Precision * Recall) / (Precision + Recall)
Miért nem egy egyszerű átlag ((Precision + Recall) / 2), miért 'harmonikus' átlag? A harmonikus átlag speciális tulajdonsága: erősen "bünteti", ha az egyik érték nagyon alacsony, még akkor is, ha a másik nagyon magas. Példa: ha Precision=1.0 (100%) és Recall=0.01 (1%), az egyszerű átlag (1.0+0.01)/2 = 0.505 (50.5%) lenne — ez Félrevezetően jónak tűnik. A harmonikus átlag (F1) ezzel szemben kb. 0.02 (2%) lenne — sokkal pontosabban tükrözi, hogy a modell valójában nagyon rossz (hiszen a valós spamek 99%-át nem veszi észre!). az F1-score ezért egy megbízhatóbb, "őszintébb" összefoglaló szám, mint a sima átlag vagy a pontosság (accuracy).
Rész 5 — Gyakorlati példa: a 21. lecke spam-szűrőjének részletes kiértékelése
Újra felépítjük a 21. lecke modelljét, de most tudatosan egy "kiegyensúlyozatlan" (imbalanced) adathalmazzal dolgozunk — több "nem spam" példával, mint "spam"-mel — ez sokkal jobban hasonlít a valóságra (a legtöbb email nem spam), és jól bemutatja, miért fontos a részletes értékelés.
torch.manual_seed(42)
adatok_x = torch.tensor([
    [0, 0, 0], [1, 0, 0], [0, 1, 0], [0, 0, 0], [1, 1, 0],
    [0, 0, 0], [2, 1, 0], [0, 0, 0], [0, 0, 0], [1, 0, 0],
    [7, 6, 1], [8, 7, 1], [6, 5, 1], [9, 8, 1], [5, 4, 1],
    [0, 0, 0], [0, 1, 0], [1, 0, 0], [0, 0, 0], [2, 0, 0],
], dtype=torch.float32)adatok_y = torch.tensor([
0, 0, 0, 0, 0, 0, 0, 0, 0, 0, # 10 "nem spam"
1, 1, 1, 1, 1, # 5 "spam"
0, 0, 0, 0, 0, # további 5 "nem spam"
], dtype=torch.long)print(f"Adathalmaz összetétele: {(adatok_y == 0).sum().item()} nem spam, "
f"{(adatok_y == 1).sum().item()} spam")
print("(EZ egy TIPIKUS 'KIEGYENSÚLYOZATLAN' adathalmaz — a valóságban")
print(" a legtöbb email valóban nem spam.)\n")class SpamModell(nn.Module):
def __init__(self):
super().__init__()
self.reteg1 = nn.Linear(3, 8)
self.aktivacio = nn.ReLU()
self.reteg2 = nn.Linear(8, 2) def forward(self, x):
x = self.reteg1(x)
x = self.aktivacio(x)
x = self.reteg2(x)
return xmodel = SpamModell() hibafuggveny = nn.CrossEntropyLoss() optimalizalo = torch.optim.SGD(model.parameters(), lr=0.01)
for korszak in range(300):
    joslat = model(adatok_x)
    hiba = hibafuggveny(joslat, adatok_y)
    optimalizalo.zero_grad()
    hiba.backward()
optimalizalo.step()with torch.no_grad():
logitek = model(adatok_x)
joslatok = torch.argmax(logitek, dim=1)def konfuzios_matrix_szamitasa(valos, jelzett):
"""
Kézzel kiszámolja a konfúziós mátrix négy elemét — hogy
LÁSD, PONTOSAN HOGYAN épül fel, mielőtt egy KÉSZ
KÖNYVTÁRI FÜGGVÉNYT használnál rá.
"""
tp = ((jelzett == 1) & (valos == 1)).sum().item()
tn = ((jelzett == 0) & (valos == 0)).sum().item()
fp = ((jelzett == 1) & (valos == 0)).sum().item()
fn = ((jelzett == 0) & (valos == 1)).sum().item()
return tp, tn, fp, fntp, tn, fp, fn = konfuzios_matrix_szamitasa(adatok_y, joslatok)
print("KONFÚZIÓS MÁTRIX:")
print(f"  Igaz Pozitív (TP):  {tp}   (helyesen jelzett spam)")
print(f"  Igaz Negatív (TN):  {tn}   (helyesen jelzett nem-spam)")
print(f"  Hamis Pozitív (FP): {fp}   (tévesen spam-nek jelzett)")
print(f" Hamis Negatív (FN): {fn} (tévesen átengedett spam)\n")pontossag = (tp + tn) / (tp + tn + fp + fn) precision = tp / (tp + fp) if (tp + fp) > 0 else 0 recall = tp / (tp + fn) if (tp + fn) > 0 else 0 f1 = 2 * (precision * recall) / (precision + recall) if (precision + recall) > 0 else 0
print("MÉRŐSZÁMOK:")
print(f"  Pontosság (Accuracy):  {pontossag*100:.1f}%")
print(f"  Precision:             {precision*100:.1f}%")
print(f"  Recall:                {recall*100:.1f}%")
print(f" F1-score: {f1*100:.1f}%\n")Ha a Precision és a Recall között nagy a különbség, az azt jelzi, hogy a modell valamelyik irányba eltolódik. Ha például a Recall alacsony, a modell óvatos: kevés e-mailt jelöl spamnek, de amit megjelöl, abban nagyobb valószínűséggel igaza van.
Rész 6 — ROC-görbe és AUC: a "döntési küszöb" hatásának vizsgálata
Emlékeztető a 21. leckéből: a modell végső döntése (argmax) egy rejtett feltételezésre épül: "ha a spam valószínűség > 50%, akkor spam." de ez az 50%-os határ ("küszöb", threshold) nem szent szám — megváltoztatható!
Ha a küszöböt lejjebb viszed (pl. 30%), a modell "érzékenyebb" lesz (több emailt jelöl spam-nek -> a recall nő, de a precision valószínűleg csökken). Ha feljebb viszed (pl. 70%), a modell "óvatosabb" lesz (fordított hatás).
a ROC-görbe (Receiver Operating Characteristic) pontosan ezt ábrázolja: hogyan változik a modell viselkedése (két másik mérőszám, a "true positive rate" és a "false positive rate" segítségével), ha végigpróbálod az összes lehetséges küszöböt 0%-tól 100%-ig.
az AUC (Area Under the Curve — "a görbe alatti terület") egy egyetlen számmá sűríti ezt a görbét: 1.0 = Tökéletes modell (minden küszöbnél tökéletesen megkülönbözteti a két osztályt), 0.5 = a modell nem jobb, mint a véletlen találgatás (pl. egy érmefeldobás).
with torch.no_grad():
valoszinusegek = torch.softmax(model(adatok_x), dim=1)[:, 1] # a "spam" osztály valószínűségeprint("PÉLDA: KÜLÖNBÖZŐ KÜSZÖBÖK HATÁSA (ROC-GÖRBE ALAPJA):")
for kuszob in [0.3, 0.5, 0.7]:
joslat_ezen_kuszobbel = (valoszinusegek >= kuszob).long()
tp_k, tn_k, fp_k, fn_k = konfuzios_matrix_szamitasa(adatok_y, joslat_ezen_kuszobbel)
recall_k = tp_k / (tp_k + fn_k) if (tp_k + fn_k) > 0 else 0
precision_k = tp_k / (tp_k + fp_k) if (tp_k + fp_k) > 0 else 0
print(f" Küszöb={kuszob}: Precision={precision_k*100:.0f}%, Recall={recall_k*100:.0f}%")Figyeld meg, hogyan változik a Precision és Recall aránya a küszöb módosításával. Ezt a küszöböt a konkrét felhasználási célhoz kell igazítani. Egy érzékeny szűrésnél például alacsonyabb küszöb több gyanús esetet foghat meg, ugyanakkor több hamis riasztást is eredményezhet.
Összefoglaló táblázat — mikor melyik mérőszám számít?
| Mérőszám | Mit mér? | Mikor figyelj rá különösen? |
|---|---|---|
| Accuracy | Összes helyes döntés aránya | Csak kiegyensúlyozott adatnál megbízható (a 20. lecke elve is!) |
| Precision | „Ha a modell pozitívot mond, mennyire hihetek neki?" | Amikor egy hamis pozitív drága (pl. jó ügyfél-e-mail spamnek jelölése) |
| Recall | „Az összes valós pozitívból mennyit talált meg?" | Amikor egy hamis negatív veszélyes (pl. orvosi szűrésnél kihagyott eset) |
| F1-score | A precision és a recall kiegyensúlyozott összefoglalása | Amikor mindkettő számít, és egy számra van szükséged az összehasonlításhoz |
| ROC-AUC | A modell megkülönböztető képessége, a konkrét küszöbtől függetlenül | Amikor a döntési küszöböt is hangolni akarod |
1. Futtasd le a kódot — nézd meg a kiírt Precision/Recall értékeket. Ha az egyik sokkal alacsonyabb, mint a másik, mit jelent ez a modelled viselkedéséről (túl óvatos vagy túl érzékeny)?
2. Módosítsd a rész 6 kódját: próbálj ki még több küszöböt (0.1, 0.2, ..., 0.9) — Írd fel egy táblázatba az eredményeket, és gondold végig: melyik küszöböt választanád, ha egy valódi spam-szűrőt építenél egy kisvállalkozás számára (hol van a te személyes határod Precision és Recall között)?
3. Új gyakorlat: telepítsd a scikit-learn könyvtárat (pip install scikit-learn, ha még nincs), és használd a sklearn.metrics.classification_report() kész függvényét (from sklearn.metrics import classification_report) a fenti adatok_y és joslatok tenzorokon (előbb alakítsd őket .NumPy()-vá) — hasonlítsd össze a kész függvény kimenetét a kézzel számolt eredményeiddel — egyeznek-e?
Források és további olvasnivaló
A lecke témájának hivatalos dokumentációi és alapvető cikkei:
• scikit-learn — modellek értékelése — scikit-learn.org