25. lecke
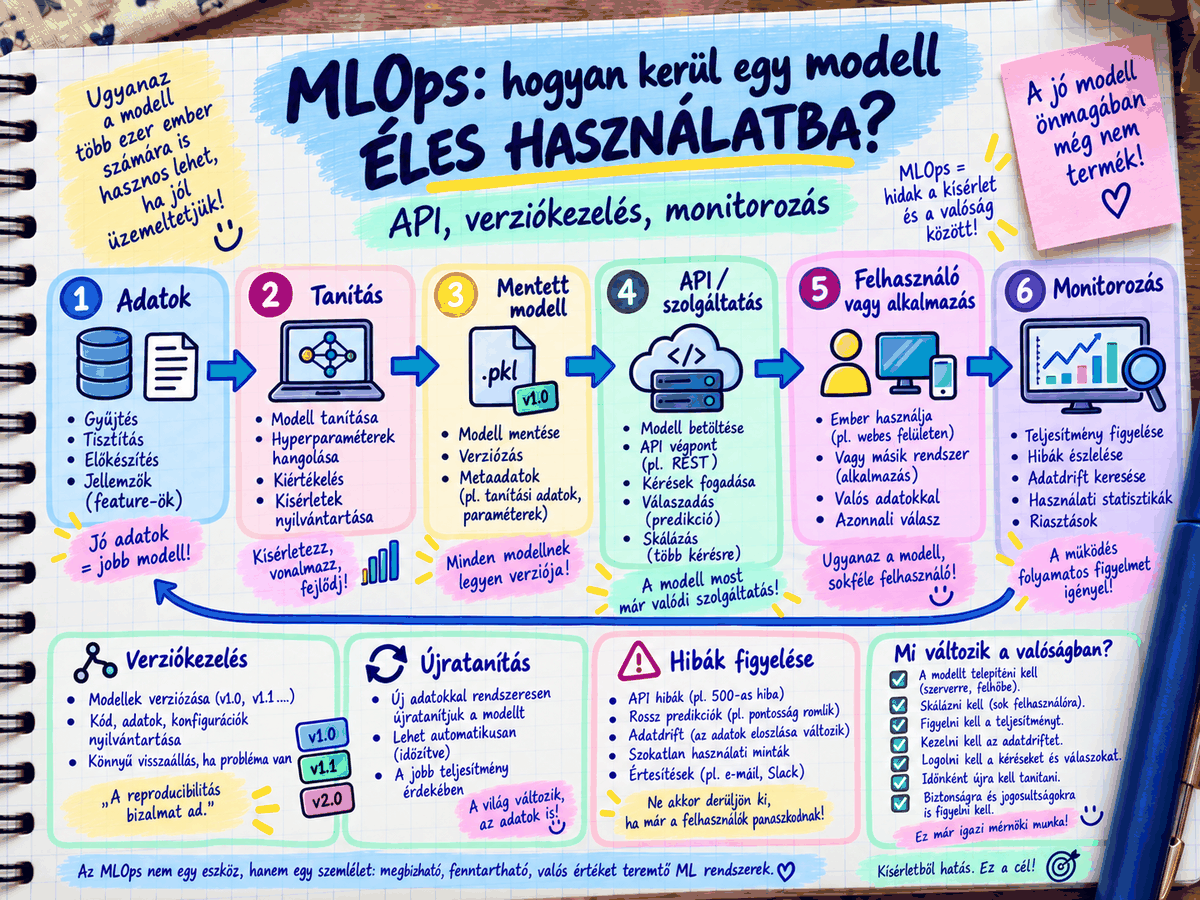
MLOps: hogyan kerül egy modell éles használatba?
A modell kész — most mi történik? (API, verziókezelés, monitorozás)
Egy modell akkor ér igazán valamit, ha mások is használhatják, és megbízhatóan működik. Ez a lecke az MLOps alapjait mutatja be: hogyan tehető elérhetővé egy modell API-n keresztül, hogyan kezeld a verzióit, amikor javítod, és hogyan figyeld (monitorozd), hogy élesben is jól működik-e. A végén egy modell teljes „életútját" is áttekintjük.
- A probléma: mi a különbség "működik a gépemen" és "élesben fut" között?
- A megoldás: az API (application programming interface)
- Verziókezelés: mi történik, ha a modellt javítod?
- Monitorozás: honnan tudod, hogy a modelled még jól működik, hetekkel/hónapokkal…
- Olvasási idő: kb. 5 perc (a kódok kipróbálásával több)
- 5 rész · 6 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Eddig minden modellünk a saját gépeden, egy Python fájlban élt, futtatva, kiírta az eredményt, majd leállt. Ez a lecke azt mutatja meg, hogyan lesz ebből egy olyan rendszer, amit mások (pl. egy weboldal) is használni tudnak — ez a terület neve: MLOps (Machine Learning Operations — "gépi tanulás üzemeltetés").
Miért nem kell megijedni ettől a témától? Mert az MLOps ugyanazokra az elvekre épül, mint bármely online szolgáltatás üzemeltetése: van egy szerver, ami fogadja a kéréseket (mint egy weboldal mögött), van verziókezelés (mint a GitHub, amit a fejlesztői környezet tudástárban megismertél), és van monitorozás (hogy tudd, működik-e még a szolgáltatás). Ez a lecke ezeket a fogalmakat alkalmazza az AI-modellekre.
Rész 1 — A probléma: mi a különbség "működik a gépemen" és "élesben fut" között?
Emlékeztető a 15. leckéből: a lecke_15_elso_sajat_projekt.py fájlt te futtattad, a saját gépeden, és a print() sorok kiírták az eredményt a konzolba.
Ez tökéletes a tanuláshoz — de mi van, ha egy weboldalon szeretnéd használni ezt a modellt (pl. "az oldal látogatója megadja a látogatói számot, és a weboldal azonnal mutatja a becsült vásárlásszámot")? A látogatónak nincs Python-ja a számítógépén, nem tudja lefuttatni a .py fájlt.
Pontosan — és a megoldás is hasonló elven működik: a modellt egy szerveren futtatjuk, ami "kiszolgálja" a kéréseket — csak itt nem egy weboldalt ad vissza, hanem egy AI-jóslatot.
Rész 2 — A megoldás: az API (application programming interface)
A modellt egy API mögé "csomagoljuk" — ez egy program, ami folyamatosan fut egy szerveren, figyeli a beérkező kéréseket (pl. "mennyi a vásárlásszám becslés 350 látogatónál?"), a már betanított modellel kiszámolja a választ, és visszaküldi — általában JSON formátumban (ez ugyanaz a formátum, amit a legtöbb webes API is használ).
A Python egyik legnépszerűbb eszköze erre a FastAPI könyvtár — nézzük meg, hogyan nézne ki a 15. lecke modellje egy API mögé csomagolva (illusztratív kód, ami a pip install fastapi uvicorn telepítés után ténylegesen futtatható):
fajl neve: api_szerver.py
from fastapi import FastAPI
import torch
import torch.nn as nn
1. Lépés: a modell osztályának definiálása (ugyanaz, mint a 15. leckében)
class LatogatottsagModell(nn.Module):
    def __init__(self):
        super().__init__()
        self.reteg1 = nn.Linear(1, 16)
        self.aktivacio = nn.ReLU()
self.reteg2 = nn.Linear(16, 1) def forward(self, x):
x = self.reteg1(x)
x = self.aktivacio(x)
x = self.reteg2(x)
return x2. Lépés: a már betanított modell betöltése (emlékeztető: a tanítást nem minden egyes kérésnél végezzük el újra! A modellt egyszer betanítjuk, elmentjük fájlba [torch.save(model.state_dict(), "modell.pth")], és az API indulásakor csak betöltjük a már kész súlyokat [model.load_state_dict(torch.load("modell.pth"))] — ez sokkal gyorsabb, mint újratanítani minden kérésnél.)
model = LatogatottsagModell()
model.load_state_dict(torch.load("modell.pth"))
model.eval()  # "kiértékelő" módba kapcsolja a modellt (emlékeztető
a 15. lecke torch.no_grad() széljegyzetére — itt egy rokon, de kicsit más beállításról van szó, ami pl. a dropout [20. lecke] rétegeket kapcsolja ki éles használatra)
3. Lépés: az API létrehozása
app = FastAPI()
4. Lépés: egy "végpont" (endpoint) definiálása — ez az a "cím", amit a weboldalad meg fog hívni
@app.get("/joslas/{latogatoszam}")
def joslas(latogatoszam: float):
    bemenet = torch.tensor([[latogatoszam]])
    with torch.no_grad():
        eredmeny = model(bemenet).item()
    return {"latogatok": latogatoszam, "becsult_vasarlasok": eredmeny}
Indítás: a terminálban: uvicorn api_szerver:app --reload ezután a "http://localhost:8000/joslas/350" cím meghívásával (ahogy bármely más webes API-t hívnád!) a szerver visszaadja a JSON választ: {"latogatok": 350, "becsult_vasarlasok": 11.8}
Igen — ez szándékosan párhuzamos fogalom: mindkettő egy "címet" (URL-t) definiál, ami fogad egy bemenetet, és visszaad egy strukturált választ (JSON) — a különbség csak annyi, hogy itt a választ nem egy adatbázis-lekérdezés, hanem egy AI-modell előrejelzése adja.
Rész 3 — Verziókezelés: mi történik, ha a modellt javítod?
Igen, de egy fontos többlettel: egy modellnél nem csak a Python kódot (a modell osztály definícióját) kell verziókövetni, hanem a betanított súlyokat is (a "modell.pth" fájlt), és azt is, hogy pontosan milyen adaton, milyen beállításokkal (lr, korszakok száma, stb.) tanítottuk.
Ez három külön "dolog" verziókövetését jelenti:
1. Kód verziókövetése: ez a szokásos git/GitHub munkamenet (Fejlesztői környezet, 8-9. rész).
2. Adat verziókövetése: ha a tanító adatod idővel bővül/ változik (pl. új hónap látogatottsági adatai), fontos tudni, "melyik modellt melyik adatverzióval tanítottuk" — erre léteznek speciális eszközök (pl. DVC — Data Version Control), de kisebb projekteknél egyszerűen dátumozott mentésekkel/mappákkal is megoldható.
3. Modell verziókövetése: minden egyes betanított modellhez (a .pth fájlhoz) érdemes feljegyezni: mikor tanítottuk, milyen hibával (24. lecke mérőszámaival!) teljesített, milyen adaton — hogy ha egy új verzió rosszabbul teljesít, vissza tudj térni az előzőhöz (pontosan, mint amikor egy git commit-ot visszavonsz).
Miért nem elég 'csak' a legújabb modellt használni mindig? Mert (a 20. leckéből tudod) egy új tanítás nem mindig javít — ha rosszul választott beállításokkal (pl. túl nagy lr, vagy túltanult modell) tanítasz újra, a modell akár rosszabb is lehet, mint a korábbi verzió — ezért soha nem "felülírjuk vakon" a régi, működő modellt, hanem először teszteljük az újat (lásd rész 4), és csak akkor állítjuk élesbe, ha tényleg jobb.
Rész 4 — Monitorozás: honnan tudod, hogy a modelled még jól működik, hetekkel/hónapokkal a bevezetés után?
Egy modell, ami ma jól működik, nem feltétlenül fog jól működni örökké — ezt a jelenséget "modell-eldriftelésnek" (model drift) hívják.
Hogyan 'romolhat el' egy modell, ha a kódja nem változik? Mert a világ, amiről az adat szól, változik — emlékeztető a 12b lecke extrapolációs problémájára: ha a weboldalad látogatottsági szokásai idővel megváltoznak (pl. egy új marketing kampány, vagy egy gazdasági változás miatt másként vásárolnak az emberek), a régi adaton tanított modell egyre kevésbé lesz pontos — nem mert "elromlott" a kódja, hanem mert a valóság, amit modellez, más lett.
Ezért a gyakorlatban folyamatosan monitorozni kell:
1. Működik-e az API egyáltalán? (ez ugyanaz a "szerver fent van-e" figyelés, amit weboldalaknál is használnak — "uptime monitoring".)
2. Mennyi idő alatt válaszol? (ha egy jóslat lekérése hirtelen sokkal lassabb lesz, az problémára utalhat.)
3. Változik-e a beérkező adat jellege? (pl. ha hirtelen sokkal több, extrém értékű kérés érkezik — emlékeztető a 12b lecke "tartomány-ellenőrzésére" — ez jelezheti, hogy a modell egyre többször van extrapolációs helyzetben.)
4. Rendszeres időközönként újratesztelni a modellt új, friss adaton (a 24. lecke mérőszámaival) — ha a teljesítmény (pl. az F1-score) folyamatosan romlik, eljött az ideje az újratanításnak, frissebb adatokkal.
Összefoglaló: egy modell "életútja" — a teljes kör
| Szakasz | Mit csinálunk? | Kapcsolódó lecke |
|---|---|---|
| Adatgyűjtés, előkészítés | Adat gyűjtése, tisztítása, skálázása | 8, 11, 15, 22. lecke |
| Modellfejlesztés | Modell építése, tanítása | 12-14, 21. lecke |
| Kiértékelés | Precision/Recall/F1, train-test split | 20, 24. lecke |
| Csomagolás | API mögé csomagolás (FastAPI) | 25. lecke (rész 2) |
| Bevezetés (deployment) | Szerverre telepítés, elérhetővé tétel | 25. lecke (rész 2) |
| Monitorozás | Folyamatos ellenőrzés, teljesítménymérés | 25. lecke (rész 4) |
| Újratanítás | Frissebb adaton, ha a teljesítmény romlik | vissza a 2. lépéshez! |
Mikor van kész egy AI-modell? A lecke záró gondolata: figyeld meg, hogy az utolsó lépés (7) visszavezet a második lépéshez (2) — ez nem véletlen: a valós AI-rendszerek életciklusa kör alakú, nem egyenes vonalú. A modellfejlesztés soha nem ér véget egyetlen, tökéletes modell megépítésével — ez egy folyamatos, ismétlődő folyamat, ahogy bármilyen szoftvert is folyamatosan karban kell tartani, nem pedig "egyszer megcsinálod és kész".
1. Telepítsd a fastapi és uvicorn könyvtárakat (pip install fastapi uvicorn), és próbáld ki a rész 2 példakódját (előbb a 15. lecke modelljét kell elmentened torch.save()-del) — nyisd meg a böngésződben a "http://localhost:8000/docs" címet, miután elindítottad a szervert — a FastAPI automatikusan generál egy interaktív dokumentációs oldalt, ahol kipróbálhatod az API-dat.
2. Gondolkodj el: egy weboldalba hogyan illesztenél be egy ilyen API-t — pl. egy JavaScript fetch() hívással a weboldal frontend részéből a Python API felé? Milyen biztonsági kérdéseket (pl. ki férhet hozzá az API-hoz) kellene átgondolnod?
3. Új gyakorlat: írj egy rövid "monitorozási tervet" (3-4 mondatban) a 15. lecke weboldal-látogatottság modelljéhez — milyen jeleket figyelnél, hogy időben észrevedd, ha a modell "eldriftel" (rész 4), és milyen gyakran újratanítanád?
Források és további olvasnivaló
A lecke témájának hivatalos dokumentációi és alapvető cikkei:
• FastAPI — hivatalos dokumentáció — fastapi.tiangolo.com