26. lecke
Prompt engineering, tudományosan megalapozva
Miért működnek bizonyos promptolási technikák — a 17. lecke Transformer/attention mechanizmusa alapján, nem "trükkökként", hanem a modell működéséből levezetve
A jó prompt nem varázsszavak gyűjteménye: a hatása abból következik, ahogyan a nyelvi modell működik. Ez a lecke a 17. lecke Transformer-tudására építve magyarázza el a legfontosabb technikákat — a példák mutatását (few-shot), a gondolatlánc-promptolást (chain-of-thought), a system promptot és a strukturált formátumot —, azt, hogy egyes „népszerű trükkök" miért működnek kevésbé, és hogyan épül fel egy jó prompt.
- Az alapelv: a prompt nem "parancs", hanem a szövegkörnyezet, amiből a modell…
- Technika: few-shot prompting (példák mutatása)
- Technika: chain-of-thought (gondolatlánc promptolás)
- Technika: A system prompt (szerepmeghatározás)
- Technika: strukturált formátum (XML-tagek, különálló szakaszok)
- Miért kevésbé működnek bizonyos "népszerű trükkök"?
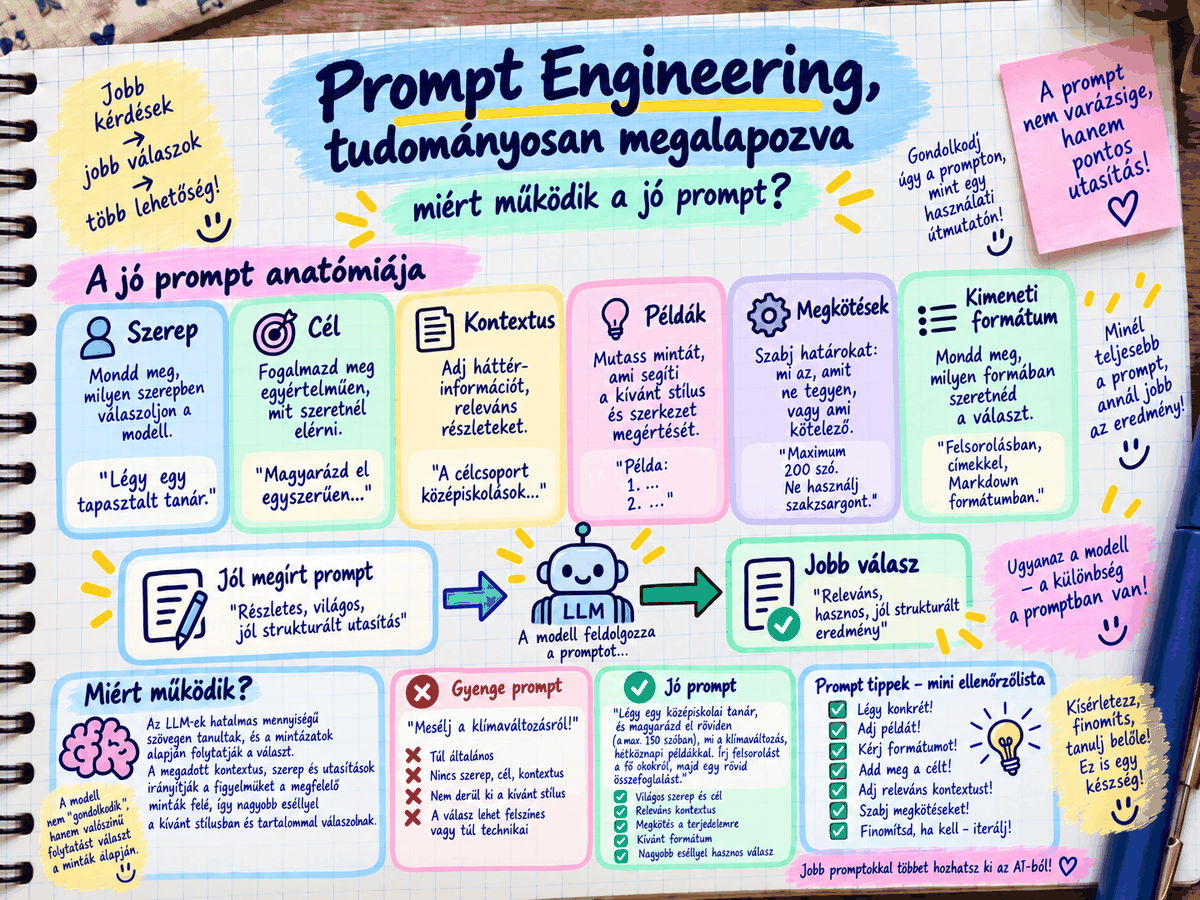
- Gyakorlati összefoglaló: egy jól felépített prompt "anatómiája"
- Olvasási idő: kb. 5 perc (a kódok kipróbálásával több)
- 8 rész · 6 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Ez a lecke minden, eddig tanult nyelvi-modell-tudásodat (17, 19. lecke) felhasználja, hogy megértsd: a jó promptírás nem "varázsszavak" gyűjteménye, hanem a modell belső működésének tudatos kihasználása.
Mert ha csak "bemagolod" a technikákat (emlékeztető a 20. lecke "túltanulás" hasonlatára — a diák, aki a válaszokat bemagolja, nem az elvet érti), nem tudsz új, egyedi helyzetekre alkalmazkodni — de ha érted, miért működik egy technika (a modell mechanizmusa szempontjából), képes leszel saját, új megoldásokat kitalálni olyan helyzetekre is, amikre senki nem írt még "útmutatót."
Rész 1 — Az alapelv: a prompt nem "parancs", hanem a szövegkörnyezet, amiből a modell "folytat"
Emlékeztető a 17. lecke lépés 4-ből (előtanítás): a nyelvi modell alapvető feladata "az eddigi szöveg alapján, találd ki a következő tokent." amikor te egy promptot írsz, te valójában nem "utasítod" a modellt (úgy, ahogy egy függvényt hívsz meg pontos paraméterekkel — 7. lecke) — hanem létrehozol egy szövegkörnyezetet, amiből a modell statisztikailag "legvalószínűbbnek" ítélt folytatást generálja.
Ez azt jelenti, hogy a prompt megfogalmazása tényleg számít, nem 'csak' a tartalma? Pontosan ez a lecke központi állítása: mivel a modell a szövegkörnyezet alapján "folytat", a prompt minden egyes szava, sorrendje, struktúrája befolyásolja, milyen "típusú" szöveg folytatását várja a modell — ez olyan, mint amikor a 4. leckében tanultad, hogy az elif sorrend változtatása megváltoztatja a program viselkedését, anélkül, hogy a "logika" maga megváltozna — itt hasonlóan, a prompt szerkezete maga hordoz információt a modell számára.
Rész 2 — Technika: few-shot prompting (példák mutatása)
Mi ez: a kérdésed elé néhány példát (kérdés-válasz párt) írsz, mielőtt feltennéd a tényleges kérdésed.
Példa: "Fordítsd le angolra: Magyar: Szia -> Angol: Hello magyar: Köszönöm -> Angol: Thank you magyar: Viszlát -> Angol: ???"
Tudományos magyarázat (a 17. lecke alapján): emlékeztető a GPT-3-ra (19. lecke, 2020) — a "few-shot learning" képessége pont onnan ered, hogy a modell az előtanítás során (17. lecke, lépés 4) milliószámra látott olyan szövegrészletet, ahol minták/példák után egy új, hasonló elem következett (listák, táblázatok, gyakorlófeladatok a tanító adatban). Amikor te ilyen formátumot adsz a promptban, a modell felismeri ezt a "mintát követő folytatás" helyzetet, és az attention mechanizmus (17. lecke, lépés 3) expliciten "odafigyel" a korábbi példákra, miközben a választ generálja — tehát a példák nem csak "inspirálják", hanem matematikailag, közvetlenül befolyásolják a következő token valószínűségi eloszlását.
Rész 3 — Technika: chain-of-thought (gondolatlánc promptolás)
Mi ez: arra kéred a modellt, hogy "gondolkodjon lépésről lépésre", mielőtt a végső választ adná (pl. "Gondold végig lépésről lépésre, majd add meg a végső választ").
Tudományos magyarázat: emlékeztető a 17. lecke lépés 3-ra (Transformer rétegek): a modell minden egyes új token generálásakor "visszanéz" az eddig generált szövegre (beleértve a saját, korábban generált válaszát is!) — ez azt jelenti, hogy ha a modell először "kiírja" a gondolatmenetét (pl. "1. lépés: ... 2. lépés: ..."), ezek a közbülső lépések a saját szövegkörnyezetének részévé válnak, és a következő tokenek (beleértve a végső választ) erre a kiírt gondolatmenetre épülnek — ezért pontosabb az eredmény, mint ha a modell "egyetlen lépésben", közbülső szövegkörnyezet nélkül próbálná kitalálni a választ.
Ez azt jelenti, hogy a modell tényleg 'gondolkodik', ha így kérem? Emlékeztető a 12b lecke "nagyon jó papagáj" hasonlatára: a modell nem "gondolkodik" emberi értelemben — de a kiírt közbülső lépések ténylegesen, matematikailag többlet- információt adnak a következő tokenek számításához (az attention mechanizmus ezekre is "odafigyel"), ezért a végső válasz gyakorlatban pontosabb lesz — ez egy mérhető, megfigyelhető hatás, függetlenül attól, hogy ezt "gondolkodásnak" nevezzük-e vagy sem.
Rész 4 — Technika: A system prompt (szerepmeghatározás)
Mi ez: a beszélgetés elején (vagy egy külön, "system" címkével jelölt részben) meghatározod, "ki" legyen a modell (pl. "Te egy tapasztalt Python-tanár vagy, aki lépésről lépésre magyaráz").
Tudományos magyarázat: emlékeztető a 17. lecke lépés 2-re (embedding): a modell belső "jelentés-terében" a különböző szavak/fogalmak (pl. "tanár", "szakértő", "gyerek") különböző "tartományokat" aktiválnak, amik a tanító adatban (17. lecke lépés 4) statisztikailag együtt szoktak előfordulni egy adott szereppel (pl. egy "tanár" szerepű szövegkörnyezetben a tanító adatban gyakrabban fordulnak elő magyarázó, lépésenkénti, türelmes stílusú mondatok). Amikor megadod ezt a "szerepet", a modell ezt a statisztikai tartományt aktiválja, és a következő tokenek generálása ebből a "tartományból" történik — ezért változik meg a stílus, részletesség, szóhasználat.
Ez ugyanaz az elv, amit a 12b lecke rész 6-ban (keretezés/manipulálhatóság) már érintettünk? Igen — és ez fontos összekapcsolás: a system prompt/szerepmeghatározás hatékonysága ugyanabból a mechanizmusból fakad, mint a keretezés sebezhetősége — a modell a szövegkörnyezet alapján "igazodik." ez egyszerre hasznos eszköz (jobb, célzottabb válaszok) és potenciális kockázat (ha valaki rosszindulatúan használja a szerepmeghatározást) — ezért vannak a 12b leckében már tárgyalt, külső, felülírhatatlan biztonsági rétegek.
Rész 5 — Technika: strukturált formátum (XML-tagek, különálló szakaszok)
Mi ez: a promptot világosan elkülönített részekre tagolod (pl. <kontextus>...</kontextus>, <feladat>...</feladat>, <formátum>...</formátum> címkékkel, vagy egyszerűen címsorokkal/ listákkal).
Tudományos magyarázat: emlékeztető a 17. lecke lépés 3-ra (attention): a modellnek egyszerre kell feldolgoznia a teljes bemenetet, és el kell döntenie, melyik rész mennyire "fontos" a válaszhoz. Ha a promptod "egybefolyó", rendezetlen szöveg (pl. egy kérdés közepén elrejtett fontos részlet), a modellnek nehezebb "megtalálnia" a releváns részeket. A világos tagolás (emlékeztető a 6. lecke dictionary-jére: a kulcs-érték párok is egyfajta "tagolás"!) segíti a modellt ebben — a tanító adatban (17. lecke lépés 4-5) a modell sok olyan dokumentumot látott (kód, dokumentáció, strukturált adat), ahol az ilyen tagolás egyértelmű jelentést hordozott — ezért "megtanulta" ezeket a mintákat megbízhatóan értelmezni.
Érdekes összefüggés — ez a jól tagolt, strukturált formátum nem csak neked, emberi olvasónak segít az áttekintésben, hanem ha egy nyelvi modellnek kellene feldolgoznia/összefoglalnia ezeket a leckéket, a világos tagolás annak is segítene — ez egy jó példa arra, hogy a "jól strukturált szöveg" elve embernek és gépnek egyaránt hasznos.
Rész 6 — Miért kevésbé működnek bizonyos "népszerű trükkök"?
Hallottam olyat, hogy 'ha megfenyegeted a modellt, jobban teljesít' — ez igaz? Ez egy jó példa arra, miért fontos a tudományos megközelítés a "népszerű trükkök" helyett: egyes ilyen állítások egyszeri, nem megbízhatóan megismételt megfigyelésekből származnak, és modellenként, verziónként erősen változhatnak (emlékeztető a 17. lecke lépés 5-re: a finomhangolás során a fejlesztők kifejezetten dolgoznak azon, hogy a modell kevésbé legyen érzékeny ilyen "manipulatív" megfogalmazásokra — emlékeztető a 12b lecke rész 6-ra). Ezért a megbízható promptolási elvek azok, amik a mechanizmusból (few-shot, chain-of-thought, strukturált formátum — rész 2-5) következnek, nem pedig anekdotikus "trükkök", amik bármikor megszűnhetnek működni egy új modell-verziónál.
Rész 7 — Gyakorlati összefoglaló: egy jól felépített prompt "anatómiája"
A fenti elvek alapján, íme egy példa-vázlat egy jól felépített promptra (pl. ha egy szervizben AI-t használnál az ügyfelek hibaleírásainak összefoglalására):
SZEREP (RÉSZ 4): Te egy tapasztalt szerviztechnikus vagy, aki
tömören, szakszerűen összefoglalja az ügyfél hibaleírásait.
KONTEXTUS (RÉSZ 5, STRUKTÚRA): Az alábbiakban egy ügyfél szabad
szöveges hibaleírása következik.
PÉLDA (RÉSZ 2, FEW-SHOT):
  Bemenet: "A telefonom nem tölt, már 3 kábelt is kipróbáltam"
  Kimenet: "Töltési hiba, kábel valószínűleg nem az ok (3 kipróbálva)"
FELADAT (RÉSZ 5): Foglald össze az alábbi hibaleírást MAX 15
szóban, ugyanebben a formátumban:
"Tegnap óta villog a képernyő, amikor felmelegszik a gép, hidegen
viszont rendben működik"
GONDOLKODÁSI LÉPÉSEK (RÉSZ 3, CHAIN-OF-THOUGHT, HA BONYOLULTABB
a feladat): Először azonosítsd a fő tünetet, majd a kiváltó
körülményt, végül fogalmazd meg tömören.
Összefoglaló táblázat
| Technika | Miért működik? (a 17. lecke alapján) |
|---|---|
| Few-shot prompting | A modell az attention mechanizmuson keresztül felismeri a „minta + új elem" formátumot |
| Chain-of-thought | A kiírt közbülső lépések többlet-szövegkörnyezetet adnak a végső válasz generálásához |
| System prompt / szerep | Aktiválja a modell „jelentésterének" egy adott, statisztikailag összefüggő tartományát |
| Strukturált formátum | Segíti az attentiont a releváns részek megtalálásában, a tanult mintázatok alapján |
1. Válassz egy valós, általad használt AI-promptot (pl. amit legutóbb egy AI-asszisztensnek írtál), és azonosítsd benne, melyik rész 2-5 technikát használtad (tudatosan vagy ösztönösen).
2. Kísérletezz: írj egy egyszerű kérdést kétféleképp — egyszer "nyersen" (struktúra nélkül), egyszer a rész 7 vázlata szerint felépítve — hasonlítsd össze a két válasz minőségét.
3. Új gyakorlat: Gondold végig — a 25. lecke MLOps elvei alapján, hogyan "verziókövetnéd" a saját, jól bevált promptjaidat egy valós projektben (pl. a munkahelyeden vagy egy hobbiprojektben), hogy később is visszakereshetők, újrafelhasználhatók legyenek, és nyomon kövesd, melyik verzió működött jobban?
Források és további olvasnivaló
A lecke témájának hivatalos dokumentációi és alapvető cikkei:
• Brown és mtsai.: few-shot tanulás nyelvi modellekkel (2020) — arxiv.org
• Wei és mtsai.: Chain-of-Thought promptolás (2022) — arxiv.org
• Claude — prompt engineering útmutató — docs.claude.com