Kiegészítő lecke
Hogyan "tanul" valójában egy gépi modell?
Mintázatok, extrapoláció, és a megbízhatóság kérdése
Az előző leckében a modell „megtanult" valamit — de mit jelent ez pontosan? Ez a lecke a színfalak mögé néz: mi az a mintázat, hogyan találja meg a gép a legjobb egyenest a hiba lépésenkénti csökkentésével, miért tűnik egy AI „okosnak", miért hallucinál, és hogyan lehet megbízhatósági ellenőrzést beépíteni. Itt a megértésen van a hangsúly, nem a kódon.
- Mi az a "mintázat"? (nincs benne varázslat)
- Hogyan találja meg a gép ezt az egyenest?
- Miért tűnik egy AI mégis "emberinek", "okosnak"?
- A "stop vonal" hiánya: miért hallucinál az AI?
- Megoldás: hogyan építhetünk be egy "megbízhatósági indikátort"?
- A keretezés (framing) problémája: miért nem ellenőrzi az AI a valóságot, csak a…
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 6 rész · 10 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Ez a lecke a 12. lecke (első ML modell) mélyebb megértését adja. Összegyűjti a legfontosabb "miért/hogyan" kérdéseket és a rájuk adott válaszokat, hogy bármikor visszaolvashatók legyenek.
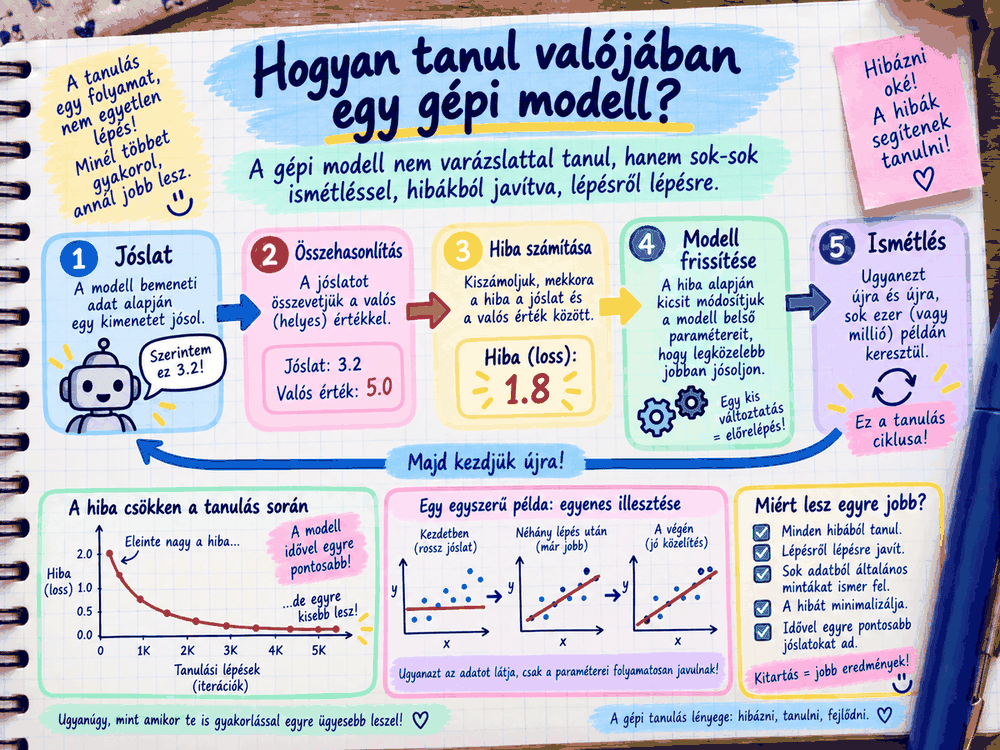
Rész 1 — Mi az a "mintázat"? (nincs benne varázslat)
Nézzük az autós adatunkat:
| km_futott | ár (ezer Ft) |
|---|---|
| 10 000 | 8500 |
| 30 000 | 7200 |
| 60 000 | 5800 |
| 90 000 | 4500 |
| 120 000 | 3200 |
| 150 000 | 2100 |
Ha ránézel, te magad is látod a mintázatot: minél több km, annál alacsonyabb az ár, és ez elég egyenletesen csökken. Ez a "mintázat" — semmi több, mint egy megfigyelhető, ismétlődő összefüggés az adatokban.
A LinearRegression modell dolga: megtalálni egy egyenest, ami erre a mintázatra a legjobban illeszkedik. Az egyenes képlete:
ár = meredekség × km + kezdőpont
A "meredekség" és a "kezdőpont" azok a konkrét számok, amiket a modell magától talál ki a tanítás során.
Rész 2 — Hogyan találja meg a gép ezt az egyenest?
Hasonlat: képzeld el, hogy egy sötét szobában állsz, és meg kell találnod egy tárgyat a padlón — de nem látsz semmit. Az egyetlen segítséged: valaki megmondja, "melegebb" vagy "hidegebb" vagy, amikor lépsz egyet valamerre.
Ez pontosan az, amit a gép csinál — csak nem egy tárgyat, hanem a legjobb egyenest keresi, ugyanezzel a "próbálgatás + visszajelzés" módszerrel.
Konkrét példa, lépésről lépésre (2 autóval, egyszerűsítve):
10 000 km -> 8500 ezer Ft (valós) 150 000 km -> 2100 ezer Ft (valós)
1. Lépés: a gép kitalál egy kezdő egyenest (találomra): ár = -0.01 * km + 9000
2. Lépés: kiszámolja, mit "jósolna" ez, és összeveti a valósággal:
| km | valós ár | egyenes jóslata | eltérés (hiba) |
|---|---|---|---|
| 10 000 | 8500 | 9000 - 100 = 8900 | 400-zal téved |
| 150 000 | 2100 | 9000 - 1500 = 7500 | 5400-zal téved! |
3. Lépés: az eltéréseket négyzetre emeli és összeadja (hogy a pozitív/negatív eltérések ne "kioltsák" egymást) — ez adja a teljes hibát, egyetlen számban kifejezve.
4. Lépés: megnézi, mi történne, ha kicsit másképp állítaná be az egyenest (pl. a meredekség -0.011 legyen -0.01 helyett). Újraszámolja a hibát. Ha csökkent -> jó irány, megy tovább arra. Ha nőtt -> rossz irány, fordít. (Ez a "melegebb/hidegebb" játék matematikai megfelelője.)
5. Lépés: ezt ismétli, sokszor (akár több ezerszer), apró lépésekkel, amíg a hiba már alig csökken tovább — ekkor mondja a gép: "ez a legjobb egyenes, amit találtam."
A lényeg: nincs benne intelligencia, nincs "megértés" — csak egy nagyon sokszor ismételt, egyszerű számolás: "próbáljunk egy kicsit más beállítást, nézzük meg jobb-e, ha igen, menjünk arra tovább." A model.fit(X, y) sor pontosan ezt csinálja a háttérben, emberi szemmel láthatatlanul gyorsan.
(Ezt a módszert "gradient descent"-nek hívják a szakmában — nem kell megjegyezned a nevet, csak az elvet: szisztematikus próbálgatás + hibacsökkentés alapján való korrekció.)
Azt, hogy egy lépésben mekkorát változtat a gép a beállításon, a "tanulási ráta" (learning rate) szabályozza. Ha túl nagy, a gép túllépi a legjobb megoldást és ide-oda ugrál; ha túl kicsi, nagyon lassan tanul. Ez az egyik legfontosabb beállítás, amit egy valódi modell tanításakor hangolni kell.
Rész 3 — Miért tűnik egy AI mégis "emberinek", "okosnak"?
Ami most történt (6 autó, egy egyenes) ugyanaz az alapelv, mint ami egy ChatGPT vagy Claude mögött is áll — csak több milliárdszor nagyobb léptékben, és nem egyenest, hanem szavak közötti statisztikai mintázatokat keres, ugyanezzel a "próbálgatás + hiba csökkentése" módszerrel.
Nincs benne semmi más, csak ez: rengeteg szöveget "megnézett" betanításkor, és megtanulta, hogy adott szavak után statisztikailag milyen szavak "szoktak" következni — pontosan úgy, ahogy a kis modellünk megtanulta, hogy adott km-hez milyen ár "szokott" tartozni.
Miért tűnik mégis "emberinek"? Mert az emberi nyelv maga annyira gazdag mintázatokkal teli, hogy ha valami elég jól megtanulja ezeket a mintázatokat, a kimenet úgy fest, mintha értené — anélkül, hogy bármit is "értene" a szó emberi értelmében.
Hasonlat: ez egy kicsit olyan, mint egy nagyon jó papagáj, ami nem 10, hanem milliárdnyi mondatmintát hallott, és olyan ügyesen kombinálja őket, hogy a kimenet koherensnek, sőt kreatívnak tűnik — de a "motorháztető alatt" ugyanaz a szám-alapú próbálgatás zajlik, amit az autós példán láttunk.
A szakirodalom ezt "veszteségfüggvénynek" (loss function) hívja — ez az a szám, amit a tanítás során a gép lépésről lépésre csökkenteni próbál. A mi autós példánkban ez a jóslat és a valós ár közti, négyzetre emelt eltérések összege volt; nagy nyelvi modelleknél ugyanez az elv, csak sokkal bonyolultabb, szöveg-alapú veszteségfüggvénnyel.
Rész 4 — A "stop vonal" hiánya: miért hallucinál az AI?
A LinearRegression modell szó szerint csak egy dolgot tud: ár = meredekség * km + kezdőpont
Ha behelyettesítesz egy számot, mindig kiszámolja a képlet eredményét, függetlenül attól, hogy az a szám 50 000 vagy 50 000 000. Nincs beépített "óvatosság" vagy "bizonytalanság-érzékelés".
Példa: ha megkérdezed a modellt egy 500 000 km-t futott autóról, a modell vakon folytatja ugyanazt az egyenest, és egy negatív árat adna vissza (ami nyilván képtelenség — egy autóért nem fizethetsz "mínusz pénzt"). A modell ezt nem veszi észre, mert nincs beépítve semmi, ami szólna: "hé, ez a tartomány kívül esik azon, amit valaha láttam!"
Ez nem hiba — ez a rendszer alapvető természete. A modell nem "tudja, hogy nem tudja" — csak azt tudja, amit megtanítottak neki: "ha bemenetet kapsz, adj ki egy számot/szót a mintázat alapján." Az, hogy mennyire megbízható ez a kimenet, egy külön, ráépített réteg kérdése.
Ez az oka a "hallucinációnak" nagy nyelvi modelleknél is: a statisztikai mintázat túl magabiztosan folytatott egy olyan irányba, ahol nincs valós adat mögötte — pont úgy, mintha a mi autós modellünket egy 5 000 000 km-es autóról kérdeznéd.
Rész 5 — Megoldás: hogyan építhetünk be egy "megbízhatósági indikátort"?
1. Módszer — tartomány-ellenőrzés (a legegyszerűbb, mi magunk is megépíthetjük): Megnézzük, hogy a kérdezett érték a tanító adatok tartományán belül van-e. Ha nem, figyelmeztetünk, hogy a becslés megbízhatatlan lehet (lásd a kód alul).
2. Módszer — konfidencia-intervallum (komolyabb, léteznek rá kész eszközök, pl. Bayesian regression): A modell nem egy számot ad vissza, hanem egy tartományt — pl. "a becsült ár 3200-4100 ezer Ft között van, 90%-os biztonsággal". Minél messzebb vagy az ismert adatoktól, a tartomány egyre szélesebb lesz, jelezve a bizonytalanságot.
3. Módszer — nagy nyelvi modelleknél (bonyolultabb, mert a bemenet szöveg, nem szám):
- A modell megtanulja jelezni, mikor nincs elég megbízható alapja (ez még mindig tökéletlen, ezért van hallucináció)
- Több válasz generálása és összevetése — ha egy kérdésre 5-ször kérdezed meg a modellt, és mindig ugyanazt válaszolja, valószínűbb, hogy megbízható
- Külső ellenőrzés (fact-checking) — a válasz összevetése valós, ellenőrzött forrásokkal
Rész 6 — A keretezés (framing) problémája: miért nem ellenőrzi az AI a valóságot, csak a szöveget követi?
Ez a rész közvetlenül a rész 4-ből (a "stop vonal" hiánya) következik, de egy másik, ugyanolyan fontos oldalát mutatja meg ugyanannak az alapproblémának.
Egy fontos különbségtétel, mielőtt belemegyünk: Amikor egy nyelvi modell (mint a ChatGPT vagy Claude) egy kérdésre válaszol, ő nem egy tényadatbázisból néz vissza egy "igaz/hamis" választ. Ő szöveget generál, szóról szóra, mindig azt választva, ami a tanított mintázatok alapján a legvalószínűbb folytatás — függetlenül attól, hogy a kérdésben leírt állítások ténylegesen igazak-e.
Példa (elvi, nem konkrét recept, csak a mechanizmus megértéséhez): ha valaki egy kérdést úgy fogalmaz meg, hogy a szövegkörnyezetben egy veszélyes cselekvés "jónak", "segítőnek" vagy "mindenki érdekét szolgálónak" tűnjön, a modell — mivel nincs saját, független módja arra, hogy ellenőrizze, ez az állítás igaz-e — hajlamosabb lehet azt a keretezést követni, és a szöveg logikáját "kiszolgálni", ahelyett hogy megkérdőjelezné.
Ez nem azért van, mert a modell "elhiszi" a hazugságot — hanem mert a modellnek nincs olyan beépített képessége, hogy kilépjen a szövegből, és megnézze: "de vajon tényleg igaz-e, amit ez az ember állít?" Ő csak azt látja, ami a szövegben van, és a szövegen belüli logikai/nyelvi mintázatot folytatja.
Ez pontosan ugyanaz a gyökérprobléma, mint a hallucináció (rész 4): nincs "valóság-ellenőrző" réteg a nyers nyelvi modellben — csak mintázatkövetés van, akár egy hiányzó adatról van szó (hallucináció), akár egy manipulatív keretezésről (ez a rész).
Ezért nem elég a modellre bízni a védelmet. A valódi, éles AI-rendszereknél (amiket cégek, pl. Anthropic vagy OpenAI üzemeltetnek) ezért léteznek a nyers modellen kívüli, kemény, szöveggel fel nem ülírható biztonsági szabályok és szűrőrétegek — ha csak a modell "belátására" lenne bízva a döntés, egy elég ügyesen megfogalmazott szöveg elméletileg befolyásolhatná. Ezért a védelem nem egyetlen pontban van (a modell "jó szándékában"), hanem több, egymástól független rétegben:
- a modell saját tanítása (hogy felismerje a manipulatív mintázatokat)
- a modellen kívüli, szabályalapú szűrők, amiket nem lehet szöveggel meggyőzni vagy "kibeszélni"
- emberi felügyelet és folyamatos tesztelés (ezt hívják "red teaming"-nek — erről lásd a Gyakorlás rész végét)
Szándékosan nem részletezzük itt, hogy konkrétan hogyan lehetne egy ilyen keretezéssel visszaélni — ez ugyanolyan felelőtlenség lenne, mint egy zárszerelési tananyagban lépésről lépésre leírni, hogyan kell feltörni egy konkrét zárat. A cél itt az elv megértése (miért sebezhető a nyers mintaillesztés), nem a kihasználás módszertana.
Ha komolyan érdekel az AI-biztonság (AI safety) szakmaként: ez egy valódi, aktívan kutatott terület. A legális, szakmai útvonal nem az, hogy magánemberként próbálgatod a megkerülési módszereket nyílt fórumokon — hanem hogy megismered a védekezési oldalt: hogyan épülnek fel a biztonsági rétegek, mit jelent a "red teaming" (szerződéses, engedélyezett keretek között dolgozó csapatok, akik szándékosan keresik a gyengeségeket, hogy aztán javíthatók legyenek), és mi a "felelősségteljes közzététel" (responsible disclosure) elve — vagyis ha valaki talál egy sebezhetőséget, nem nyilvánosan osztja meg, hanem bejelenti a gyártónak, hogy kijavíthassák. Ez pontosan úgy működik, mint a hagyományos szoftverbiztonságban (gondolj egy népszerű program biztonsági hibájára: a felelős kutató nem teszi közzé azonnal a kihasználás módját, hanem előbb szól a fejlesztőknek).
import pandas as pd
from sklearn.linear_model import LinearRegression
adatok = pd.DataFrame({
    "km_futott": [10000, 30000, 60000, 90000, 120000, 150000],
    "ar_ezer_ft": [8500, 7200, 5800, 4500, 3200, 2100]
})X = adatok[["km_futott"]] y = adatok["ar_ezer_ft"]
model = LinearRegression()
model.fit(X, y)
def josolj_megbizhatosaggal(uj_km):
    """
    Ez a függvény nem csak megjósolja az árat, hanem meg is
    mondja, mennyire bízhatunk a jóslatban, aszerint, hogy a
    kérdezett km-érték az ismert (tanító) adatok tartományán
    belül van-e, vagy azon kívül (extrapoláció).
    """
    km_min = adatok["km_futott"].min()
km_max = adatok["km_futott"].max() uj_auto = pd.DataFrame({"km_futott": [uj_km]})
joslat = model.predict(uj_auto)[0] print(f"Kérdezett km: {uj_km}")
print(f"Becsült ár: {joslat:.0f} ezer Ft") if uj_km < km_min or uj_km > km_max:
print(f"FIGYELEM: {uj_km} km KÍVÜL esik az ismert tartományon")
print(f"({km_min} - {km_max} km). A becslés megbízhatatlan")
print("lehet — ez extrapoláció, nem interpoláció!")
else:
print(f"A {uj_km} km az ismert tartományon ({km_min}-{km_max})")
print("belül van, a becslés megbízhatóbb.") print("-" * 50)Próbáljuk ki mindkét esetet:
josolj_megbizhatosaggal(75000)     # ismert tartományon belül
josolj_megbizhatosaggal(500000)    # messze kívül esik!
- Hívd meg a josolj_megbizhatosaggal() függvényt egy olyan km-értékkel, ami épp a tartomány szélén van (pl. 9000) — mit tapasztalsz?
- Bővítsd a függvényt: ha a kért érték kívül esik a tartományon, számold ki, hány százalékkal lépi túl azt, és írasd ki ezt is (minél nagyobb a túllépés, annál megbízhatatlanabb a becslés).
- Gondolkodj el rajta: milyen hasonló "tartomány-ellenőrzést" lehetne beépíteni egy olyan AI-rendszerbe, ami pl. egy használtautó-kereskedés vagy egy webáruház adataival dolgozna?
- Új gyakorlat (rész 6-hoz): keress rá (magyarul vagy angolul) az "AI red teaming" és a "responsible disclosure" fogalmakra. Írd le 2-3 mondatban, mi a különbség a között, hogy valaki egy sebezhetőséget felelősen jelent be egy cégnek, vagy nyilvánosan közzéteszi — és szerinted miért számít ez a különbség ennyire sokat egy biztonsági szakember munkájában.