13. lecke
PyTorch alapok: tenzorok
A PyTorch az egyik legelterjedtebb könyvtár neurális hálók építésére, az alapeleme pedig a tenzor — egy NumPy-tömbhöz hasonló számtömb, amely a tanításhoz szükséges extra képességekkel bír. A leckében megtanulod létrehozni és kezelni a tenzorokat, megismered a legfontosabb újdonságot, az automatikus deriválást (requires_grad, backward()), és azt, hogyan válts a NumPy és a PyTorch között.
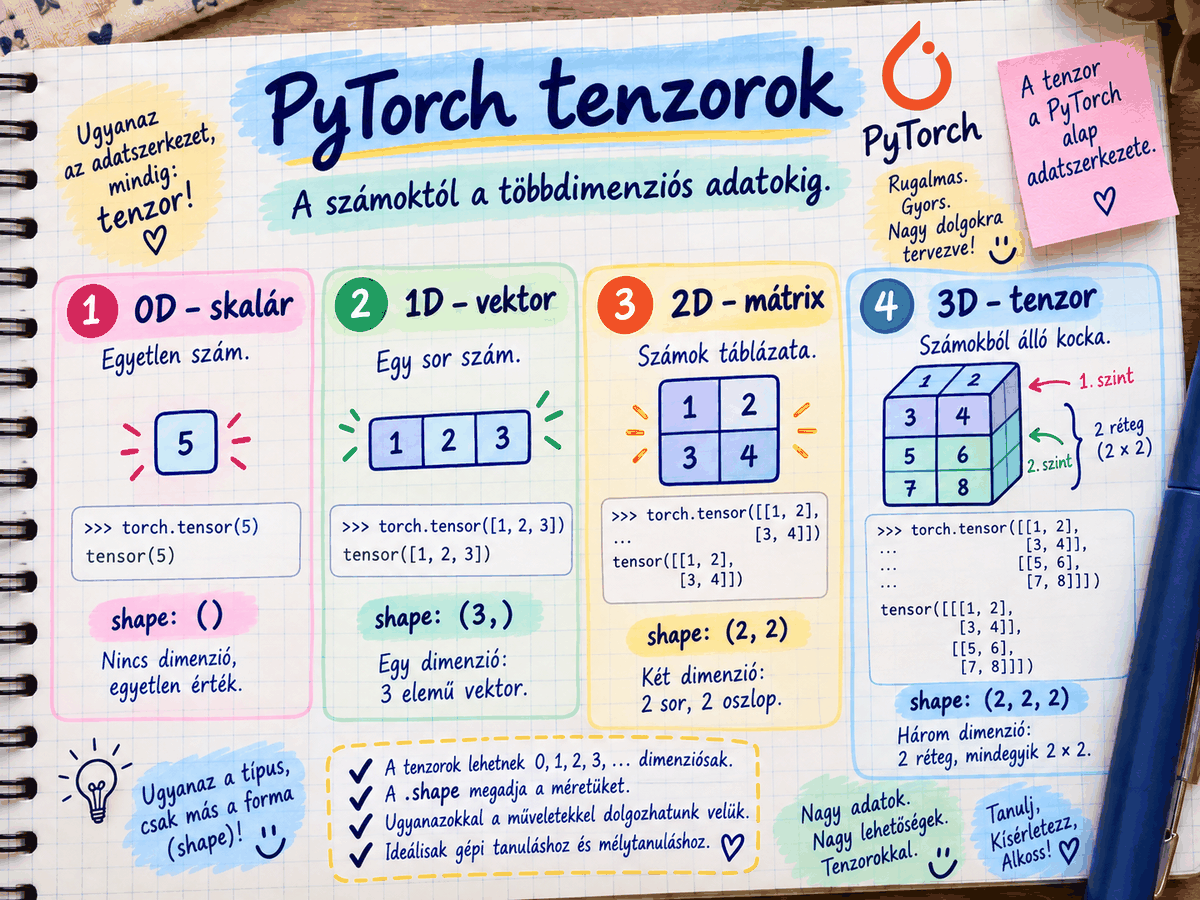
- Mi az a tenzor — és miért nem csak "másik NumPy"?
- Műveletek tenzorokon — ugyanaz, mint NumPy-nál
- A legfontosabb újdonság: requires_grad és az automatikus deriválás
- Gyakorlatibb példa — több változóval
- Tenzor és NumPy közötti átváltás
- Olvasási idő: kb. 5 perc (a kódok kipróbálásával több)
- 5 rész · 15 kódpélda
- Előfeltétel: pip install torch (Ez egy nagyobb csomag, a telepítés eltarthat pár percig.)
- A végén gyakorló feladatok ellenőrzik a tudásodat
Előfeltétel: pip install torch (Ez egy nagyobb csomag, a telepítés eltarthat pár percig.)
Mi ez valójában? Miért kell egy újabb könyvtár, ha már van NumPy-nk? A PyTorch egy kifejezetten neurális hálókhoz (mély tanuláshoz) épített könyvtár. A tenzor nagyon hasonlít a NumPy tömbhöz — valójában majdnem ugyanaz a koncepció (emlékezz a 10. lecke "fokozatok" táblázatára: szám -> lista -> mátrix -> tenzor) —, de a PyTorch tenzorai két plusz képességgel rendelkeznek, amikre kifejezetten neurális hálóknál van szükség: 1. Tudnak GPU-n (videokártyán) futni, ami sokkal gyorsabb nagy számításoknál, mint a normál processzor (CPU) 2. Van egy beépített "emlékező" képességük (automatikus deriválás), ami pontosan azt a "hiba-csökkentős tanulási folyamatot" segíti, amit a 12b leckében az autós példánál már megismertünk — csak most ez annyira bonyolult lesz (több millió paraméter), hogy kézzel már nem lehetne kiszámolni, merre kell módosítani őket — a PyTorch ezt automatizálja.
A tenzor.to("cuda") híváséval küldheted át egy tenzort a videokártya memóriájába, ha van elérhető GPU — innentől a rajta végzett számítások a GPU-n futnak, ami nagy neurális hálóknál sokszorosára gyorsíthatja a tanítást. Ha nincs GPU, a tenzor egyszerűen a processzoron (CPU-n) marad, a kód ugyanúgy működik, csak lassabban.
import torch
1. Mi az a tenzor — és miért nem csak "másik NumPy"?
tenzor_1d = torch.tensor([1, 2, 3, 4, 5])
print(tenzor_1d)
tenzor_2d = torch.tensor([
    [1, 2, 3],
    [4, 5, 6]
])
print(tenzor_2d)
print(tenzor_2d.shape)   # torch.Size([2, 3])
Ez pont ugyanúgy néz ki, mint a NumPy tömb a 10. leckéből — akkor mi a gyakorlati különbség? A létrehozás és a megjelenés valóban szinte azonos — ez szándékos, mert a PyTorch fejlesztői tudatosan a NumPy szintaxisához hasonlóra tervezték a tenzorokat, hogy aki már ismeri a NumPy-t (mint most te), könnyen átálljon. A valódi különbség csak akkor mutatkozik meg, amikor tanítani kezdünk egy modellt (lásd lentebb, a requires_grad résznél) — onnantól a tenzor "többet tud", mint egy sima NumPy tömb.
2. Műveletek tenzorokon — ugyanaz, mint NumPy-nál
tenzor = torch.tensor([1, 2, 3, 4, 5])
print(tenzor * 2)      # tensor([2, 4, 6, 8, 10])
print(tenzor + 10)     # tensor([11, 12, 13, 14, 15])
print(tenzor.sum())    # tensor(15)
print(tenzor.mean(dtype=torch.float32))   # tensor(3.)
Miért kell megadni a dtype=torch.float32-t a mean()-nél, a NumPy-nál ez nem kellett? Ez egy fontos, gyakorlati különbség: a PyTorch szigorúbb a típusokkal, mint a NumPy. Az átlagszámítás eredménye lehet tizedestört (pl. [1,2,3,4] átlaga 2.5), de ha a tenzorod egész számokból (int) áll, a PyTorch nem engedi automatikusan "kitalálni", hogy váltson át tizedestört (float) típusra — expliciten meg kell mondanod neki. Ez ugyanaz a "szigorú típusosság" elv, amit a 3. leckében már láttunk (emlékezz: a Python nem keveri automatikusan a számokat és szövegeket) — a PyTorch ezt a szigorúságot még tovább viszi a számtípusok között is, mert neurális hálóknál a pontos típuskezelés kritikus a helyes működéshez.
3. A legfontosabb újdonság: requires_grad és az automatikus deriválás
Ez a rész a PyTorch "szíve" — itt válik el igazán a NumPy-tól.
x = torch.tensor(3.0, requires_grad=True)
y = x ** 2   # y = x a négyzeten
y.backward() # ez számolja ki, "mennyire érzékeny" y az x változására
print(x.grad) # 6.0
Ez a lecke legfontosabb, de legnehezebb fogalma — vegyük lépésről lépésre, összekötve a 12b kiegészítő leckében tanult "hiba-csökkentős tanulással".
Emlékezz: a 12b leckében az autós modellünk úgy "tanult", hogy újra és újra kipróbálta, "mi történne, ha kicsit másképp állítanám be az egyenest" — ezt neveztük "hőmérő- hasonlatnak" (melegebb/hidegebb). Ott ezt egyszerű, kézzel kiszámolható matematikával csináltuk (egy egyenes meredeksége).
Egy neurális hálóban viszont nem 1-2, hanem akár millió ilyen "beállítható paraméter" van egyszerre, összekapcsolva, bonyolult módon egymással. Kézzel lehetetlen lenne kiszámolni, pontosan melyik paramétert mennyire kellene módosítani ahhoz, hogy csökkenjen a hiba.
Itt jön képbe a requires_grad=True és a .backward(): amikor egy tenzort requires_grad=True-val hozol létre, a PyTorch "figyelni kezdi", milyen számításokat végzel ezzel a tenzorral (itt: y = x ** 2). Amikor meghívod a y.backward()-öt, a PyTorch a háttérben, automatikusan kiszámolja a matematikai deriváltat — ez egy matematikai eszköz, ami pontosan azt mondja meg: "ha x-et egy icipicit megváltoztatnám, y mennyit változna emiatt?" Ez a szám (itt: 6.0) a x.grad-ban jelenik meg.
Ez pontosan az a "melegebb/hidegebb" visszajelzés, amit a 12b leckében kézzel próbálgatással szimuláltunk — csak itt a PyTorch matematikai képlettel, azonnal, pontosan kiszámolja, ahelyett hogy sokszor próbálgatna. A "6.0" onnan jön, hogy y = x², és ennek a deriváltja (a matematika szabályai szerint) 2x — mivel x = 3, ezért 2 * 3 = 6.
Ez a "trükk" (automatikus deriválás) az, ami lehetővé teszi, hogy egy neurális háló millió paraméterét egyszerre, hatékonyan lehessen "a jó irányba" hangolni tanítás közben — ez a mechanizmus rejlik minden model.fit()-hez hasonló PyTorch-hívás mögött, csak itt "backward()"-nak hívják.
A PyTorch alapból összeadja (akkumulálja) az új gradienseket a régiekhez, nem cseréli le őket. Egy valódi tanítási ciklusban ezért minden lépés elején nullázni kell a korábbi gradienseket (pl. optimizer.zero_grad()), különben a régi és az új gradiens összeadódna, és a modell rosszul tanulna. Ez az egyik leggyakoribb kezdő hiba PyTorch-kódban.
4. Gyakorlatibb példa — több változóval
a = torch.tensor(2.0, requires_grad=True)
b = torch.tensor(3.0, requires_grad=True)
c = a * b + a ** 2 # c = a*b + a²
c.backward()
print("dc/da:", a.grad)   # mennyire érzékeny c az a-ra
print("dc/db:", b.grad)   # mennyire érzékeny c a b-re
Hogyan segít ez a két külön szám (dc/da, dc/db) egy valódi tanítási helyzetben? Képzeld el, hogy "a" és "b" a neurális hálód két paramétere (a 12b leckében ezek voltak a "meredekség" és "kezdőpont"), és "c" a kiszámolt hiba (mennyire téved a modell). A .backward() után pontosan tudod: "ha az 'a' paramétert módosítom, ilyen mértékben hat a hibára" — és ugyanezt "b"-re is, egyszerre, egyetlen .backward() hívással. A PyTorch (és minden modern mély tanulási könyvtár) ezt a mechanizmust használja ki, hogy tetszőleges számú paramétert egyszerre tudjon "a jó irányba" hangolni — akár ezer, akár egymilliárd paraméterről van szó, az elv ugyanaz marad.
5. Tenzor és NumPy közötti átváltás
import numpy as np
numpy_tomb = np.array([1, 2, 3])
tenzor_numpy_bol = torch.from_numpy(numpy_tomb)
print(tenzor_numpy_bol)
tenzor = torch.tensor([4, 5, 6])
vissza_numpy = tenzor.numpy()
print(vissza_numpy)
A gyakorlatban gyakran keveredik a két világ: pl. a Pandas-szal (11. lecke) beolvasott, feldolgozott adatot gyakran NumPy-formátumban kapod meg, de a PyTorch modell csak tenzorokkal tud dolgozni. Ez az átváltási lehetőség egy "híd" a két világ között — enélkül minden alkalommal kézzel, elemenként kellene átmásolnod az adatokat egyik formátumból a másikba, ami lassú és hibalehetőséges lenne. A torch.from_numpy() és a .numpy() gyors, hatékony "fordítást" biztosítanak a két formátum között.
- Hozz létre egy 1D tenzort 1-től 10-ig terjedő számokból (torch.tensor()), majd számold ki az összegét (.sum()).
- Hozz létre egy x = torch.tensor(5.0, requires_grad=True) tenzort, majd számold ki: y = x ** 3 (x köbe). Hívd meg az y.backward()-öt, és nézd meg x.grad értékét — ellenőrizd kézzel is: egy köbfüggvény deriváltja 3x², tehát x=5-nél ennek 3 * 5² = 75-nek kellene lennie. Egyezik?
- Új gyakorlat: hozz létre két tenzort requires_grad=True-val, számolj ki velük egy tetszőleges kifejezést (pl. szorzatot vagy összeget négyzetre emelve), hívd meg a backward()-öt, és nézd meg mindkét tenzor .grad értékét — gondolkodj el rajta, hogyan kapcsolódik ez ahhoz, amit a 12b leckében a "hiba-csökkentős tanulásról" olvastál.
Források és további olvasnivaló
A lecke témájának hivatalos dokumentációi és alapvető cikkei:
• PyTorch — alapok (hivatalos bevezető) — pytorch.org