34. lecke
Képgeneráló és multimodális modellek: hogyan lesz a szövegből kép?
Egy mondatból pár másodperc alatt fotószerű kép, egy fényképről részletes leírás, egy hangfelvételből szöveg — ezek a multimodális és képgeneráló modellek. Ez a lecke elmagyarázza, hogyan működik a mai képgenerálás alapja, a diffúziós modell (zajból lépésenként kép), hogyan kapcsolódik össze a szöveg és a kép egy közös „jelentéstérben", mire használhatók ezek az eszközök, és milyen jogi, etikai kérdéseket vetnek fel. Egy kis NumPy-programon saját szemeddel látod a „zajosítás" folyamatát.
- Mi az a multimodális modell?
- A diffúziós modell: zajból kép
- Mire jók a gyakorlatban?
- Korlátok: mit ront el még mindig?
- Jog, etika, hitelesség
- Hogyan ismerd fel az AI-val készült képet?
- Olvasási idő: kb. 5 perc (a kódok kipróbálásával több)
- 6 rész · 1 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
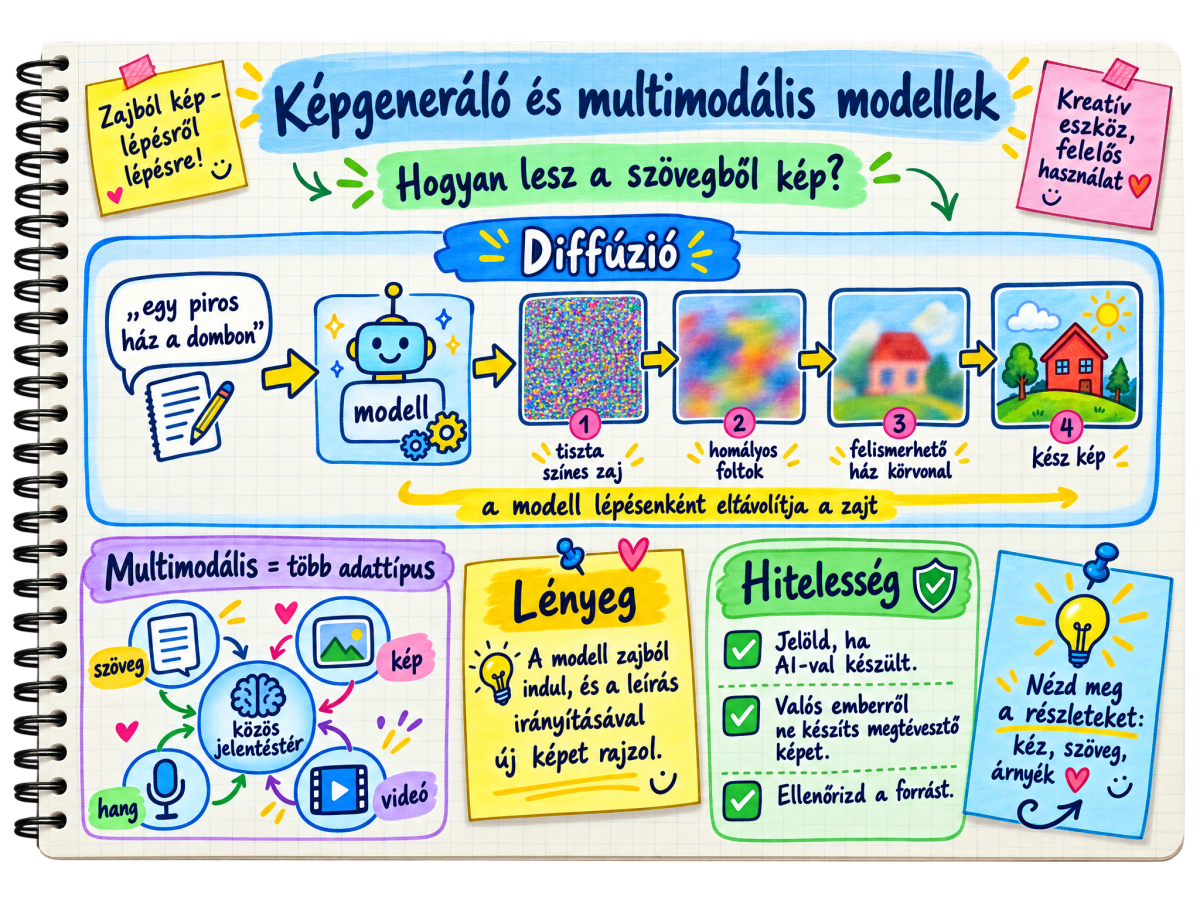
Rész 1 — Mi az a multimodális modell?
A „modalitás" az adat fajtáját jelenti: szöveg, kép, hang, videó. Az eddigi leckék modelljei többnyire egyféle adattal dolgoztak (a 17. lecke nyelvi modellje szöveggel, a 14b. lecke konvolúciós hálója képekkel). A multimodális modell többféle adatot kezel egyszerre: képet „lát" és szöveggel válaszol róla, vagy szövegből képet készít.
A kulcsötlet a közös jelentéstér. A 17. leckében láttad, hogy az embedding a szavak jelentését vektorként írja le. A multimodális modellek úgy tanulnak, hogy egy kép és a hozzá illő szöveges leírás vektora közel kerüljön egymáshoz. Egy ismert korai példa erre az OpenAI 2021-es CLIP modellje, amelyet több száz millió kép–szöveg páron tanítottak: így a „piros kerékpár" szöveg vektora a piros kerékpárt ábrázoló képek vektorai közelében lesz.
A képet kis négyzetekre (foltokra, „patch"-ekre) bontja, és minden foltból egy vektort készít — ezek a vektorok ugyanúgy kerülnek a Transformer elé, mint a szöveg tokenjei (17. lecke). A modell számára a kép így „vizuális tokenek" sorozata lesz, amelyre a figyelem mechanizmusa ugyanúgy működik.
Rész 2 — A diffúziós modell: zajból kép
A mai képgenerátorok többsége diffúziós modell. Az ötlet meglepően egyszerű, és két irányból áll:
- Előre irányú folyamat (tanításkor): fogunk egy valódi képet, és lépésről lépésre egyre több véletlen zajt keverünk hozzá, amíg teljesen felismerhetetlen „hóesés" nem lesz belőle.
- Visszafelé irányú folyamat (generáláskor): egy neurális hálót arra tanítunk, hogy egy zajos képről megmondja, mennyi és milyen zajt kell eltávolítani belőle. Ha ezt jól megtanulta, akkor tiszta zajból kiindulva, lépésről lépésre „kitisztít" egy teljesen új képet.
A tanítás tehát ismét a jól ismert séma (12b., 14. lecke): a háló tippel (mennyi a zaj), összevetjük a valódi, általunk hozzáadott zajjal, és a hibát visszaterjesztéssel csökkentjük. A szöveges leírás („egy macska napszemüvegben") a generálás közben irányítja a folyamatot: a háló minden lépésben olyan irányba tisztít, amely a szöveg jelentéséhez illik.
Próbáld ki: így tűnik el egy kép a zajban
Az alábbi program egy 8×8-as „képen" (középen egy fehér négyzet) mutatja meg az előre irányú folyamatot. Minden lépésben egy kis zajt keverünk hozzá, és kiírjuk, mennyire hasonlít még az eredetire.
import numpy as np

rng = np.random.default_rng(0)

# Egy 8x8-as "kép": fekete háttér, közepén fehér négyzet (0 = fekete, 1 = fehér)
kep = np.zeros((8, 8))
kep[2:6, 2:6] = 1.0

def rajzol(t):
    return "\n".join("".join("█" if x > 0.5 else "·" for x in sor) for sor in t)

# Előre irányú folyamat: lépésenként egyre több zajt keverünk a képhez
print("0. lépés — az eredeti kép:")
print(rajzol(kep), "\n")

lepesek = [2, 5, 10]
beta = 0.15                        # mennyi zaj jön minden lépésben
x = kep.copy()
for t in range(1, 11):
    zaj = rng.normal(0, 1, kep.shape)
    x = np.sqrt(1 - beta) * x + np.sqrt(beta) * zaj
    if t in lepesek:
        hasonlosag = np.corrcoef(kep.ravel(), x.ravel())[0, 1]
        print(f"{t}. lépés — hasonlóság az eredetihez: {hasonlosag:.2f}")
        print(rajzol(x), "\n")

# A generáló modell ennek a FORDÍTOTTJÁT tanulja meg: a tiszta zajból
# lépésenként kitalálja és eltávolítja a zajt, amíg kép nem lesz belőle.
A kimenetben a négyzet a 2. lépésben még sejthető (hasonlóság kb. 0,56), az 5. lépésben már alig (kb. 0,26), a 10. lépésre pedig gyakorlatilag eltűnik a zajban (kb. 0,11). A diffúziós modell tanulása éppen erről szól: megtanulja ezt a folyamatot visszafelé végigjárni. Egy valódi modell nem 8×8-as, hanem több százezer pixeles képekkel és jellemzően néhány tucat lépéssel dolgozik.
Mert az túl lassú lenne. A legtöbb modern képgenerátor egy tömörített, kisebb „látens térben" végzi a zajtalanítást (innen a „latent diffusion" név), és csak a végén alakítja vissza az eredményt teljes méretű képpé. Ez nagyságrendekkel csökkenti a számítási igényt.
Rész 3 — Mire jók a gyakorlatban?
| Feladat | Példa | Mire figyelj? |
|---|---|---|
| Kép leírása, elemzése | Termékfotó hibáinak felismerése, dokumentum vagy táblázat beolvasása képről | Apró részleteknél (számok, kis betűk) tévedhet — ellenőrizd. |
| Képgenerálás szövegből | Illusztráció, hirdetési vázlat, ötletelés | Szöveg a képen, kezek, pontos márkaelemek gyakran hibásak. |
| Képszerkesztés | Háttér cseréje, tárgy eltávolítása, kép kibővítése | Valós személyekről készült képek módosítása etikai és jogi kérdés. |
| Hang és beszéd | Beszédfelismerés, felolvasás, fordítás élőben | Hangklónozás: csalásra is használják (32. lecke). |
| Akadálymentesség | Képleírás látássérülteknek | Az egyik legértékesebb, valós felhasználás. |
Ugyanazok az elvek érvényesek, mint a 26. leckében: legyél konkrét. Írd le a témát (mi van a képen), a stílust (fotó, akvarell, vonalrajz), a kompozíciót (közeli, madártávlat), a fényt és hangulatot, és ha fontos, azt is, mi ne legyen rajta. Az első eredmény ritkán tökéletes — a finomítás lépésenként megy.
Rész 4 — Korlátok: mit ront el még mindig?
- Szöveg a képen: sokat javult, de feliratoknál, címkéknél gyakori a betűhiba.
- Számolás és térbeli viszonyok: „pontosan hét alma", „a bögre a könyv mögött" — ezeket a modellek gyakran elvétik.
- Következetesség: ugyanazt a szereplőt több képen át egyformán megjeleníteni külön technikát igényel.
- Torzítások: a tanítóadatok egyoldalúságai megjelennek a képeken is (például kit ábrázol a modell „orvosként" vagy „mérnökként" — 32. lecke).
- Képelemzésnél a hallucináció: a modell magabiztosan leírhat olyan részletet is, ami nincs a képen.
Rész 5 — Jog, etika, hitelesség
A képgenerálás körüli viták a 32. leckében részletezett aggályok közül többet is érintenek:
- Szerzői jog: a modelleket rengeteg, gyakran engedély nélkül gyűjtött képen tanították; a bíróságok eltérően ítélik meg a kérdést (32. lecke, 4. rész). Saját munkánál ellenőrizd a szolgáltató felhasználási feltételeit.
- Valós személyek: hamis képek, beleegyezés nélküli intim képek („deepfake") komoly károkat okoznak; az EU-ban a digital omnibus ezeket kifejezetten tiltja (27., 32. lecke).
- Jelölés: az EU AI Act átláthatósági szabályai szerint az AI-val generált vagy manipulált tartalmat jelölni kell. Terjed a tartalom-hitelesítés is (például a C2PA szabvány „tartalom-igazolványai"), amely a kép metaadataiban rögzíti, hogyan készült.
Valós, azonosítható emberről soha ne készíts vagy terjessz megtévesztő képet a beleegyezése nélkül — ez etikailag és sok országban jogilag is súlyos. Üzleti célra használt AI-képnél jelöld, hogy AI-val készült.
Rész 6 — Hogyan ismerd fel az AI-val készült képet?
Teljesen biztos módszer nincs, és a modellek fejlődésével egyre nehezebb. Néhány jel mégis segíthet:
- furcsa részletek: kezek, fogak, ékszerek, szemüvegkeretek, hátterekben elmosódó feliratok;
- fizikailag lehetetlen árnyékok, tükröződések, szimmetriák;
- túl „tökéletes", műanyagszerű bőr és fény;
- a kép eredete: fordított képkereséssel (például Google Lens) nézd meg, honnan származik, és van-e hiteles forrása;
- tartalom-hitelesítési adatok (C2PA), ha a kép tartalmazza őket.
Csak korlátozottan: gyakran tévednek mindkét irányba, és egy tömörített, átméretezett kép könnyen megtéveszti őket. Egy ilyen eszköz eredménye jelzés lehet, de bizonyíték nem. A legbiztosabb továbbra is a forrás ellenőrzése.
Összefoglaló táblázat
| Fogalom | Mit jelent? |
|---|---|
| Multimodális modell | Többféle adatot (szöveg, kép, hang) kezel egyszerre |
| Közös jelentéstér | A kép és a hozzá illő szöveg vektora közel kerül egymáshoz |
| Diffúziós modell | Tiszta zajból lépésenként „kitisztított" kép |
| Látens tér | Tömörített belső ábrázolás, amelyben a generálás gyorsabb |
| Tartalom-hitelesítés (C2PA) | Metaadat arról, hogyan készült egy kép |
1. Módosítsd a programban a beta értékét 0,05-re, majd 0,4-re. Hogyan változik, milyen gyorsan tűnik el a négyzet?
2. Rajzolj a 8×8-as képre egy másik alakzatot (például egy vízszintes vonalat), és futtasd újra.
3. Írj egy képgeneráló promptot a Rész 3 széljegyzetének öt szempontja szerint egy kitalált termék hirdetéséhez.
4. Keress egy vírusként terjedő képet, és ellenőrizd a Rész 6 módszereivel: mit tudsz meg az eredetéről?
5. Gondold végig: egy kisvállalkozás weboldalán milyen feltételekkel használnál AI-val generált képeket?
A 34. lecke végére érted, mit jelent a multimodális modell és a közös jelentéstér, hogyan hoz létre a diffúziós modell zajból képet, mire használhatók ezek az eszközök, hol hibáznak még, és milyen jogi, etikai szabályokra kell figyelni. Tudod azt is, hogyan ellenőrizd egy gyanús kép eredetét.