33. lecke
RAG és vektoradatbázisok: hogyan „olvassa" az AI a saját dokumentumaidat?
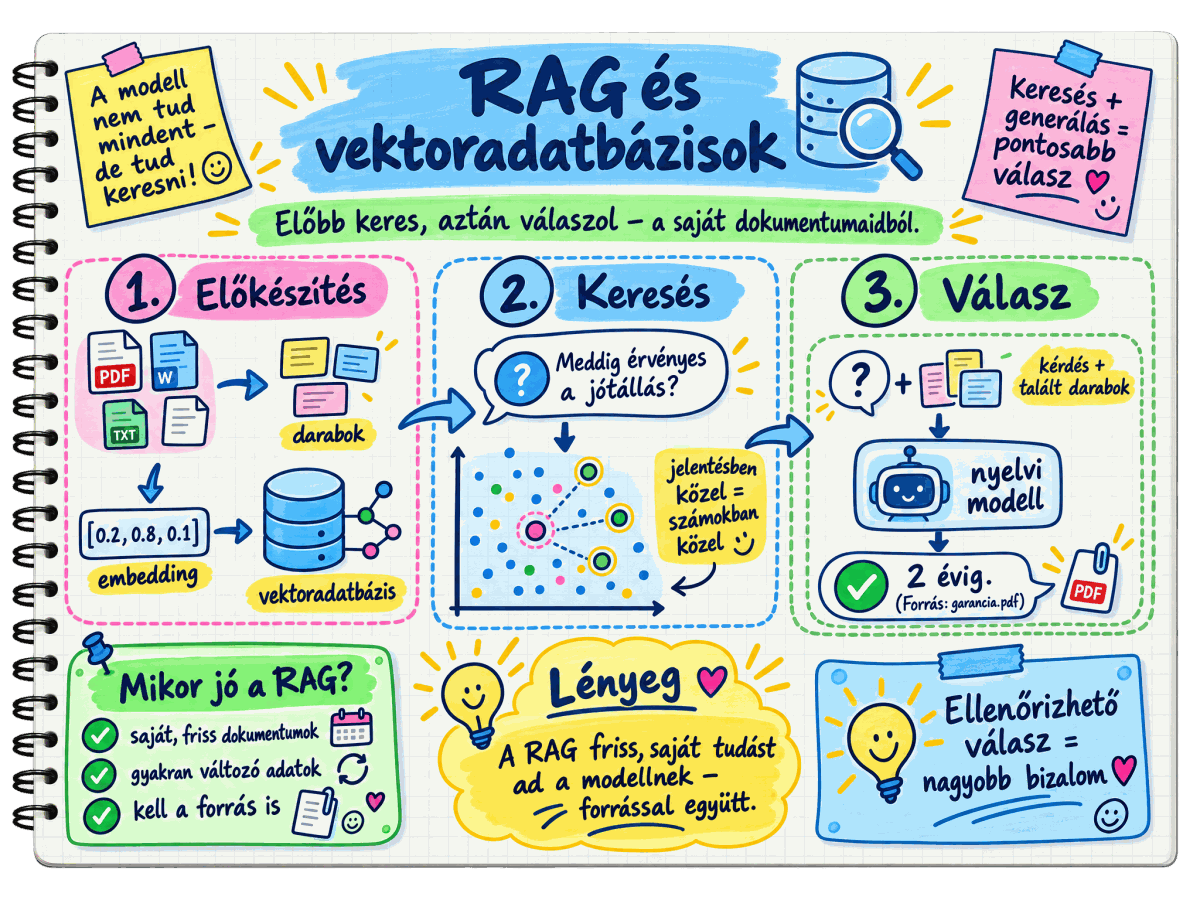
A nyelvi modellek sokat tudnak a világról, de a te cégedről, a te dokumentumaidról, a tegnapi árlistádról semmit. Ez a lecke bemutatja a RAG-ot (retrieval-augmented generation, „kereséssel kiegészített szöveggenerálás"), a mai AI-alkalmazások egyik leggyakoribb építőelemét: hogyan keres ki egy rendszer a saját dokumentumaidból releváns részleteket, és hogyan ad a modell ezekre támaszkodva pontos, forrással alátámasztott választ. Megépítesz egy működő mini-RAG-ot is, csak NumPy-jal.
- A probléma: amit a modell nem tudhat
- A RAG három lépése
- Építsünk egy mini-RAG-ot
- Mitől lesz jó egy RAG-rendszer?
- Kockázatok és korlátok
- Mikor RAG, mikor finomhangolás?
- Olvasási idő: kb. 5 perc (a kódok kipróbálásával több)
- 6 rész · 1 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Rész 1 — A probléma: amit a modell nem tudhat
A 17. leckében láttad, hogy egy nyelvi modell a tanítóadataiból tanul, és van egy „tudáshatára" (knowledge cutoff): ami utána történt, vagy ami sosem volt nyilvános, azt nem ismeri. Ha megkérdezed tőle, mennyi garanciát ad a cégetek a javításokra, két rossz dolog történhet: vagy bevallja, hogy nem tudja, vagy — rosszabb esetben — kitalál egy hihető választ (hallucinál, 12b. lecke).
Kézenfekvő ötlet lenne a modellt a saját adataidon továbbtanítani (finomhangolás, 23. lecke). Ez azonban drága, lassú, és minden árváltozásnál újra kellene csinálni. Ráadásul a finomhangolás inkább stílust és viselkedést tanít, a pontos tények „beleégetésére" kevésbé megbízható.
A RAG egy egyszerűbb utat választ: a modellt nem tanítjuk át, hanem minden kérdésnél odaadjuk neki a válaszhoz szükséges részleteket. Olyan ez, mint egy nyílt könyves vizsga: a diák nem magolja be a teljes könyvet, hanem tudja, hol keresse, és a talált oldalak alapján válaszol.
Kevés dokumentumnál ez működik is. Egy cég tudásbázisa azonban könnyen több ezer oldal, ami nem fér el a modell kontextusablakában — és ha el is férne, minden kérdésnél drága lenne (a tokenek pénzbe kerülnek, 28. lecke), és a modell a sok felesleges szöveg között könnyebben elsiklik a lényeg felett. A RAG csak a releváns néhány részletet adja át.
Rész 2 — A RAG három lépése
1. Előkészítés: darabolás és indexelés
A dokumentumokat kisebb darabokra (chunk) vágjuk — tipikusan néhány bekezdésnyi, pár száz szavas részekre, gyakran kis átfedéssel, hogy egy gondolat ne szakadjon ketté. Minden darabhoz kiszámolunk egy embeddinget (17. lecke): egy számvektort, amely a darab jelentését írja le. Ezeket a vektorokat egy vektoradatbázisba mentjük.
2. Keresés
Amikor kérdés érkezik, a kérdésből is embeddinget készítünk, és megkeressük azokat a darabokat, amelyek vektora a legközelebb esik hozzá. A „közelséget" leggyakrabban koszinusz-hasonlósággal mérjük: két vektor annál hasonlóbb, minél kisebb a szög közöttük (00b. lecke: vektorok).
3. Válaszgenerálás
A megtalált darabokat a kérdéssel együtt beillesztjük a promptba, és utasítjuk a modellt, hogy csak ezek alapján válaszoljon, és jelezze, ha a válasz nincs benne (26. lecke: strukturált prompt, system prompt).
Egy hagyományos adatbázis pontos egyezést keres („ahol a név = Kovács"). A vektoradatbázis hasonlóságot: megtalálja a „garanciaidő" kérdésre a „6 hónapot vállalunk a javításokra" mondatot akkor is, ha egyetlen közös szó sincs bennük. Ehhez speciális, gyors közelítő keresési algoritmusokat használ, hogy milliónyi vektor között is ezredmásodpercek alatt találjon.
Rész 3 — Építsünk egy mini-RAG-ot
Az alábbi program egy apró tudásbázisban keres. Az egyszerűség kedvéért az „embedding" itt csak szógyakorisági vektor (melyik szó hányszor fordul elő) — a valódi rendszerek neurális embedding-modellt használnak, amely a jelentést is érti, nem csak a közös szavakat. A működés elve azonban pontosan ugyanaz.
import numpy as np
import re

# 1) A "tudásbázis": néhány rövid dokumentum (a valóságban lehet ezer PDF is)
dokumentumok = [
    "Nyitvatartás: hétfőtől péntekig 9 és 17 óra között, szombaton 9 és 12 óra között vagyunk nyitva.",
    "Garancia: a javításokra 6 hónap garanciát vállalunk, az alkatrészekre a gyártói garancia érvényes.",
    "Szállítás: a csomagokat 2-3 munkanapon belül kiszállítjuk, 20 000 Ft felett ingyen.",
    "Fizetés: készpénzzel, bankkártyával és átutalással is lehet fizetni.",
]

def szavak(szoveg):
    return re.findall(r"[a-záéíóöőúüű0-9]+", szoveg.lower())

# 2) Nagyon egyszerű "embedding": szógyakorisági vektor (a valóságban neurális modell készíti)
szotar = sorted({sz for d in dokumentumok for sz in szavak(d)})
def vektor(szoveg):
    v = np.zeros(len(szotar))
    for sz in szavak(szoveg):
        if sz in szotar:
            v[szotar.index(sz)] += 1
    return v

doc_vektorok = np.array([vektor(d) for d in dokumentumok])

def koszinusz(a, b):
    if not a.any() or not b.any():
        return 0.0
    return float(a @ b / (np.linalg.norm(a) * np.linalg.norm(b)))

# 3) Keresés: a kérdéshez leginkább hasonló dokumentumok
def keres(kerdes, k=2):
    q = vektor(kerdes)
    pontok = [koszinusz(q, d) for d in doc_vektorok]
    sorrend = np.argsort(pontok)[::-1][:k]
    return [(round(pontok[i], 2), dokumentumok[i]) for i in sorrend]

kerdes = "Hány hónap garancia van a javításokra?"
talalatok = keres(kerdes)
for pont, szoveg in talalatok:
    print(pont, "|", szoveg[:60])

# 4) A prompt összeállítása: a nyelvi modell csak a talált részletekből válaszolhat
kontextus = "\n".join(f"- {szoveg}" for _, szoveg in talalatok)
prompt = (f"Csak az alábbi részletek alapján válaszolj. Ha nincs benne a válasz, mondd, hogy nem tudod.\n"
          f"Részletek:\n{kontextus}\n\nKérdés: {kerdes}")
print()
print(prompt)
A kimenetben a garanciáról szóló dokumentum kapja a legnagyobb pontszámot (0,73), messze megelőzve a többit, ezért az kerül a prompt elejére. A nyelvi modell ebből már pontosan tud válaszolni: 6 hónap. Figyeld meg a prompt utasítását is: „Ha nincs benne a válasz, mondd, hogy nem tudod" — ez a hallucináció elleni egyik legfontosabb védelem.
Mert csak a szó szerinti egyezést látja: az egyszavas „Jótállás?" kérdésre egyetlen dokumentum sem kap pontot, hiszen a „jótállás" szó sehol nem szerepel — a garanciás mondatot nem találja meg. Ráadásul a gyakori kötőszavak (a, az, és) közös előfordulása hamis hasonlóságot is okozhat. A neurális embedding-modellek tudják, hogy a jótállás és a garancia rokon fogalmak — ezért a gyakorlatban mindig ilyet használunk.
Rész 4 — Mitől lesz jó egy RAG-rendszer?
A RAG egyszerű ötlet, de a minőség sok apró döntésen múlik:
| Döntés | Mire figyelj? |
|---|---|
| Darabméret | Túl kicsi darabból hiányzik a szövegkörnyezet, túl nagyból sok a felesleges szöveg. Kiindulásnak jó a néhány bekezdés, kis átfedéssel. |
| Embedding-modell | Legyen jó a magyar nyelven is — ezt érdemes néhány saját kérdéssel tesztelni. |
| Hány darabot adunk át? | Általában 3–10. Kevés darabbal lemaradhat a válasz, túl sokkal összezavarodhat a modell. |
| Hibrid keresés | A jelentés szerinti (vektoros) és a kulcsszavas keresés kombinálása gyakran jobb, főleg termékkódoknál, neveknél. |
| Forrásmegjelölés | Kérd a modellt, hogy jelölje, melyik részletből dolgozott — így a felhasználó ellenőrizheti. |
| Naprakészség | Ha egy dokumentum változik, csak annak a darabjait kell újraindexelni. |
Ugyanúgy, mint bármely modellt (24. lecke): készíts egy tesztlistát 20–50 valós kérdéssel és a helyes válaszokkal. Nézd meg külön, hogy a keresés megtalálta-e a jó részletet, és hogy a modell helyesen válaszolt-e belőle — a két hibaforrás különböző javítást igényel.
Rész 5 — Kockázatok és korlátok
- A RAG sem hallucinációmentes. Ha a keresés rossz részletet talál, a modell magabiztosan válaszolhat rosszul. A forrásmegjelölés és a „nem tudom" utasítás sokat segít, de nem ad teljes biztonságot.
- Jogosultságok. Ha a tudásbázisban bizalmas dokumentum is van, a keresésnek tiszteletben kell tartania, hogy ki mit láthat — különben a chatbot kiadhat olyan adatot, amelyhez a kérdezőnek nincs joga (27. lecke: GDPR).
- Prompt injection. A beolvasott dokumentumokba rejtett utasítás megpróbálhatja eltéríteni a modellt (29. lecke). Idegen forrásból származó dokumentumoknál ez valós kockázat.
- Elavult vagy ellentmondó dokumentumok. Ha a régi és az új árlista is benne van, a modell bármelyiket idézheti. A tudásbázist karban kell tartani.
A RAG ott van a legtöbb „kérdezz a dokumentumaidtól" funkció mögött: céges belső tudásbázis-kereső, ügyfélszolgálati chatbot, a jegyzeteidben kereső asszisztens, vagy amikor egy AI-asszisztensnek feltöltesz egy PDF-et, és arról kérdezed.
Rész 6 — Mikor RAG, mikor finomhangolás?
| Szempont | RAG | Finomhangolás (23. lecke) |
|---|---|---|
| Mire jó? | Tények, dokumentumok, gyakran változó információ | Stílus, formátum, szakmai viselkedés |
| Frissítés | Olcsó: csak újraindexelés | Drága: újratanítás |
| Forrásmegjelölés | Természetes módon lehetséges | Nehéz |
| Kezdeti költség | Alacsony | Magasabb (adat-előkészítés, tanítás) |
A gyakorlatban a kettő kiegészíti egymást: a finomhangolás megtanítja, hogyan válaszoljon a modell, a RAG pedig megadja, miből. Kisvállalkozásnál szinte mindig a RAG az első lépés.
Összefoglaló táblázat
| Fogalom | Mit jelent? |
|---|---|
| RAG | Kereséssel kiegészített generálás: a modell a kikeresett részletek alapján válaszol |
| Darabolás (chunking) | A dokumentumok kisebb, kereshető részekre vágása |
| Embedding | A szöveg jelentését leíró számvektor |
| Vektoradatbázis | Hasonlóság szerint kereső adatbázis |
| Koszinusz-hasonlóság | Két vektor hasonlóságának mértéke a köztük lévő szög alapján |
| Hibrid keresés | Vektoros és kulcsszavas keresés együtt |
1. Futtasd a mini-RAG-ot a „Mikor vagytok nyitva szombaton?" kérdéssel. Melyik dokumentum nyer, és mekkora pontszámmal?
2. Kérdezd meg egyetlen szóval: „Jótállás?" Milyen pontszámokat kapsz, és miért? Hogyan segítene egy neurális embedding-modell?
3. Adj hozzá egy ötödik dokumentumot a saját vállalkozásodról vagy egy kitalált cégről, és tegyél fel rá kérdést.
4. Írj egy system promptot egy RAG-os ügyfélszolgálati chatbothoz: mit tegyen, ha a részletekben nincs benne a válasz, és hogyan jelölje a forrást?
5. Gondold végig: milyen dokumentumokat NEM tennél be egy nyilvános chatbot tudásbázisába, és miért?
A 33. lecke végére érted, miért nem tud a nyelvi modell a saját dokumentumaidról, és hogyan oldja meg ezt a RAG: darabolás, embedding, vektoros keresés, majd a talált részletekre épülő válasz. Megépítettél egy működő mini-RAG-ot, ismered a minőséget befolyásoló döntéseket és a kockázatokat, és el tudod dönteni, mikor RAG, mikor finomhangolás a jobb választás.
Források és további olvasnivaló
A téma alapvető cikkei és dokumentációi:
• Lewis és mtsai.: Retrieval-Augmented Generation (2020) — arxiv.org
• Anthropic: Contextual Retrieval — anthropic.com
• Sentence Transformers (embedding-modellek) — sbert.net