00b. lecke
Matematikai alapok: lineáris algebra és valószínűség
Gyakorlatban (alapozó lecke): vektorok és mátrixok valódi jelentése (nem elvont matek, hanem amit a modell ténylegesen csinál velük) + valószínűség/statisztika alapfogalmak.
A gépi tanulás mögött néhány matematikai fogalom áll: vektor, mátrix, valószínűség, átlag, szórás és gradiens. Ez a lecke ezeket nem elvont matekként, hanem úgy mutatja be, ahogy egy modell ténylegesen használja őket — kóddal és hétköznapi példákkal. A végére érteni fogod, mit számol egy neurális háló rétege, és mit jelent, amikor egy modell valószínűséget ad.
- Mi egy vektor, valójában? (nem elvont matek, hanem gyakorlati jelentés)
- Mi egy mátrix, és mit csinál valójában a nn.Linear() (14. lecke)?
- Valószínűség alapfogalmak: mit jelent, hogy a modell "84%-ban biztos"?
- Átlag és szórás: mit jelentenek pontosan? (emlékeztető a 20. és 22. lecke…
- A gradiens: mi a kapcsolat a deriválás (14c lecke) és a vektorok/mátrixok…
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 6 rész · 19 kódpélda
- A végén gyakorló feladatok ellenőrzik a tudásodat
Miért kapott ez a lecke "00b" számot? Ez a lecke alapozza meg a teljes 1-28. lecke-sorozatot — logikailag a legelejére tartozik (ezért "00"), mert több későbbi lecke (14, 14b, 14c, 15, 17, 20-25) ezekre a fogalmakra épít (vektor, mátrix, szórás, átlag, valószínűség) — itt a nulláról, rendszerezetten megismered őket. Ha már túl vagy azokon a leckéken, ez a lecke utólag is megmutatja, mi történt a háttérben.
Mert eddig a tenzorokkal/mátrixokkal "fekete dobozként" dolgoztál — a PyTorch/NumPy elvégezte a számítást, te csak használtad az eredményt. Ez a lecke megnyitja a "fekete dobozt": megérted, mi történik pontosan, amikor a 14. lecke nn.Linear(1, 16) sora lefut, vagy amikor a 20. lecke szórást számol — ez az a szint, ahol már nem csak használod az AI-t, hanem valóban érted is.
import numpy as np
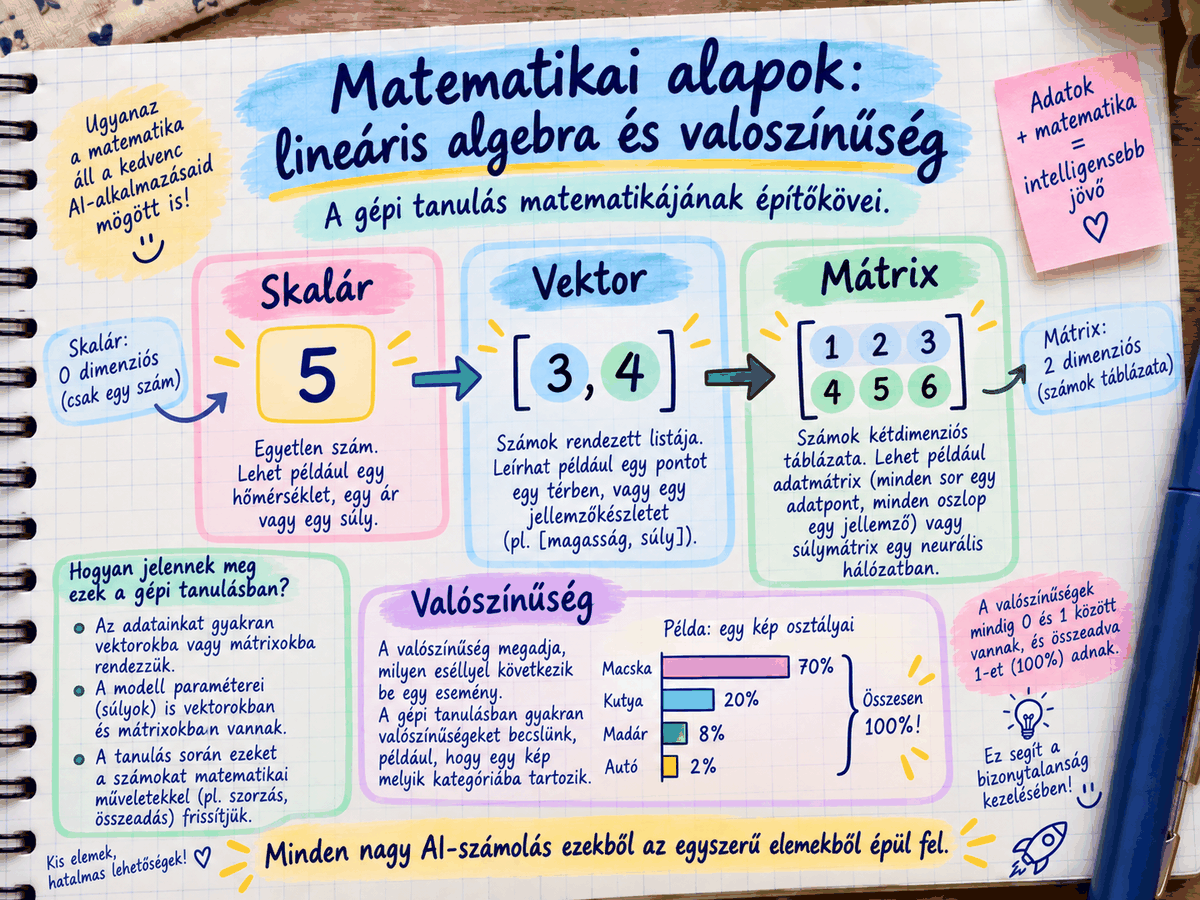
Rész 1 — Mi egy vektor, valójában? (nem elvont matek, hanem gyakorlati jelentés)
A matematikaórán a vektort gyakran "nyilaként" tanítják (irány + hossz) — ez igaz, de az AI-ban a vektornak egy sokkal gyakorlatibb jelentése van: egy vektor egyszerűen egy rendezett számlista, ahol minden egyes szám egy-egy tulajdonságot (feature-t) ír le.
Példa: képzeld el, hogy leírsz egy autót számokkal (emlékeztető a 14b lecke döntési fa példájára):
auto_vektor = np.array([2015, 120000, 3])
[gyártási év, kilóméteróra állás, tulajdonosok száma]
print("Az autó vektor alakban:", auto_vektor)
print(f"Ez PONTOSAN 3 SZÁMBÓL áll — tehát ez egy '3-DIMENZIÓS' vektor.")
print()
Mit jelent pontosan a 'dimenzió' szó itt? A dimenzió egyszerűen a vektorban lévő számok darabszáma — ha 3 számmal írsz le valamit, az egy 3-dimenziós vektor, ha 300 számmal, akkor 300-dimenziós. A "dimenzió" szó a hétköznapi nyelvben (3D tér: szélesség-magasság-mélység) csak egy speciális esete ennek — a matematikában/AI-ban egy vektor nyugodtan lehet 768 vagy 4096 dimenziós is (emlékeztető a 17. lecke embedding fogalmára: egy szót tipikusan százas-ezres nagyságrendű dimenziójú vektorral írunk le!) — ez csak annyit jelent, hogy az adott szót/dolgot ennyi számmal/tulajdonsággal jellemezzük.
A vektorokkal lehet számolni — és ez a számolás az, ami a gépi tanulás alapja:
auto2_vektor = np.array([2018, 80000, 2])
Összeadás (elemenként):
osszeg = auto_vektor + auto2_vektor
print(f"Két autó vektor összege (elemenként): {osszeg}")
print("(Ennek itt nincs sok gyakorlati értelme, de MUTATJA a MŰVELETET.)")
print()
A leggyakorlatibb művelet: a "távolság" két vektor között — ez az alapja pl. a 14b lecke k-NN (k-legközelebbi szomszéd) algoritmusának!
tavolsag = np.linalg.norm(auto_vektor - auto2_vektor)
print(f"A két autó 'távolsága' (euklideszi távolság): {tavolsag:.2f}")
print()
Mire jó ez a 'távolság'? Emlékeztető a 14b lecke k-NN algoritmusára: ha meg akarod határozni, melyik két autó "hasonlít" legjobban egymásra, vagy egy új adatpont (pl. egy új autó) melyik korábbi csoporthoz áll legközelebb — ez pontosan ez a távolságszámítás. A gépi tanulás nagy része valójában "távolságok mérése sokdimenziós térben" — ez egy kulcsfontosságú, visszatérő gondolat.
Nem feltétlenül. Szöveg- és képbeágyazásoknál (embeddingeknél) gyakran inkább a koszinusz-hasonlóságot használják, ami a vektorok irányát hasonlítja össze, nem a hosszát. Így két hasonló jelentésű mondat embeddingje akkor is "közelinek" számíthat, ha a vektorok hossza eltérő.
Rész 2 — Mi egy mátrix, és mit csinál valójában a nn.Linear() (14. lecke)?
Egy mátrix egyszerűen számok táblázata — sorok és oszlopok. Gondolj rá úgy, mint több vektor egymás alá pakolva:
mintaadat_matrix = np.array([
    [2015, 120000, 3],   # 1. autó
    [2018, 80000,  2],   # 2. autó
    [2020, 30000,  1],   # 3. autó
])print("3 autó egy mátrixban (3 sor = 3 autó, 3 oszlop = 3 tulajdonság):")
print(mintaadat_matrix)
print()Emlékeztető a 15. lecke pandas.DataFrame-jére: egy DataFrame lényegében egy mátrix, csak oszlopnevekkel/címkékkel kiegészítve — amikor a 15. leckében torch.tensor(adatok[["latogatok"]].values) hívtad meg, valójában a DataFrame-ből "kivetted" a tiszta számmátrixot, és azt adtad át a modellnek.
A legfontosabb művelet: mátrix-vektor szorzás — ez az, amit egy neurális háló rétege (14. lecke nn.Linear) ténylegesen csinál!
Tegyük fel, van egy nagyon egyszerű "súlymátrixunk" (ez az, amit a modell a tanítás során tanul meg — emlékeztető a 12b lecke "súlyok" fogalmára):
sulymatrix = np.array([
    [0.5, -0.2, 0.1],   # 1. "neuron" súlyai
    [0.1,  0.3, -0.4],  # 2. "neuron" súlyai
])
bemeneti_vektor = np.array([2020, 30000, 1])  # egy autó adatai
A mátrix-vektor szorzás eredménye:
kimenet = sulymatrix @ bemeneti_vektor  # a @ jel = mátrixszorzás
print(f"Bemeneti vektor: {bemeneti_vektor}")
print(f"Súlymátrix:\n{sulymatrix}")
print(f"Kimenet a szorzás után: {kimenet}")
print()
Ez most pontosan mi történt? Mi köze ehhez a 14. lecke nn.Linear(1, 16)-jának? A nn.Linear(bemenet_meret, kimenet_meret) pontosan ezt a mátrix-vektor szorzást végzi el belül (plusz egy "bias" tag hozzáadása, amit itt egyszerűség kedvéért elhagytunk) — minden egyes "neuron" a rétegben lényegében a súlymátrix egy sora, és a neuron kimenete nem más, mint a bemeneti vektor és a saját sora közötti "súlyozott összeg" (amit a mátrixszorzás elvégez az összes neuronra egyszerre, egy lépésben). Ezért mondjuk, hogy a neurális hálók lényegében "egymás utáni mátrixszorzások nemlineáris függvényekkel (ReLU — 14. lecke) közbeiktatva" — ez a teljes "neurális háló" misztikumának a magja, és most láttad, hogy valójában csak számtáblázatok szorzása.
Rész 3 — Valószínűség alapfogalmak: mit jelent, hogy a modell "84%-ban biztos"?
Emlékeztető a 21. lecke softmax/argmax fogalmára: a modell egy osztályozási feladatnál nem egyetlen választ ad, hanem valószínűségeket minden lehetséges osztályra — de mi egyáltalán a "valószínűség"?
A valószínűség egy szám 0 és 1 között (vagy 0-100% között), ami azt fejezi ki, "mennyire várható" egy esemény:
- 0 = Biztosan nem történik meg
- 1 (100%) = Biztosan megtörténik
- 0.5 (50%) = "Fele eséllyel" történik meg
Példa (emlékeztető a 21. lecke spam-szűrőjére):
spam_valoszinusegek = {
    "spam": 0.84,
    "nem spam": 0.16,
}
print("Egy email osztályozás eredménye:")
for kategoria, valoszinuseg in spam_valoszinusegek.items():
    print(f"  {kategoria}: {valoszinuseg*100:.0f}%")
print()
Miért adja össze mindig pontosan 100%-ot a két szám? Emlékeztető a 21. lecke softmax függvényére: ez nem véletlen — a softmax függvény matematikailag úgy van megkonstruálva, hogy az összes lehetséges kimenet valószínűsége mindig pontosan 1-re (100%-ra) összegződik — ez egy alapvető valószínűségi szabály: "valamelyik eseménynek biztosan be kell következnie a lehetséges események közül" (ha csak ez a két kategória létezik, akkor vagy spam, vagy nem spam — harmadik lehetőség nincs, ezért az összegnek 100%-nak kell lennie).
Rész 4 — Átlag és szórás: mit jelentenek pontosan? (emlékeztető a 20. és 22. lecke használatára, most alapoktól)
A 20. és 22. leckében már használtunk "szórást" és "standardizálást" — de sosem magyaráztuk el, mi pontosan a szórás. Pótoljuk.
pelda_adatok = np.array([45, 50, 52, 48, 200])
Példa: 5 ügyfél havi vásárlási összege (ezer forintban) — szándékosan tettünk bele egy "kilógó" értéket (200), hogy lássuk, hogyan hat az átlagra/szórásra.
Igen, a medián: ha az adatokat sorba rendezzük, ez a középső érték. Az átlagot egyetlen nagyon nagy vagy kicsi szám is jelentősen eltorzíthatja — mint fent a 200-as érték —, a mediánt viszont nem, ezért a kettőt gyakran érdemes együtt megnézni.
atlag = np.mean(pelda_adatok)
print(f"Adatok: {pelda_adatok}")
print(f"Átlag: {atlag:.1f}")
print()
Az átlag magában nem mond el mindent: két nagyon különböző adatsornak lehet ugyanaz az átlaga. Példa:
adatsor_a = np.array([50, 50, 50, 50, 50])       # mind egyforma
adatsor_b = np.array([10, 90, 30, 70, 50])       # nagyon szórt
print(f"A adatsor: {adatsor_a}, átlaga: {np.mean(adatsor_a):.1f}")
print(f"B adatsor: {adatsor_b}, átlaga: {np.mean(adatsor_b):.1f}")
print("(Ugyanaz az átlag, de teljesen más az adatok 'szóródása'!)")
print()szoras_a = np.std(adatsor_a)
szoras_b = np.std(adatsor_b)
print(f"A adatsor szórása: {szoras_a:.1f} <- kicsi, mert minden érték közel van az átlaghoz")
print(f"B adatsor szórása: {szoras_b:.1f} <- nagy, mert az értékek messze vannak az átlagtól")
print()Mit jelent pontosan, matematikailag, a szórás kiszámítása? A szórás kiszámításának lépései (ez az, amit np.std() belül elvégez): 1. Kiszámoljuk az átlagot 2. Minden egyes értéknél megnézzük, mennyire tér el az átlagtól (eltérés = érték - átlag) 3. Ezeket az eltéréseket négyzetre emeljük (hogy a negatív és pozitív eltérések ne "kioltsák" egymást összeadáskor) 4. Vesszük ezek átlagát (ez a "variancia") 5. Vesszük a négyzetgyökét (hogy visszatérjünk az eredeti mértékegységbe — hiszen a négyzetreemelés miatt a variancia más "egységben" van, mint az eredeti adat)
Nézzük meg ezt lépésről lépésre, kóddal, hogy ne csak elhiggyed, hanem lásd is:
lepes1_atlag = np.mean(adatsor_b)
lepes2_elteresek = adatsor_b - lepes1_atlag
lepes3_negyzetek = lepes2_elteresek ** 2
lepes4_variancia = np.mean(lepes3_negyzetek)
lepes5_szoras = np.sqrt(lepes4_variancia)
print("A szórás kiszámítása LÉPÉSRŐL LÉPÉSRE (B adatsor):")
print(f"  1. Átlag: {lepes1_atlag:.1f}")
print(f"  2. Eltérések az átlagtól: {lepes2_elteresek}")
print(f"  3. Eltérések négyzetre emelve: {lepes3_negyzetek}")
print(f"  4. Ezek átlaga (= variancia): {lepes4_variancia:.1f}")
print(f"  5. Négyzetgyök (= szórás): {lepes5_szoras:.1f}")
print(f"  (Ellenőrzés — np.std() eredménye: {np.std(adatsor_b):.1f} — EGYEZIK!)")
print()
Miért fontos ez a 20-22. lecke standardizálás műveletéhez? Emlékeztető a 22. leckére: a "standardizálás" (z-score) pontosan ezt az átlagot és szórást használja: (érték - átlag) / szórás — ez átalakítja az adatot úgy, hogy az átlaga 0, a szórása 1 legyen, függetlenül az eredeti mértékegységtől (forint, km, év, stb.) — ezért tudott a 22. lecke példája "összehasonlíthatóvá" tenni különböző skálájú oszlopokat (pl. "látogatók száma" [1-1000] vs. "oldalon töltött percek" [0-30]).
Rész 5 — A gradiens: mi a kapcsolat a deriválás (14c lecke) és a vektorok/mátrixok között?
Emlékeztető a 14c leckére: a deriválás "egy változós" függvényekre lett bevezetve (pl. x² deriváltja 2x). De egy valós neurális háló nem egy, hanem sok ezer/millió súlyváltozóval dolgozik egyszerre (emlékeztető rész 2-re: a súlymátrix sok számból áll) — ekkor a "deriváltat" már nem egyetlen számként, hanem vektorként kapjuk meg: ezt hívjuk gradiensnek.
A gradiens egyszerűen: "minden egyes súlyra külön-külön kiszámoljuk, hogy ha azt a súlyt kicsit megváltoztatnánk, hogyan változna a hiba (loss — emlékeztető a 14. lecke mseloss-ára)" — és ezeket az egyes deriváltakat egy vektorba gyűjtjük.
Egyszerűsített példa: 2 súlyunk van, és mindegyikre kiszámoltuk a deriváltat (ez a "gradiens vektor"):
gradiens = np.array([0.3, -0.1])
sulyok = np.array([0.5, 0.8])
tanulasi_rata = 0.1  # EMLÉKEZTETŐ a 15. LECKE `lr` PARAMÉTERÉRE!
uj_sulyok = sulyok - tanulasi_rata * gradiens
print(f"Régi súlyok: {sulyok}")
print(f"Gradiens (minden súlyra külön derivált): {gradiens}")
print(f"Új súlyok a frissítés után: {uj_sulyok}")
print()
Ez pontosan megegyezik a 14c lecke gradient descent képletével, csak több számra egyszerre alkalmazva? Igen — pontosan ez történik a optimizer.step() híváskor (14. lecke): a PyTorch kiszámolja a gradienst (vektorként, minden súlyra), majd minden egyes súlyt ugyanazzal a képlettel frissít, amit már a 14c leckében (egyetlen számra) láttál: új_érték = régi_érték - tanulási_ráta * derivált. A különbség csak annyi, hogy ezt nem egyetlen számra, hanem egyszerre sok ezer/millió súlyra végzi el — ezért kell a vektoros/mátrixos gondolkodás: enélkül egyenként kellene minden súlyt külön kiszámolni, ami lassú lenne — a mátrixműveletek (rész 2) teszik lehetővé, hogy ezt mind egyszerre, gyorsan (GPU-n párhuzamosan — 18. lecke) el lehessen végezni.
Ezt hívják "eltűnő gradiens" (vanishing gradient) problémának: ha a derivált értéke lépésről lépésre nagyon kicsi lesz, a súlyok gyakorlatilag leállnak a tanulásban. Ez az egyik ok, amiért a mély hálókban gyakran ReLU-szerű aktivációkat használnak a sima szigmoid helyett.
Összefoglaló táblázat — melyik matek-fogalom, hol jelenik meg
| Fogalom | Mit jelent gyakorlatban | Hol használtuk már |
|---|---|---|
| Vektor | Rendezett számlista (tulajdonságok) | 15. lecke (bemeneti adat), 17. lecke (embedding) |
| Mátrix | Számtáblázat (vektorok egymás alatt) | 14. lecke (nn.Linear súlyai) |
| Mátrixszorzás | Egy réteg "számítása" egy lépésben | 14. lecke (előrecsatolás) |
| Valószínűség | 0-1 közötti szám, "mennyire várható" | 21. lecke (softmax) |
| Átlag | Adatok "középértéke" | 20, 22. lecke |
| Szórás | Adatok "szóródásának" mértéke | 20, 22. lecke (standardizálás) |
| Gradiens | Sok deriváltból álló vektor | 14, 14c. lecke (tanítás) |
1. Hozz létre egy 4-dimenziós vektort, ami egy weboldalt ír le (pl. [betöltési_idő_mp, oldalak_száma, képek_száma, havi_látogatók]) — számold ki egy másik oldalhoz képest a "távolságot" (rész 1 mintájára).
2. Számold ki kézzel (papíron), majd ellenőrizd kóddal: mi a szórása az [10, 10, 10, 10] adatsornak? Miért pontosan 0? (gondold végig a rész 4 lépéseit!)
3. Módosítsd a rész 3 példáját három kategóriára (pl. "spam", "fontos", "hírlevél") — gondold végig, miért kell, hogy a három valószínűség összege most is pontosan 100% legyen.
4. Nézd át újra a 14. lecke neurális háló kódját — most, hogy tudod, mi történik mátrixszorzás szintjén egy nn.Linear() hívásban, próbáld meg saját szavakkal elmagyarázni (magadnak vagy egy barátodnak), mi történik, amikor egy adat végigmegy a háló rétegein.
Ez a lecke nem új AI-fogalmakat tanított, hanem a már használt fogalmak — vektor, mátrix, szórás, valószínűség és gradiens — matematikai hátterét adta meg. Innentől ezek nem „varázsszavak”, hanem valódi, kiszámolható és érthető fogalmak.