Új lapon nyílik meg

00c. lecke

Hibaelhárítási útmutató (gyakori hibaüzenetek)

1 rész0 kódpélda1 ábra
Miről szól ez a lecke?

Programozás közben mindenki kap hibaüzeneteket — ez a munka természetes része. Ez a lecke a kurzus során leggyakrabban előforduló hibákat gyűjti össze: mit jelent az üzenet, mi szokta okozni, és hogyan javítsd, valamint egy általános hibakeresési módszert is ad. Nem kell végigolvasni: akkor lapozz ide, amikor elakadsz.

Amit ebben a leckében megtanulsz
  • Általános hibakeresési módszertan (nem konkrét hiba, hanem általános…
Tudnivalók
  • Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
  • 1 rész · 0 kódpélda
  • A végén gyakorló feladatok ellenőrzik a tudásodat

Ez a lecke nem sorban olvasásra készült, hanem referenciának — amikor egy hibaüzenetet kapsz, ide jöjj vissza, keresd meg a hasonló hibát, és nézd meg, mi okozza és hogyan javítható.

SzéljegyzetMiért kell egyáltalán külön lecke a hibákról, miért nem elég, hogy megtanulom a helyes kódot?

Mert a gyakorlatban (ezt minden programozó megtapasztalja) a legtöbb időt nem az írás, hanem a hibakeresés (debugging) teszi ki — egy hibaüzenet első látásra ijesztőnek/érthetetlennek tűnhet, de a legtöbb gépi tanulási hiba visszavezethető néhány gyakori, ismétlődő okra — ha ezeket felismered, a hibakeresés percek, nem órák kérdése lesz.

Használat: a fájl futtatható — a keres_hibara() függvénnyel rákereshetsz egy hibaüzenet kulcsszavára.

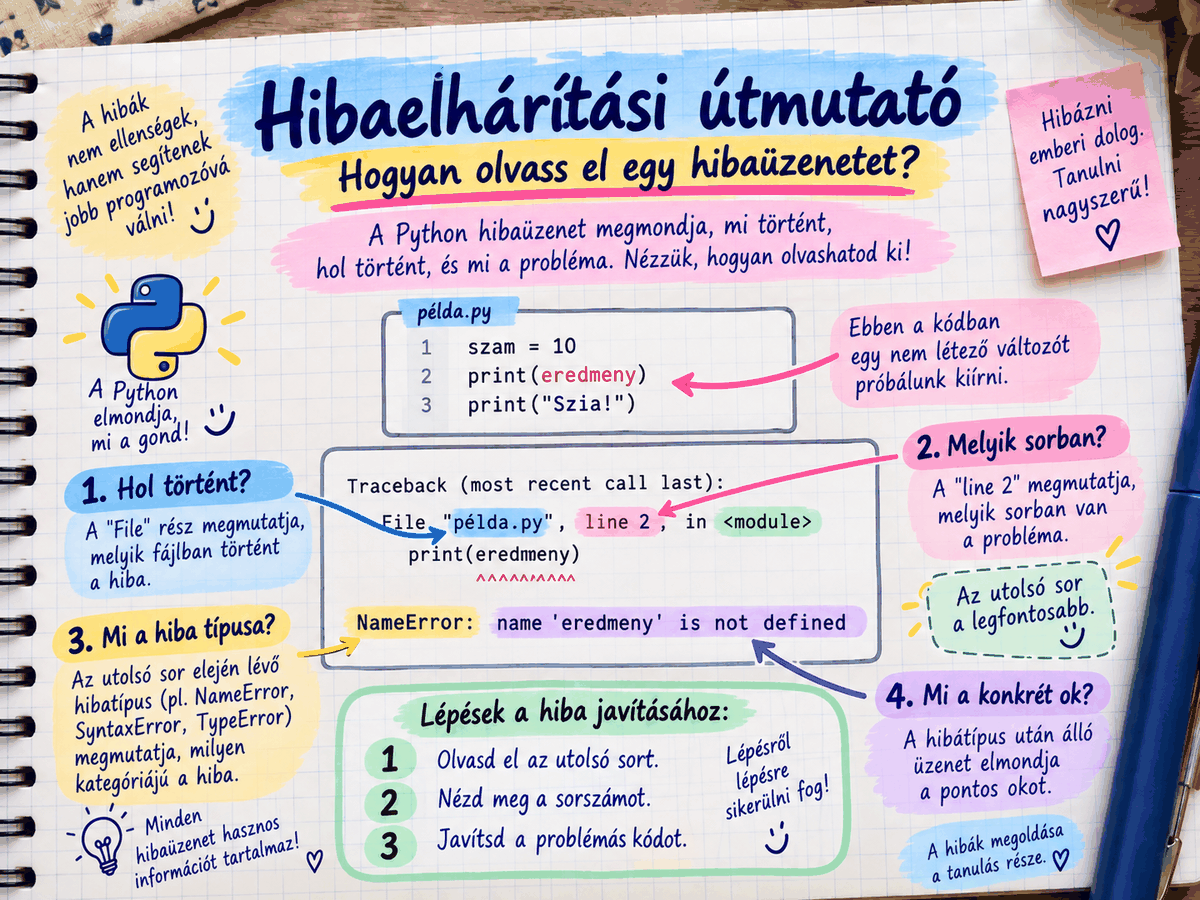
Egy Python hibaüzenet részei felcímkézve
Egy hibaüzenet nem ijesztő, ha tudod olvasni: alul mindig a hiba típusa és oka áll, fölötte pedig a fájl és a sor, ahol keresd.
Alak-eltérés (shape mismatch)

RuntimeError: mat1 and mat2 shapes cannot be multiplied

Miért történik?

A mátrixszorzáshoz (00b. lecke) a két mátrix 'belső' méretének egyeznie kell — pl. egy (10, 3) alakú bemenetet nem lehet egy olyan réteggel szorozni, ami (5, 16) bemenetre van felkészítve. Emlékeztető a 14. lecke `nn.Linear(bemenet, kimenet)` hívására: a 'bemenet' számnak pontosan egyeznie kell az előző réteg kimenetének méretével, vagy az adatod oszlopainak számával.

Mit tegyél?

Ellenőrizd a `.shape` attribútumot minden lépés után (`print(x.shape)`) — így pontosan látod, hol romlik el az alak. Leggyakoribb hiba: elfelejted, hogy az `nn.Linear(1, 16)` első száma a bemenet dimenziója kell legyen, nem a kimeneté (15. lecke).

GPU-memória hiány

RuntimeError: CUDA out of memory

Miért történik?

A GPU (18. lecke) memóriája véges — ha túl nagy batch-mérettel (14. lecke) vagy túl nagy modellel dolgozol, elfogy a hely.

Mit tegyél?

Csökkentsd a batch méretet (pl. 64-ről 16-ra). Ha CPU-n futtatsz (nincs GPU-d), ez a hiba nem jelenhet meg — ha mégis látod, ellenőrizd, hogy véletlenül nem próbálsz-e GPU-ra küldeni adatot `.to('cuda')`-val olyan gépen, aminek nincs is GPU-ja.

Instabil tanítás

Loss értéke NaN (Not a Number) lesz néhány epoch után

Miért történik?

Emlékeztető a 15. lecke tanulságára: túl nagy tanulási ráta (`lr`) esetén a súlyok frissítése 'túllövi' a célt, és a számok egyre nagyobbak/kisebbek lesznek, míg végül 'elszabadulnak' — ez adja a NaN-t. Emlékeztető a 22. leckére is: standardizálás/normalizálás nélküli, nagyon eltérő skálájú bemeneti adat is okozhatja.

Mit tegyél?

Csökkentsd a tanulási rátát (pl. 0.01-ről 0.0001-re — lásd 15. lecke Széljegyzetét erről). Ellenőrizd, hogy az adatod standardizálva/normalizálva van-e (22. lecke). Ellenőrizd, nincs-e osztás nullával valahol a saját kódodban.

A modell nem tanul

Loss értéke egyáltalán nem csökken (stagnál)

Miért történik?

Több lehetséges ok: (1) a tanulási ráta túl kicsi (a súlyok alig változnak epoch-onként); (2) elfelejtetted meghívni az `optimizer.zero_grad()`-ot a ciklus elején (14. lecke) — így a gradiensek felhalmozódnak, rossz irányba mutatnak; (3) az adatban nincs valódi mintázat, amit a modell megtanulhatna.

Mit tegyél?

Ellenőrizd a tanítási ciklus sorrendjét (14. lecke): `zero_grad()` -> `forward` (előrecsatolás) -> `loss` számítás -> `backward()` -> `optimizer.step()` — ha ez a sorrend felcserélődik vagy kimarad belőle valami, a tanítás nem fog működni.

Hiányzó csomag

ModuleNotFoundError: No module named 'torch' (vagy más csomag)

Miért történik?

A Python csomag, amit importálni próbálsz, nincs telepítve abban a környezetben, amiben futtatod a kódot.

Mit tegyél?

Telepítsd a hiányzó csomagot: `pip install torch` (vagy amelyik csomag hiányzik). Ha többféle Python-környezeted van a gépeden (pl. virtuális környezetek — lásd 00d. lecke), ellenőrizd, hogy abban a környezetben telepítetted-e, amiben futtatod a kódot.

Hibás oszlopnév

KeyError: 'oszlopnev' (pandas DataFrame-nél)

Miért történik?

Olyan oszlopra hivatkozol (`adatok['oszlopnev']` — 15. lecke), ami nem létezik a DataFrame-ben — gyakran elgépelés, vagy eltérő nagy/kisbetű, vagy szóköz az oszlopnévben.

Mit tegyél?

Írasd ki a valós oszlopneveket: `print(adatok.columns)` — és hasonlítsd össze azzal, amit a kódban használsz. Gyakori hiba: `'Latogatok'` vs. `'latogatok'` (a Python megkülönbözteti a kis- és nagybetűket!).

Dimenzió-hiba (scikit-learn/NumPy)

ValueError: Expected 2D array, got 1D array instead

Miért történik?

Sok scikit-learn/PyTorch függvény két dimenziós bemenetet vár (sorok x oszlopok — 00b. lecke), de egy dimenziós tömböt (csak egy sima listát) adtál át.

Mit tegyél?

Alakítsd át `.reshape(-1, 1)`-gyel, ha egyetlen oszlopod van (emlékeztető a 15. lecke `adatok[["latogatok"]]` dupla szögletes zárójelére — ez pontosan ezt a problémát kerüli el előre: a dupla zárójel garantálja, hogy DataFrame [2D], ne Series [1D] jöjjön ki).

Behúzási hiba

IndentationError / SyntaxError, de a kód 'jónak tűnik'

Miért történik?

Python-ban a behúzás (indentálás — szóközök/tabok a sor elején) nem csak esztétikai, hanem a nyelv része — egy rosszul behúzott sor hibát okoz, még akkor is, ha 'kinézetre' rendben van.

Mit tegyél?

Soha ne keverd a szóközöket és a tab-okat ugyanabban a fájlban — válassz egyet (a Python-közösség a 4 szóközt javasolja), és maradj következetes. A legtöbb kódszerkesztő (VS Code) ezt automatikusan kezeli, ha helyesen van beállítva.

'Halott' vagy alultanult modell

A modell mindig ugyanazt (vagy nagyon hasonló) választ adja

Miért történik?

Emlékeztető a 20. leckére: ez underfitting jele lehet — a modell túl egyszerű (túl kevés réteg/neuron), vagy nem tanult eleget (túl kevés epoch), vagy minden ReLU-neuron 'kiesett' ('dying ReLU' — negatív bemenet miatt mindig 0-t ad vissza, és onnantól sosem frissül).

Mit tegyél?

Növeld a modell méretét vagy az epoch-ok számát. Ellenőrizd az adatod szórását (00b. lecke) — ha minden bemenet szinte ugyanaz, a modell sem tud változatosat jósolni.

Elérési út (path) hiba

FileNotFoundError egy .csv vagy más adatfájl betöltésekor

Miért történik?

A fájl, amit be akarsz olvasni (pl. `pd.read_csv(...)` — 15. lecke) nincs ott, ahol a kód keresi — vagy mert máshol van elmentve, vagy mert relatív útvonalat használsz egy másik munkakönyvtárból futtatva.

Mit tegyél?

Ellenőrizd az aktuális munkakönyvtárat (`import os; print(os.getcwd())`), és hogy a fájl tényleg ott van-e (`os.path.exists('fajlnev.csv')`). Amikor bizonytalan vagy, használj teljes (abszolút) elérési utat relatív helyett.

Általános hibakeresési módszertan (nem konkrét hiba, hanem általános gondolkodásmód)

Ha egy hibát kapsz, ami nincs a fenti listában, ez a lépéssor segít:

1. Olvasd el a hibaüzenet utolsó sorát — ez tartalmazza a lényeget (pl. "ValueError: ...") — a felette lévő sorok (a "traceback") megmutatják, pontosan melyik sorban történt a hiba.

SzéljegyzetMiért érdemes a tracebacket alulról felfelé olvasni?

Mert a lista alja mutatja, hol állt meg ténylegesen a program — a hiba típusát és okát —, míg felfelé haladva látod, milyen függvényhívásokon keresztül jutott el odáig. Kezdőként elég csak az utolsó pár sorra fókuszálni, a többi csak a "hívási lánc" részletei.

2. Menj el a jelzett sorhoz, és írasd ki (print()) az ott szereplő változók értékét/alakját (.shape, type()) — gyakran azonnal láthatóvá válik, mi nem egyezik az elvárttal.

3. Keresd ki a hibaüzenet lényegi részét (ne a teljes szöveget, csak a hiba típusát és a legfontosabb szavakat) ebben a leckében, vagy webes kereséssel.

SzéljegyzetÉrdemes a teljes hibaüzenetet bemásolni egy keresőbe?

Inkább csak a lényegi részt érdemes keresni: a hiba típusát és a legfontosabb, egyedi szavakat. A fájlneveket, sorszámokat és a saját változóneveidet hagyd ki, mert azok csak a te kódodra jellemzőek, azokra úgysem fogsz találatot kapni.

4. Ha még mindig nem világos, próbáld meg leegyszerűsíteni a problémát: hozz létre egy nagyon kicsi, minimális példát, ami csak azt az egy lépést tartalmazza, ahol a hiba történik — ha a kicsi példa működik, lépésről lépésre add hozzá a többit, amíg meg nem találod, melyik rész töri el.

SzéljegyzetEz a módszertan csak az AI/gépi tanulás kódjára vonatkozik?

Nem — ez általános programozási hibakeresési módszer, ami bármilyen program hibájánál működik (előbb „behatárolod" a problémát, aztán lépésenként szűkíted) — ez a lecke ezt egészíti ki a gépi tanulásra jellemző, specifikus hibatípusokkal.

Gyakorlás

1. Futtasd a keres_hibara() függvényt "nan", "memory" és "path" kulcsszavakkal.

2. Menj vissza a 15. lecke projektkódjához, és szándékosan ronts el valamit (pl. állítsd a tanulási rátát 10-re, vagy változtasd meg egy nn.Linear() bemeneti méretét) — futtasd le, nézd meg a hibaüzenetet, és próbáld meg ebből a leckéből azonosítani, mi történt — ez a legjobb módja annak, hogy megtanuld felismerni ezeket a hibákat élesben is.

3. Új gyakorlat: amikor legközelebb valós hibába ütközöl (bármely saját projektben), írd be ide, ebbe a listába, saját szavaiddal — így idővel saját, személyes hibaelhárítási kézikönyvedet építed fel, ami pontosan a te leggyakoribb hibáidra szabott lesz.

Használati tipp

Ez a lecke referenciaanyag: térj vissza hozzá, amikor egy hibaüzenetbe ütközöl. Nem szükséges sorban elolvasni.

Gyors keresés

Használd a böngésző keresőjét (Ctrl+F), és írj be egy részletet a hibaüzenetből — például shape, CUDA vagy NameError.