10. lecke
NumPy alapok
A gépi tanulás lényegében rengeteg számolás hatalmas számtömbökön — erre a Python sima listája lassú és kényelmetlen. A NumPy könyvtár pontosan erre készült: egész tömbökön egyszerre, gyorsan végez műveleteket. Ebben a leckében megtanulod, hogyan hozz létre NumPy-tömböt, hogyan számolj vele egyszerre, hogyan kezelj többdimenziós tömböket (mátrixokat), melyek a leghasznosabb függvények, és hogyan válassz ki részeket indexeléssel és szeleteléssel. Ez az alapja minden későbbi modellnek.
- Miért kell NumPy, ha már van listánk?
- NumPy tömb (array) létrehozása
- A nagy különbség: műveletek az egész tömbön egyszerre
- Többdimenziós tömbök — mátrixok
- Hasznos NumPy függvények
- Gyors tömblétrehozó függvények
- Indexelés és szeletelés (slicing)
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 7 rész · 17 kódpélda
- Előfeltétel: pip install NumPy
- A végén gyakorló feladatok ellenőrzik a tudásodat
Előfeltétel: pip install NumPy
import numpy as np
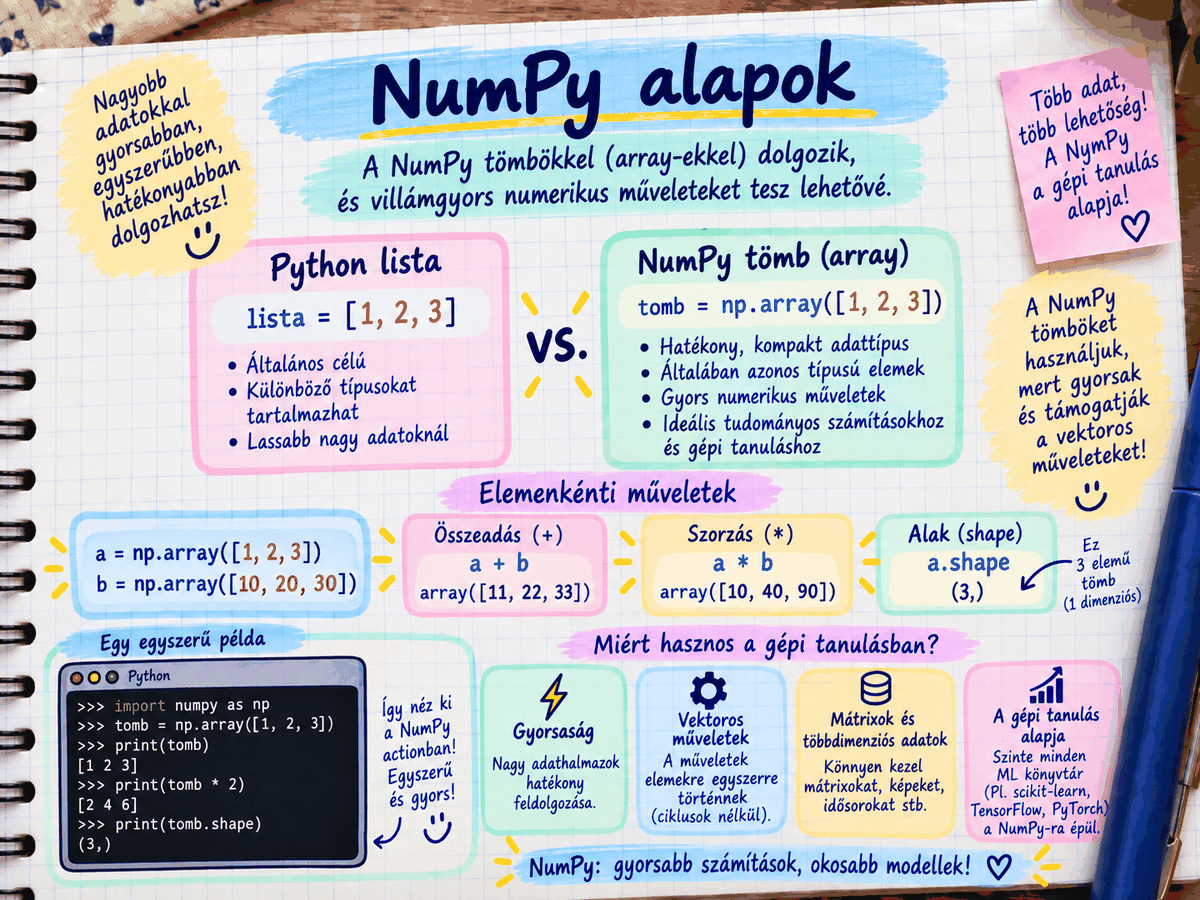
1. Miért kell NumPy, ha már van listánk?
Mi ez valójában? A NumPy nem egy "leegyszerűsített Python" — pont fordítva: specializáltabb és gyorsabb a sima Pythonnál, konkrétan számokra. A motorháztető alatt C nyelven van megírva (ami sokkal gyorsabb, mint a sima Python), és másképp tárolja a memóriában a számokat, mint egy lista.
Miért pont a memóriatárolás a különbség oka — mit csinál másképp a NumPy? Egy Python lista belsőleg nem közvetlenül a számokat tárolja egymás mellett a memóriában — helyette minden egyes elemhez egy külön "dobozt" (objektumot) hoz létre, ami tartalmazza a számot, plusz extra információt is (típus, méret, stb.), és ezek a dobozok szétszórtan helyezkedhetnek el a memóriában, csak "mutatókkal" (hivatkozásokkal) összekötve. A NumPy tömb ezzel szemben a számokat közvetlenül, egymás mellett, tömörítve tárolja a memóriában, egyforma típusúként — ez azt jelenti, hogy a processzor sokkal gyorsabban tud hozzáférni és számolni velük, mert nem kell "ugrálnia" szétszórt memóriahelyek között, és nem kell minden egyes elemnél újra "kicsomagolni" extra információt.
Hasonlat: a sima Python lista olyan, mint egy fiók, amibe vegyesen bármit bedobálhatsz — minden belefér, de keresgélni kell benne. A NumPy tömb olyan, mint egy tojástartó: csak egyféle dolgot tart, szorosan egymás mellett, fix helyeken — ezért egy mozdulattal végig lehet menni rajta. Ugyanaz a tartalom, de nagy mennyiségnél sokkal hatékonyabb.
2. NumPy tömb (array) létrehozása
lista = [1, 2, 3, 4, 5]
tomb = np.array(lista)
print(tomb)          # [1 2 3 4 5]
print(type(tomb))    # <class 'numpy.ndarray'>
Mit csinál pontosan az np.array(), és mit jelent az 'ndarray' szó? Az np.array() egy függvény, ami megvizsgálja a bemenetét (itt a "lista" nevű Python listát), és létrehoz belőle egy új, NumPy-specifikus adatszerkezetet — átmásolja az adatokat az új, tömörített memória-elrendezésbe. Az "ndarray" rövidítés jelentése: "n-dimensional array", azaz "N-dimenziós tömb" — ez utal arra, hogy a NumPy tömbök nem csak egyszerű, egysoros listákat kezelhetnek, hanem tetszőleges dimenziójú (1D, 2D, 3D, stb.) adatszerkezeteket is, amit lentebb (a mátrixoknál) fogunk is látni.
Igen — minden NumPy-tömbnek van egy "dtype" nevű tulajdonsága, ami megmondja, milyen típusú számokat tárol (pl. int64, float32). Egy tömb minden eleme ugyanabból a típusból van, ez teszi lehetővé a tömör tárolást. Gépi tanulásban gyakran float32-t használnak float64 helyett, mert feleannyi memóriát foglal, és a legtöbb modell erre van optimalizálva.
3. A nagy különbség: műveletek az egész tömbön egyszerre
lista = [1, 2, 3, 4, 5]
tomb = np.array(lista)
eredmeny = tomb * 2
print(eredmeny)   # [2 4 6 8 10]
print(tomb + 10) # [11 12 13 14 15]
print(lista * 2) # ez megduplázza a listát, nem az elemeket!
Miért csinál a lista * 2 valami teljesen mást, mint a tomb * 2 — hogyan lehetséges ez, ha mindkettő 'szorzás'? Ez egy kiváló példa arra, hogy a Python-ban (és sok más nyelvben is) ugyanaz a jel (*) különböző viselkedést eredményezhet, attól függően, milyen típusú dolgokra alkalmazzuk (ezt "operátor túlterhelésnek", operator overloading-nak hívják a szakmában). A sima listánál a * operátor ismétlést jelent — [1,2,3] * 2 az [1,2,3,1,2,3]-at ad, azaz kétszer egymás után illeszti a listát. A NumPy tömbnél viszont a NumPy külön megdefiniálta, hogy a * jel itt matematikai értelemben vett "szorzást" jelentsen, minden egyes elemre alkalmazva külön-külön. Ez a "vektorizált művelet" — a NumPy a háttérben, gyors, C nyelvű kóddal végigmegy minden elemen, és mindegyiket megszorozza, de neked ezt egyáltalán nem kell ciklussal leírnod, csak leírod a "tomb * 2"-t, és a NumPy elvégzi ezt a "rejtett ciklust" helyetted, sokkal gyorsabban, mintha te írtál volna egy sima Python for ciklust.
A tomb + 10 példában a NumPy egyetlen számot (10) szétterít a tömb minden elemére — ezt hívják broadcastingnak. Ugyanígy működik két különböző alakú tömb között is, amíg a méreteik összeegyeztethetők. Ez az egyik leghasznosabb, de kezdőknél sokszor hibát is okozó NumPy-fogalom: ha két tömb alakja nem illeszthető össze, a NumPy hibaüzenetet dob összeadáskor.
4. Többdimenziós tömbök — mátrixok
A mátrix egyszerűen egy táblázat számokból, sorokba és oszlopokba rendezve — semmi bonyolult matematikai varázslat nincs benne. Pont olyan, mint egy Excel-táblázat egy szelete, vagy egy adatbázis-tábla egy része.
A fokozatok: szám (skalár) -> 5 (0 irány) lista / 1D tömb -> [1, 2, 3] (1 irány: csak sor) mátrix / 2D tömb -> [[1,2,3],[4,5,6]] (2 irány: sor + oszlop) tenzor / 3D+ tömb -> pl. egy kép (magasság × szélesség × szín)
A "tenzor" (amit majd PyTorch-ban használunk) csak ennek a mátrix-gondolatnak a kiterjesztése több dimencióra.
matrix = np.array([
    [1, 2, 3],
    [4, 5, 6]
])print(matrix) print(matrix.shape) # (2, 3) — 2 sor, 3 oszlop
Mit csinál pontosan a .shape, hogyan 'tudja' a NumPy, hogy ez 2 sor és 3 oszlop, ha én csak szögletes zárójeleket írtam? Amikor az np.array()-nek egy listák listáját adod meg (itt: egy listát, amiben két belső lista van, mindegyikben három szám), a NumPy megszámolja: hány külső elem van (ez lesz a sorok száma: 2), és minden külső elemen belül hány belső elem van (ez lesz az oszlopok száma: 3). A .shape egy tulajdonság (nem függvény, ezért nincs utána zárójel!), ami ezt a már kiszámolt, eltárolt információt adja vissza — a NumPy ezt azonnal, a tömb létrehozásakor kiszámolja és elmenti, hogy bármikor gyorsan visszakérdezhesd, anélkül, hogy újra végig kellene számolnia minden alkalommal.
5. Hasznos NumPy függvények
szamok = np.array([4, 8, 15, 16, 23, 42])
print(np.mean(szamok))    # átlag
print(np.max(szamok))     # legnagyobb elem
print(np.min(szamok))     # legkisebb elem
print(np.sum(szamok))     # összeg
print(np.sort(szamok))    # rendezett sorrendben
Kis adatnál (mint ez a 6 elemű tömb) valóban alig van gyakorlati különbség. De amikor majd valós AI-adatokkal dolgozol — akár százezer vagy millió elemmel —, a NumPy belső, optimalizált (C nyelven írt) megvalósítása nagyságrendekkel gyorsabban végzi el ugyanezt a számítást, mint egy sima Python ciklus. Ráadásul a NumPy függvényei egységes, következetes módon működnek többdimenziós (mátrix) adatokon is — pl. np.mean(matrix) az egész mátrix átlagát adja, míg egy sima Python listánál ehhez saját, beágyazott ciklusokat kellene írnod.
6. Gyors tömblétrehozó függvények
nullak = np.zeros(5)          # 5 darab 0.0 -ból álló tömb
print(nullak)                 # [0. 0. 0. 0. 0.]
egyesek = np.ones(3)          # 3 darab 1.0
print(egyesek)                # [1. 1. 1.]
sorozat = np.arange(0, 10, 2) # 0-tól 10-ig, 2-es lépésközzel
print(sorozat)                # [0 2 4 6 8]
Ez elsőre furcsának tűnhet, de AI/gépi tanulásban rendkívül gyakran van szükség rá: amikor egy modellt elkezdesz építeni (pl. majd PyTorch-nál egy neurális hálót), gyakran "üres" (nulla vagy véletlenszerű) értékekkel kell kezdened, amiket a tanítás folyamata fokozatosan tölt ki értelmes értékekkel (ezt majd a 12. leckében, a "meredekség és kezdőpont" fogalmánál is látni fogod — azok is "valahonnan" kezdődnek majd, mielőtt a tanítás finomítja őket). A np.zeros() és np.ones() gyors, kényelmes módot ad ilyen "kezdő állapotú" tömbök létrehozására, anélkül, hogy neked kézzel kellene kiírnod mind az 5 (vagy akár millió) nullát.
A gyakorlatban a neurális hálók súlyait szinte sosem np.zeros()-szal indítják — ha minden súly egyforma (pl. mind 0), a háló minden neuronja ugyanazt tanulná meg, és a tanítás nem tudna köztük különbséget tenni. Ezért kis véletlen számokkal (pl. np.random.randn()) szokás indítani a súlyokat.
7. Indexelés és szeletelés (slicing)
tomb = np.array([10, 20, 30, 40, 50])
print(tomb[0])       # 10 — első elem
print(tomb[-1])      # 50 — utolsó elem
print(tomb[1:3])     # [20 30] — 1-es és 2-es index közötti rész
matrix = np.array([
    [1, 2, 3],
    [4, 5, 6]
])print(matrix[0]) # [1 2 3] — az első SOR print(matrix[0][1]) # 2 — az első sor, második eleme print(matrix[:, 0]) # [1 4] — az ELSŐ OSZLOP minden sorból
Mit jelent pontosan a ':' jel a matrix[:, 0]-nál — ez valami új szintaxis? Igen, ez egy NumPy-specifikus, rendkívül hasznos jelölés! A ":" (kettőspont) önmagában azt jelenti: "az összes elemet ebben az irányban", tehát a matrix[:, 0] azt mondja: "az összes sorból (: az első helyen) vedd a 0. Oszlopot (a 0 a második helyen)." Ez teszi lehetővé, hogy egyetlen, tömör sorral ki tudj választani egy teljes oszlopot egy mátrixból, anélkül, hogy ciklussal kellene végigmenned minden során, és minden sorból kézzel kivenned az adott pozíciót. Ez azért kritikus az AI-adatoknál, mert (emlékezz a Pandas-ra a 11. leckéből) egy oszlop gyakran egy konkrét tulajdonságot jelent (pl. "minden autó ára"), amit gyakran egyben, egyetlen műveletként akarsz kezelni.
- Hozz létre egy NumPy tömböt 1-től 10-ig terjedő számokból (np.arange használatával), majd írasd ki az átlagukat (np.mean).
- Hozz létre egy 3x3-as mátrixot (bármilyen számokkal), és írasd ki csak a középső sorát.
- Készíts egy tömböt hőmérsékleti adatokból, majd írasd ki: mi volt a legmelegebb nap, a leghidegebb nap, és az átlag hőmérséklet.
- Új gyakorlat: hozz létre egy sima Python listát 5 elemmel, és próbáld meg rajta elvégezni ugyanazt, amit a tomb * 2 csinált (tehát minden elemet megduplázni) — de csak ciklussal (for), NumPy nélkül. Hasonlítsd össze, mennyi kódot kellett írnod ehhez képest a NumPy-os "tomb * 2" egysoros megoldásához — ez segít átérezni a NumPy kényelmét és tömörségét a gyakorlatban.
Források és további olvasnivaló
A lecke témájának hivatalos dokumentációi és alapvető cikkei:
• NumPy — kezdő útmutató — numpy.org