11. lecke
Pandas: táblázatos adatok kezelése
A valós adatok többnyire táblázatokban érkeznek: sorokkal és oszlopokkal, mint egy Excel-tábla. A Pandas könyvtár ezek kezelésére készült. Ebben a leckében megismered a DataFrame-et, beolvasol egy CSV-fájlt, oszlopokat választasz ki, alapvető elemzést végzel, szűrsz, új oszlopot hozol létre, rendezel, és kezeled a hiányzó adatokat — vagyis mindazt, amit egy modell tanítása előtt az adatokkal tenni kell.
- Mi az a DataFrame?
- CSV fájl beolvasása — read_csv()
- Oszlopok elérése
- Alapvető elemzés
- Szűrés — csak bizonyos sorok kiválasztása
- Új oszlop létrehozása
- Rendezés
- Hiányzó adatok kezelése
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 8 rész · 21 kódpélda
- Előfeltétel: pip install pandas
- A végén gyakorló feladatok ellenőrzik a tudásodat
Előfeltétel: pip install pandas
import pandas as pd
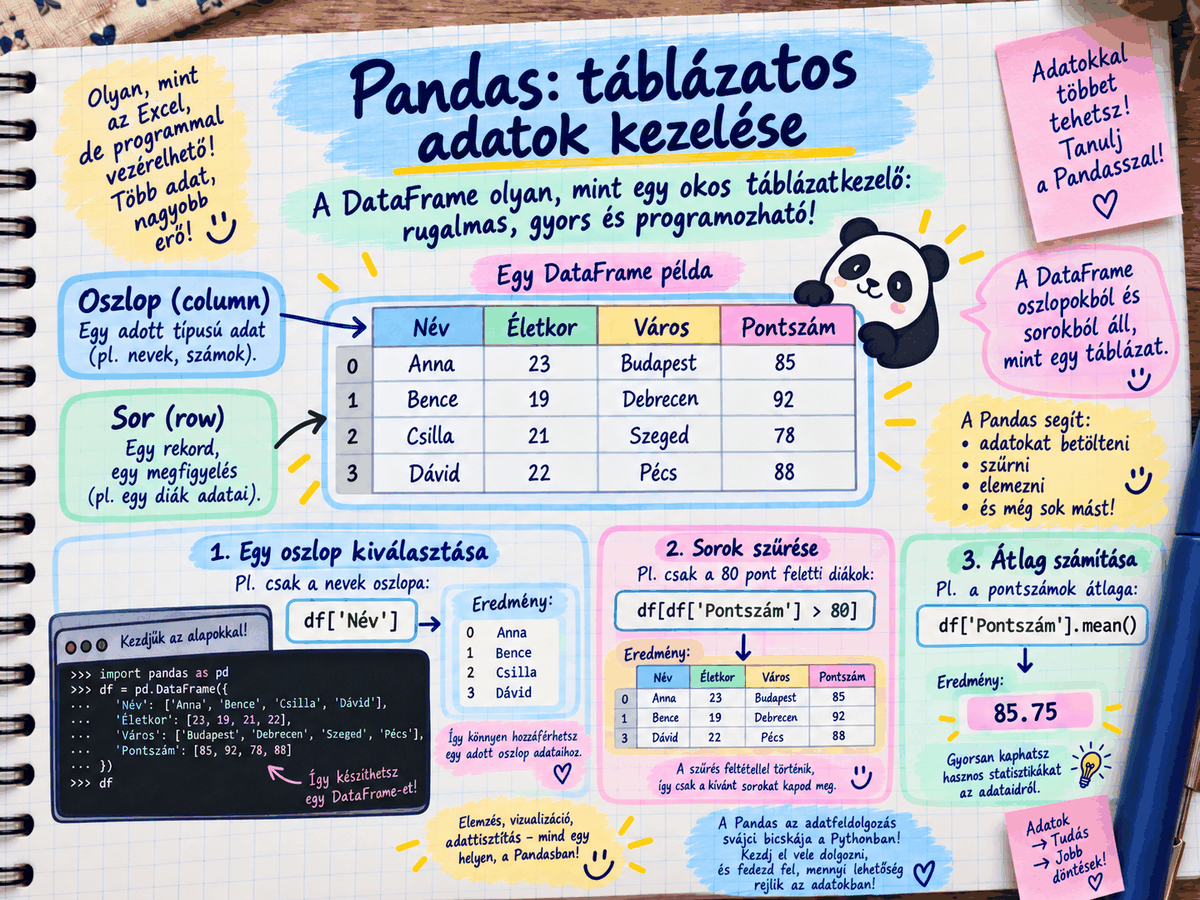
1. Mi az a DataFrame?
Mi ez valójában? Ha a NumPy a "nyers számokra" optimalizált eszköz, a Pandas ehhez ad egy kényelmes réteget, ami már nevesített oszlopokkal és sorokkal dolgozik — pont úgy, mint egy Excel tábla vagy egy adatbázis-tábla. A NumPy tömbben csak számok vannak, index alapján éred el őket (matrix[0][1]) — a Pandas táblában viszont oszlopnév alapján (tabla["kor"]), ami sokkal olvashatóbb és kevésbé hibalehetőséges valós adatoknál.
Ha a Pandas 'a NumPy-ra épül', ez mit jelent technikailag? Ez azt jelenti, hogy a Pandas belsőleg valójában NumPy tömböket használ a számok tárolására és a gyors számításokhoz — a Pandas hozzáad egy "címkéző réteget" (az oszlopneveket és a sorindexeket) erre a NumPy-alapra. Ez azt jelenti, hogy minden gyorsasági előny, amit a NumPy- nál tanultál (gyors, tömbön egyszerre végzett műveletek), a Pandas-ban is megvan, csak "kényelmesebb csomagolásban" — nem kell lemondanod a sebességről a kényelemért cserébe.
Ha egy modellnek (pl. scikit-learn-nek) tiszta számtömb kell, a df.to_numpy() paranccsal egyetlen sorban NumPy-tömbbé alakíthatod a DataFrame-et. Ezt a lépést a legtöbb valós gépi tanulási projektben megteszed, mielőtt a modellt tanítod.
adatok = {
    "nev": ["Anna", "Béla", "Csilla"],
    "kor": [25, 30, 22],
    "varos": ["Budapest", "Veszprém", "Szeged"]
}df = pd.DataFrame(adatok) print(df)
Miért szótárból (dictionary) hozzuk létre a DataFrame-et — emlékezz a 6. leckére, mi ennek az oka? Emlékezz a 6. lecke "lista szótárakkal" mintájára — ott minden egyes szótár egy-egy sort (pl. egy embert) jelentett. Itt a Pandas egy másik, ugyancsak gyakori mintát használ: a szótár kulcsai lesznek az oszlopnevek ("nev", "kor", "varos"), és minden kulcshoz tartozó lista adja meg az adott oszlop értékeit, soronként. A Pandas "tudja", hogy ha három kulcs van, három oszlopot csinál, és a listák hosszából (itt: 3 elem mindegyikben) megállapítja, hány sora lesz a táblázatnak.
2. CSV fájl beolvasása — read_csv()
df.to_csv("szemelyek.csv", index=False)beolvasott_df = pd.read_csv("szemelyek.csv")
print(beolvasott_df)Mit csinál pontosan az index=False, mi történne nélküle? Amikor egy Pandas DataFrame-et létrehozol, a Pandas automatikusan ad hozzá egy "rejtett" sorazonosítót (index) minden sorhoz (0, 1, 2, ...) — ezt eddig nem láttad kiírva, de mindig ott van a háttérben. Ha az index=False nélkül mentenéd el CSV-be, a Pandas ezt a belső sorazonosítót is beleírná egy külön oszlopként a fájlba, ami legtöbbször felesleges, zavaró információ (mert amikor visszaolvasod, a Pandas úgyis ad új, saját sorazonosítót). Az index=False egyszerűen kihagyja ezt a fölösleges oszlopot a mentett fájlból, tisztább CSV-t eredményezve.
Emlékezz a 8. leckére, ahol kézzel kellett .split(",")-t hívni minden sorra, és magadnak kellett kezelned a szövegből-számmá alakítást. A Pandas read_csv() mindezt automatikusan elvégzi: felismeri az oszlopneveket az első sorból, kitalálja, mely oszlopok számok és melyek szövegek (nem kell kézzel int()-elned!), és rendezett, kényelmes DataFrame-mé alakítja az egészet, egyetlen függvényhívással. Ez pontosan az a "kényelmi réteg", amiről az 1. rész széljegyzetében volt szó.
3. Oszlopok elérése
df = pd.DataFrame({
    "nev": ["Anna", "Béla", "Csilla"],
    "kor": [25, 30, 22],
    "varos": ["Budapest", "Veszprém", "Szeged"]
})print(df["nev"]) print(df["kor"])
print(df[["nev", "kor"]])
Miért kell dupla szögletes zárójel a df[['nev', 'kor']]-nál, egyszerű pedig a df['nev']-nél? Ez egy fontos, gyakran elrontott részlet: a df["nev"] egyetlen oszlopot kér le (egy karaktersorozatot, a nevet, egyszerű szövegként megadva). Ha több oszlopot szeretnél egyszerre, azokat egy listába kell foglalnod — ["nev", "kor"] maga egy lista két szöveggel —, és ezt a listát adod át a df[...] szögletes zárójelnek. Ez az oka, hogy kétszer látod a szögletes zárójelet: a külső a "válassz ki oszlop(oka)t" utasítás, a belső pedig maga a lista, ami megmondja, melyeket.
Ha a táblázat több ezer sorból áll, a print(df) helyett érdemesebb a df.head()-et használni, ami alapból csak az első 5 sort mutatja. A df.tail() hasonlóan az utolsó sorokat adja vissza — ezekkel gyorsan rá tudsz nézni az adatra anélkül, hogy több ezer sort kiírnál a képernyőre.
4. Alapvető elemzés
df = pd.DataFrame({
    "nev": ["Anna", "Béla", "Csilla", "Dénes"],
    "kor": [25, 30, 22, 40]
})print(df["kor"].mean()) print(df["kor"].max()) print(df["kor"].min()) print(df.describe())
Miért df['kor'].mean() és nem pl. pd.mean(df['kor'])? Ez a Python (és sok más nyelv) egyik alapvető fogalmához kapcsolódik: az objektum-orientált gondolkodáshoz. A df["kor"] "kivesz" egy oszlopot a táblázatból, ami maga is egy önálló, saját képességekkel rendelkező dolog (a szakmában "Series"-nek hívják) — és ennek az oszlopnak vannak saját, "beépített" metódusai (mint a .mean(), amiket a "pont" utáni résszel hívsz meg, hasonlóan, ahogy a 6. leckében a listák .append() metódusát is így hívtad). Ez azt az elvet tükrözi, hogy "az oszlop maga tudja, hogyan kell kiszámolni a saját átlagát" — nem egy külső függvénynek kell "megmondanod", mit csináljon vele.
5. Szűrés — csak bizonyos sorok kiválasztása
df = pd.DataFrame({
    "nev": ["Anna", "Béla", "Csilla", "Dénes"],
    "kor": [25, 30, 22, 40]
})idosebbek = df[df["kor"] > 25] print(idosebbek)
Ez elsőre furcsán néz ki — mi történik pontosan a df[df['kor'] > 25]-nél, kétszer szerepel a df? Ez az egyik legkifinomultabb, de leggyakrabban használt Pandas-trükk, érdemes lépésről lépésre megérteni: először a Python kiszámolja a belső részt: df["kor"] > 25 — ez nem egyetlen True/False értéket ad (mint a 4. leckében egy sima számnál), hanem egy egész oszlopnyi True/False értéket, minden sorra külön-külön megvizsgálva (pl. [False, True, False, True], ha az első és harmadik személy 25 vagy fiatalabb). Ezután ezt a True/False listát ("maszknak" hívják a szakmában) behelyettesíti a külső df[...] zárójelbe — a Pandas ezt úgy értelmezi: "tartsd meg azokat a sorokat, ahol True szerepel, dobd el, ahol False." Ez a "maszkolásos szűrés" azért annyira hatékony, mert egyetlen sorban, ciklus írása nélkül tudsz végigszűrni akár milliónyi sort is.
6. Új oszlop létrehozása
df = pd.DataFrame({
    "nev": ["Anna", "Béla", "Csilla"],
    "kor": [25, 30, 22]
})df["kor_10_ev_mulva"] = df["kor"] + 10 print(df)
Honnan tudja a Pandas, hogy ez egy új oszlopot hoz létre, nem egy meglévőt módosít (emlékezz a 6. leckére, hasonló elv volt a szótáraknál is)? Pontosan ugyanaz a logika érvényesül itt is, mint a 6. leckében a szótáraknál: a Pandas megnézi, létezik-e már a "kor_10_ev_mulva" nevű oszlop. Mivel nem létezik még, létrehoz egy vadonatújat, és a df["kor"] + 10 számítás eredményét (ami egy teljes, új oszlopnyi érték, mert a NumPy-hoz hasonlóan a Pandas is "vektorizáltan", minden sorra egyszerre végzi el az összeadást) tölti bele.
7. Rendezés
df = pd.DataFrame({
    "nev": ["Anna", "Béla", "Csilla"],
    "kor": [25, 30, 22]
})rendezett = df.sort_values("kor")
print(rendezett)rendezett_csokkeno = df.sort_values("kor", ascending=False)
print(rendezett_csokkeno)Az "ascending" angolul "növekvő"-t jelent — ez a Pandas (és sok más adatelemző eszköz) belső, angol nyelvű paraméterneve, amit alapból (ha nem írod ki) True-ra állít (tehát alapértelmezés szerint növekvő sorrendbe rendez). Ha ascending=False-t adsz meg, ezt "kikapcsolod", ami csökkenő sorrendet eredményez. Mivel a Pandas (mint a legtöbb programozási könyvtár) angol nyelvű paraméterekkel dolgozik, érdemes megjegyezned néhány ilyen gyakori angol szót (ascending/descending, sort, filter), mert ezek állandóan visszatérnek majd más könyvtáraknál is.
8. Hiányzó adatok kezelése
df2 = pd.DataFrame({
    "nev": ["Anna", "Béla", "Csilla"],
    "kor": [25, None, 22]
})print(df2) print(df2.isna())
df_tisztitva = df2.dropna()
print(df_tisztitva)
df_kitoltve = df2.fillna(0)
print(df_kitoltve)
Miért olyan fontos ez a rész — mennyire gyakori a valóságban, hogy hiányzik egy adat? Extrém gyakori — a valós, éles adatokban (amikkel majd dolgozni fogsz, pl. egy webáruház vagy egy autókereskedés adatbázisával) szinte mindig lesznek hiányzó értékek: valaki elfelejtett kitölteni egy mezőt, egy szenzor nem küldött adatot egy adott napon, egy régi rendszerből importált adatnál hiányzik egy oszlop. Ha egy AI-modellnek hiányos adatot adsz (NaN értékkel), az legtöbbször hibát dobna vagy értelmetlen eredményt adna — ezért kritikus lépés minden valós AI-projektben, hogy először tisztítod az adatokat (vagy kidobod a hiányos sorokat — dropna(), vagy kitöltöd valamilyen ésszerű értékkel — fillna()), mielőtt egyáltalán elkezdenéd betanítani a modellt.
Mi az a NaN pontosan, ez egy szám? A NaN rövidítés jelentése: "Not a Number", azaz "nem szám" — ez egy speciális, beépített érték (hasonló a Python None- jához, amit a 7. leckében láttunk, de kifejezetten számokkal teli táblázatokhoz kifejlesztve), ami azt jelzi: "itt hiányzik az adat." fontos tudni, hogy a NaN "fertőző" — ha egy hiányzó (NaN) értékkel próbálsz számolni (pl. összeadni), az eredmény is NaN lesz, jelezve, hogy a számítás "megbízhatatlanná vált" a hiányzó adat miatt.
A df.isna().sum() megmutatja oszloponként, hány hiányzó (NaN) érték van a táblázatban — ez az egyik leggyakrabban használt első lépés egy új adathalmaz megvizsgálásakor, mielőtt eldöntenéd, dropna()-val kidobod vagy fillna()-val pótlod a hiányzó adatokat.
- Hozz létre egy DataFrame-et 5 autó adataival, majd írasd ki az átlagárat.
- Szűrd ki azokat az autókat, amik 2015-nél újabbak.
- Rendezd az autókat ár szerint, csökkenő sorrendbe.
- Mentsd el CSV fájlba (to_csv), majd olvasd vissza (read_csv), és ellenőrizd, hogy ugyanazt kapod-e vissza.
- Új gyakorlat: hozz létre egy DataFrame-et, amiben szándékosan van egy None érték egy szám-oszlopban, majd próbáld meg kiszámolni az átlagot (.mean()) anélkül, hogy előbb .dropna()-val vagy .fillna()-val kezelnéd — mit tapasztalsz? (Segítség: a Pandas .mean() valójában "okosabb", mint gondolnád — nézz utána, mit csinál alapból a hiányzó értékekkel, és gondold át, ez mindig a helyes viselkedés-e a te adataidnál.)
Források és további olvasnivaló
A lecke témájának hivatalos dokumentációi és alapvető cikkei:
• pandas — első lépések — pandas.pydata.org